
关于Sql Server的一些知识点的定义总结
数据库完整性:是指数据库中数据在逻辑上的一致性、正确性、有效性和相容性
实体完整性(Entity Integrity 行完整性):实体完整性指表中行的完整性。主要用于保证操作的数据(记录)非空、唯一且不重复。即实体完整性要求每个关系(表)有且仅有一个主键,每一个主键值必须唯一,而且不允许为“空”(NULL)或重复。
域完整性(Domain Integrity 列完整性):是指数据库表中的列必须满足某种特定的数据类型或约束。其中约束又包括取值范围、精度等规定。表中的CHECK、FOREIGN KEY 约束和DEFAULT、 NOT NULL定义都属于域完整性的范畴。
参照完整性(Referential Integrity)属于表间规则:对于永久关系的相关表,在更新、插入或删除记录时,如果只改其一,就会影响数据的完整性。如删除父表的某记录后,子表的相应记录未删除,致使这些记录称为孤立记录。
参照完整性规则(Referential Integrity)要求:若属性组F是关系模式R1的主键,同时F也是关系模式R2的外键,则在R2的关系中,F的取值只允许两种可能:空值或等于R1关系中某个主键值。
Sql Server的存储结构,页、区、堆
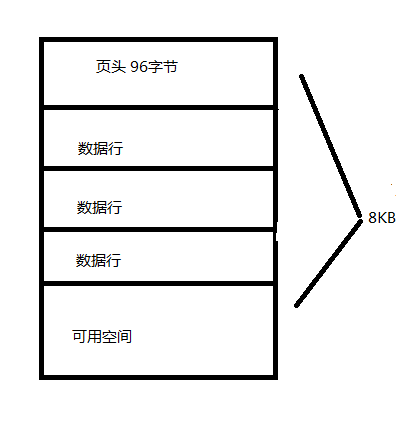
页:用于数据存储的连续的磁盘空间块,SQL Server中数据存储的基本单位是页,磁盘I/O操作在页级执行,页的大小为8KB。每页的开头是96字节的页头,用于存储有关页的系统信息,包括页码、页类型、页的可用空间以及拥有该页的对象的分配单元ID;其他便是存储数据的数据行与剩下可用空间,结构图如下(个人绘制)
区间:区是管理空间的基本单位,一个区是8个物理上连续的页(即64KB)的集合,所有页都存储在区中。SQL Server有两种类型的区:统一区和混合区。
堆:堆是指不含聚集索引的表,它的数据不按任何顺序进行存储。
联系一个堆中的数据的唯一结构是被称为索引分配映射(IAM)的一个位图页,当扫描对象时,SQl server使用IAM页来遍历该对象的数据。
堆表内的数据页和行没有任何特定的顺序,也不链接在一起。数据页之间唯一的逻辑连接是记录在 IAM 页内的信息
假设某订单明细表中有100万条数据,需要查询某个订单的明细数据,如下:
select * from T_EPZ_INOUT_ENTRY_DETAIL where entry_apply_id='31227000034000090169'
如果在堆表中进行查询,SQL Server通过扫描 IAM 页对堆表进行全表扫描,对entry_apply_id比较100万次,如果以entry_apply_id字段建立索引,则因为索引键值数据都必定以B-Tree有顺序的摆放,所以可采用二分查找找数据。也就是2的N次方大于记录数,就可以找到该条数据。而2的20次方大于100万,因此最多找寻20次就可以找到该条记录。20次与100万次的比较,你可以轻松感受出性能的差异。
由此引出索引的概念
索引分为聚集索引与非聚集索引
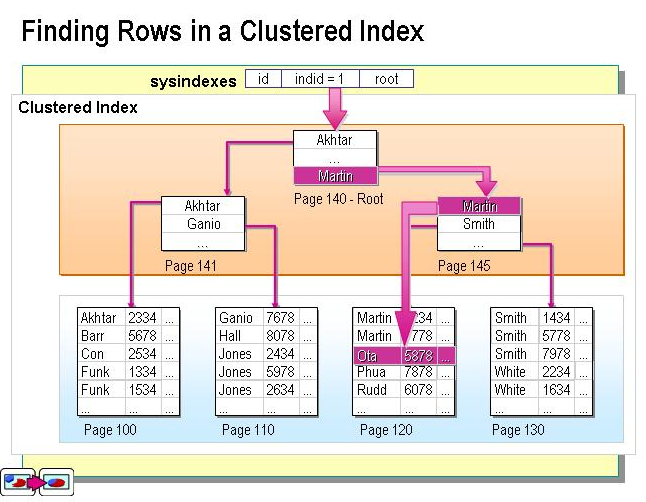
聚集索引 :聚集索引是指数据库表行中数据的物理顺序与键值的逻辑(索引)顺序相同。一个表只能有一个聚集索引,因为一个表的物理顺序只有一种情况,所以,对应的聚集索引只能有一个。如果某索引不是聚集索引,则表中的行物理顺序与索引顺序不匹配,与非聚集索引相比,聚集索引有着更快的检索速度
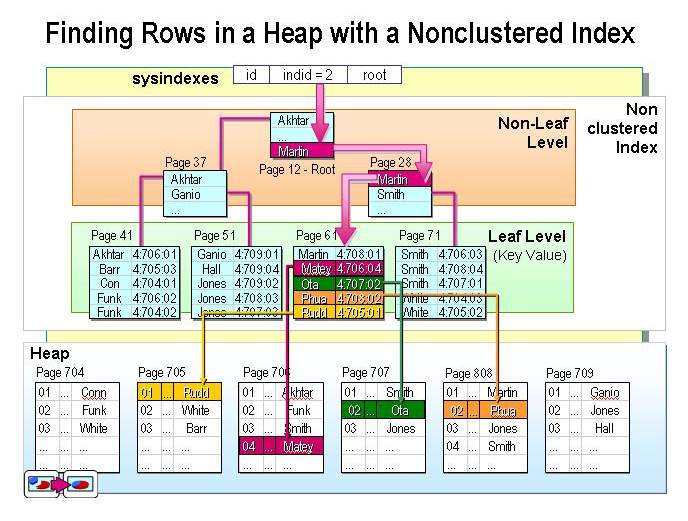
非聚集索引:非聚集索引是一种索引,该索引中索引的逻辑顺序与磁盘上行的物理存储顺序不同
聚集索引与非聚集索引的形象比喻
  dbcc showcontig(Tstudent,non_sname) --Tstudent表明,PK_TStudent索引名 ,查询页分裂情况

  dbcc indexdefrag(schoolDB,Tstudent,non_sname)--索引整理

  create nonclustered index non_sname on TStudent(sname) with drop_existing,fillfactor = 50--重建索引,并且制定填充因子

  dbcc show_statistics(tstudent,non_sname)--查看索引统计

  update statistics schooldb.dbo.tstudent --人工更新表中所有索引的统计

  update statistics schooldb.dbo.tstudent non_sname --人工更新表中non_sname索引统计
关于Sql Server的一些知识点的定义总结的更多相关文章
- sql server查询可编程对象定义的方式对比以及整合
本文目录列表: 1.sql server查看可编程对象定义的方式对比 2.整合实现所有可编程对象定义的查看功能的存储dbo.usp_helptext2 3.dbo.helptext2的选择性测试 4. ...
- SQL Server数据库的存储过程中定义的临时表,真的有必要显式删除临时表(drop table #tableName)吗?
本文出处:http://www.cnblogs.com/wy123/p/6704619.html 问题背景 在写SQL Server存储过程中,如果存储过程中定义了临时表,有些人习惯在存储过程结束的时 ...
- Sql Server数据库小知识点总结
把我在开发时候遇到的一点小知识持续更新在这里~ 1.where条件时常变 where UserID='1' 这里的UserID呢,它的值是经常在变化的,有时候要查2,有时候要查3的,有时候要查全部人! ...
- 调试SQL Server的存储过程及用户定义函数
分类: 数据库管理 2005-06-03 13:57 9837人阅读 评论(5) 收藏 举报 sql server存储vb.net服务器sql语言 1.在查询分析器中调试 查询分析器中调试的步骤如下: ...
- sql server 常用小知识点
1. sql server的语法:中文要加 N select * from eVA_EMPBoard where name = N'施纪平' 而oracle的不用 2.
- sql server DDL语句 建立数据库 定义表 修改字段等
一.数据库:1.建立数据库 create database 数据库名;use 数据库名; create database exp1;use exp1; mysql同样 2.删除数据库 drop dat ...
- 关于SQL server的一些知识点
关于怎么打开xp_cmdshell的方法: exec sp_configure 'show advanced option',1reconfiguregoexec sp_configure 'xp_c ...
- Sql server中根据object的定义查找object
SELECT OBJECT_NAME(object_id) FROM sys.sql_modulesWHERE definition LIKE '%keyword to search%' 或者 SEL ...
- SQL Server安全(6/11):执行上下文与代码签名(Execution Context and Code Signing)
在保密你的服务器和数据,防备当前复杂的攻击,SQL Server有你需要的一切.但在你能有效使用这些安全功能前,你需要理解你面对的威胁和一些基本的安全概念.这篇文章提供了基础,因此你可以对SQL Se ...
随机推荐
- spring BasicDataSource 数据源配置 sqlserver数据库 oracle数据库 mysql数据jdbc配置
spring BasicDataSource 数据源配置 sqlserver数据库 oracle数据库 mysql数据jdbc配置 jdbc.properties 文件信息如下: ---------- ...
- internal in C#
说白了 被 internal 修饰的东西只能在本程序集(当前项目)内被使用. 被 protected internal 修饰的属性/方法 可以在其他项目中,被派生类使用 例如有两个项目app1和app ...
- linux下编译make文件报错“/bin/bash^M: 坏的解释器,使用grep快速定位代码位置
一.linux下编译make文件报错“/bin/bash^M: 坏的解释器 参考文章:http://blog.csdn.net/liuqiyao_01/article/details/41542101 ...
- [iOS]深拷贝/浅拷贝区别
来点鸡汤: // 所谓拷贝 就是在原有的对象的基础上产生一个新的副本对象.有两点原则: // 1. 改变原对象的属性和行为不会影响副本对象 // 2. 改变副本对象的属性和行为不会影响原对象 ...
- .NET面试题系列(六)多线程
1.多线程的三个特性:原子性.可见性.有序性 原子性:是指一个操作是不可中断的.即使是多个线程一起执行的时候,一个操作一旦开始,就不会被其他线程干扰. 比如,对于一个静态全局变量int i,两个线程同 ...
- 关于Cookie跨域的问题
Cookie是一个伟大的发明,它允许Web开发者保留他们的用户的登录状态.但是当你的站点有一个以上的域名时就会出现问题了.在Cookie规范上说,一个cookie只能用于一个域名,不能够发给其它的域名 ...
- [python]文件操作read&readline&readlines
(1)read是将整个文件读入内存,将整个文件的内容当作一个字符串 (2)readline是一行一行的读如内存,每一次读的一行为一个字符串 (3)readlines是一次将整个文件读入内存,但是将整个 ...
- FPGA学习笔记. 二分频和三分频
二分频和三分频 二分频:将输入频率CLK分为原来的 1/2 . 实现:在每次CLK的上升沿或下降沿将输出翻转. 三分频: 1/3占空比. 实现:可使用上升沿或下降沿计数生成输出.需要一个两位计数器. ...
- ListView position
在使用listview的时候,我们经常会在listview的监听事件中,例如OnItemClickListener(onItemClick)中,或listview的adapter中(getView.g ...
- Hibernate延迟加载策略
所谓懒加载(lazy)就是延时加载,就是当在真正需要数据的时候,才真正执行数据加载操作 至于为什么要用懒加载呢,就是当我们要访问的数据量过大时,明显用缓存不太合适,因为内存容量有限 ,为了减少并发量, ...