
5.flume实战(二)
需求:监控一个文件实时采集新增的数据并输出到控制台
简单理解就是:监控一个文件,只要这个文件有新的内容追加,就将它输出到控制台。
agent技术选型:exec source + memory channel + logger sink
下面写配置文件:
# example.conf: A single-node Flume configuration
# Name the components on this agent
a1.sources = r1
a1.sinks = k1
a1.channels = c1
# Describe/configure the source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /usr/local/satori.txt
a1.sources.r1.shell = /bin/sh -c
a1.sources.r1.bind = localhost
a1.sources.r1.port = 44444
# Describe the sink
a1.sinks.k1.type = logger
# Use a channel which buffers events in memory
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
# Bind the source and sink to the channel
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
指定type为exec,然后添加一个command,我们输入tail -F file_path,表示跟踪文件,指定一个shell,可以看到配置文件改的不是很多,至于这里的参数exec,可以去flume官网上查看
新建一个配置文件,就叫exec-memory-logger.conf
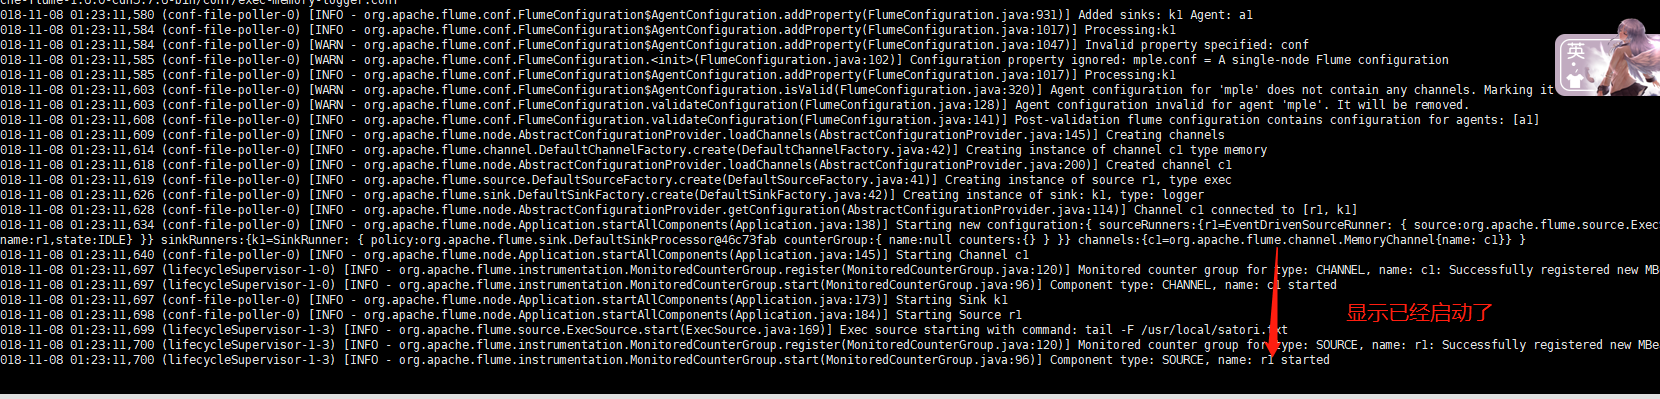
输入:flume-ng agent --name a1 --conf $FLUME_HOME/conf --conf-file $FLUME_HOME/conf/exec-memory-logger.conf -Dflume.root.logger=INFO,console
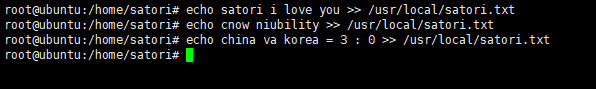
我们重定向一些内容到satori.conf里面去

可以看到,已经实施监控了
但我们目前都是输出到控制台上面,意义不大,我们也可以写到hdfs里面。
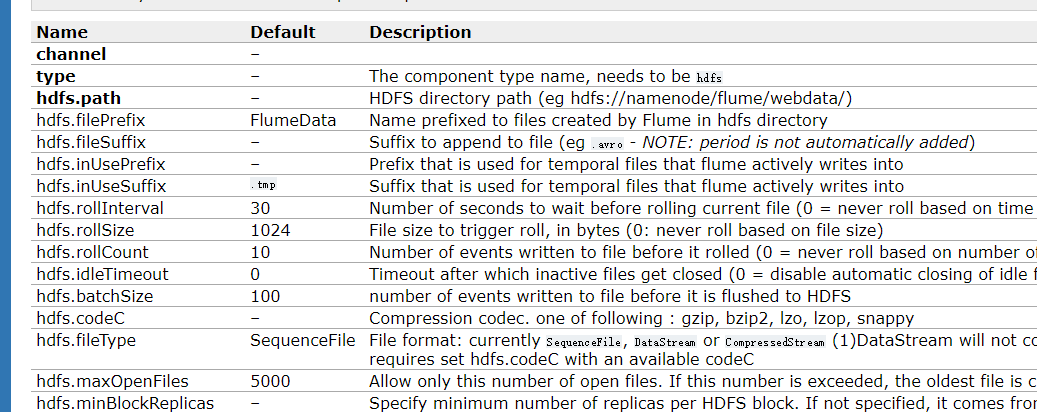
此时需要指定,type为hdfs,同时指定hdfs的路径,这个是离线处理的。
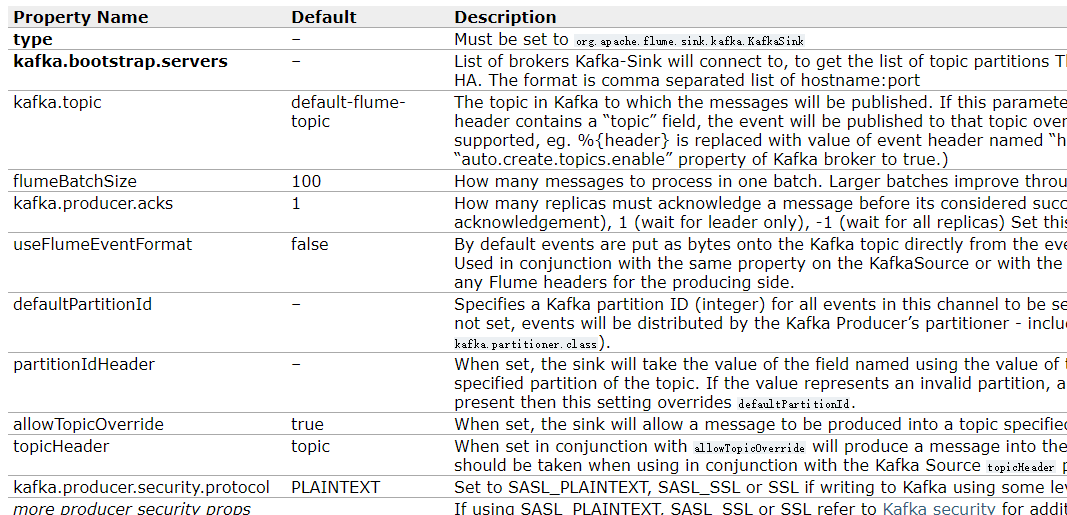
实时处理的话,需要到kafka
5.flume实战(二)的更多相关文章
- Flume系列二之案例实战
Flume案例实战 写在前面 通过前面一篇文章http://blog.csdn.net/liuge36/article/details/78589505的介绍我们已经知道flume到底是什么?flum ...
- Flume实战案例运维篇
Flume实战案例运维篇 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Flume概述 1>.什么是Flume Flume是一个分布式.可靠.高可用的海量日志聚合系统,支 ...
- Flume 实战练习
前期准备 了解Flume 架构及核心组件 Flume 架构及核心组件 Source : 收集(指定数据源从哪里获取) Channel : 聚集 Sink : 输出(把数据写到哪里去) 学习使用 Flu ...
- coreseek实战(二):windows下mysql数据源部分配置说明
coreseek实战(二):windows下mysql数据源部分配置说明 关于coreseek在windows使用mysql数据源的配置,以及中文分词的详细说明,请参考官方文档: mysql数据源配置 ...
- 【NFS项目实战二】NFS共享数据的时时同步推送备份
[NFS项目实战二]NFS共享数据的时时同步推送备份 标签(空格分隔): Linux服务搭建-陈思齐 ---本教学笔记是本人学习和工作生涯中的摘记整理而成,此为初稿(尚有诸多不完善之处),为原创作品, ...
- chrome调试工具高级不完整使用指南(实战二)
3.3 给页面添加测试脚本 在现实的工作中,我们往往会遇到一些问题在线上就会触发然后本地就触发不了的问题.或者是,要给某个元素写一个测试脚本.这个时候如果是浏览器有提供一个添加脚本的功能的话,那么我们 ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- 转 Python爬虫实战二之爬取百度贴吧帖子
静觅 » Python爬虫实战二之爬取百度贴吧帖子 大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 ...
- Netty 仿QQ聊天室 (实战二)
Netty 聊天器(百万级流量实战二):仿QQ客户端 疯狂创客圈 Java 分布式聊天室[ 亿级流量]实战系列之15 [博客园 总入口 ] 源码IDEA工程获取链接:Java 聊天室 实战 源码 写在 ...
- 第1节 flume:15、flume案例二,通过自定义拦截器实现数据的脱敏
1.7.flume案例二 案例需求: 在数据采集之后,通过flume的拦截器,实现不需要的数据过滤掉,并将指定的第一个字段进行加密,加密之后再往hdfs上面保存 原始数据与处理之后的数据对比 图一 ...
随机推荐
- [C/C++] new/delete和malloc/free基本区别
/**便于遗忘时复习**/ 区别一:本质 new/delete 在C++中是运算符不是函数,需要编译器支持.malloc/free是库函数,需要头文件支持,在C语言中使用. 区别二:开辟内存大小 用 ...
- 简单java采集程序一
[目标任务]通过该网站采集全国的手机号码段至数据库表中 [完成过程] 1.初涉正则表达式,学会写简单的正则表达式 2.获取单个网页内容,学会java中基本的IO流 3.将获取数据插入mysql数据库表 ...
- windows下 eclipse搭建spark java编译环境
环境: win10 jdk1.8 之前有在虚拟机或者集群上安装spark安装包的,解压到你想要放spark的本地目录下,比如我的目录就是D:\Hadoop\spark-1.6.0-bin-hadoop ...
- VFS dup ,dup2
Linux支持各种各样的文件系统格式,如ext2.ext3.reiserfs.FAT.NTFS.iso9660等等,不同的磁盘分区.光盘或其它存储设备都有不同的文件系统格式,然而这些文件系统都可以mo ...
- web四则运算
目录 1.coding.net地址 2.PSP 3.Information Hiding, Interface Design, Loose Coupling 4.计算模块接口的设计与实现过程 5.计算 ...
- linux系统基础文件属性
记录用户登录前显示的信息 cat /etc/issue vim /etc/motd 设置登录提醒 隐藏执行命令的历史记录用history –d 加上历史记录行号 如history -d 38 ...
- CSS设计指南之伪类
伪类这个叫法源自它们与类相似,但实际上并没有类会附加到标记中的标签上.伪类分两种. UI伪类会在HTML元素处于某个状态时(比如鼠标指针位于链接上),为该元素应用CSS样式. 结构化伪类会在标记中存在 ...
- DELPHI控件属性事件说明
常用DELPHI控件属性事件设置说明 常用DELPHI控件属性设置说明目录TForm Class TPanel组件 TToolBar Class TToolButton Class TTimer Cl ...
- Java IO 流 体系结构图
- 关于HTML中的object元素
<object>元素:它主要用于定义网页中的多媒体,比如音频,视频,Java applets,PDF,Active和Flash.object标签内除了param标签外,其他的内容将在浏览器 ...