
Lucene的中文分词器
1 什么是中文分词器
学过英文的都知道,英文是以单词为单位的,单词与单词之间以空格或者逗号句号隔开。
而中文的语义比较特殊,很难像英文那样,一个汉字一个汉字来划分。
所以需要一个能自动识别中文语义的分词器。
2. Lucene自带的中文分词器
StandardAnalyzer
单字分词:就是按照中文一个字一个字地进行分词。如:“我爱中国”,
效果:“我”、“爱”、“中”、“国”。
CJKAnalyzer
二分法分词:按两个字进行切分。如:“我是中国人”,效果:“我是”、“是中”、“中国”“国人”。
上边两个分词器无法满足对中文的需求。
3. 使用中文分词器IKAnalyzer
IKAnalyzer继承Lucene的Analyzer抽象类,使用IKAnalyzer和Lucene自带的分析器方法一样,将Analyzer测试代码改为IKAnalyzer测试中文分词效果。
如果使用中文分词器ik-analyzer,就在索引和搜索程序中使用一致的分词器ik-analyzer。
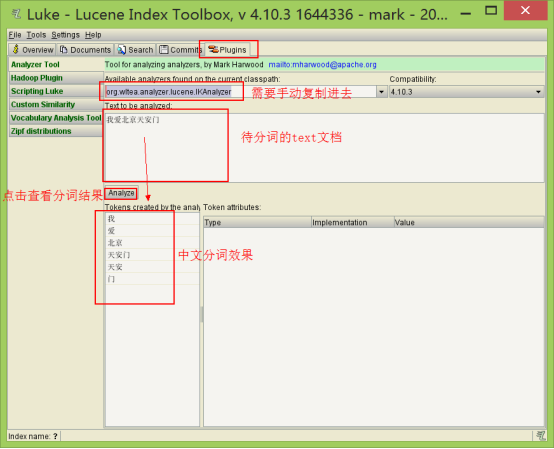
1. 使用luke测试IK中文分词
(1)打开Luke,不要指定Lucene目录。否则看不到效果
(2)在分词器栏,手动输入IkAnalyzer的全路径org.wltea.analyzer.lucene.IKAnalyzer
2. 改造代码,使用IkAnalyzer做分词器
添加jar包
修改分词器代码
|
// 创建中文分词器 Analyzer analyzer = new IKAnalyzer(); |
扩展中文词库
拓展词库的作用:在分词的过程中,保留定义的这些词
①在src或其他source目录下建立自己的拓展词库,mydict.dic文件,里面写入自定义的词
②在src或其他source目录下建立自己的停用词库,ext_stopword.dic文件停用词的作用:在分词的过程中,分词器会忽略这些词。
③在src或其他source目录下建立IKAnalyzer.cfg.xml,内容如下(注意路径对应):
|
<?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd"> <properties> <comment>IK Analyzer 扩展配置</comment> <!-- 用户可以在这里配置自己的扩展字典 --> <entry key="ext_dict">mydict.dic</entry> <!-- 用户可以在这里配置自己的扩展停用词字典 --> <entry key="ext_stopwords">ext_stopword.dic</entry> </properties> |
如果想配置扩展词和停用词,就创建扩展词的文件和停用词的文件,文件的编码要是utf-8。
注意:不要用记事本保存扩展词文件和停用词文件,那样的话,格式中是含有bom的。
Lucene的中文分词器的更多相关文章
- Lucene的中文分词器IKAnalyzer
分词器对英文的支持是非常好的. 一般分词经过的流程: 1)切分关键词 2)去除停用词 3)把英文单词转为小写 但是老外写的分词器对中文分词一般都是单字分词,分词的效果不好. 国人林良益写的IK Ana ...
- Lucene系列四:Lucene提供的分词器、IKAnalyze中文分词器集成、扩展 IKAnalyzer的停用词和新词
一.Lucene提供的分词器StandardAnalyzer和SmartChineseAnalyzer 1.新建一个测试Lucene提供的分词器的maven项目LuceneAnalyzer 2. 在p ...
- Lucene全文搜索之分词器:使用IK Analyzer中文分词器(修改IK Analyzer源码使其支持lucene5.5.x)
注意:基于lucene5.5.x版本 一.简单介绍下IK Analyzer IK Analyzer是linliangyi2007的作品,再此表示感谢,他的博客地址:http://linliangyi2 ...
- Lucene 03 - 什么是分词器 + 使用IK中文分词器
目录 1 分词器概述 1.1 分词器简介 1.2 分词器的使用 1.3 中文分词器 1.3.1 中文分词器简介 1.3.2 Lucene提供的中文分词器 1.3.3 第三方中文分词器 2 IK分词器的 ...
- (五)Lucene——中文分词器
1. 什么是中文分词器 对于英文,是安装空格.标点符号进行分词 对于中文,应该安装具体的词来分,中文分词就是将词,切分成一个个有意义的词. 比如:“我的中国人”,分词:我.的.中国.中国人.国人. 2 ...
- Lucene全文检索_分词_复杂搜索_中文分词器
1 Lucene简介 Lucene是apache下的一个开源的全文检索引擎工具包. 1.1 全文检索(Full-text Search) 1.1.1 定义 全文检索就是先分词创建索引,再执行搜索的过 ...
- 11大Java开源中文分词器的使用方法和分词效果对比,当前几个主要的Lucene中文分词器的比较
本文的目标有两个: 1.学会使用11大Java开源中文分词器 2.对比分析11大Java开源中文分词器的分词效果 本文给出了11大Java开源中文分词的使用方法以及分词结果对比代码,至于效果哪个好,那 ...
- Lucene索引库维护、搜索、中文分词器
删除索引(文档) 需求 某些图书不再出版销售了,我们需要从索引库中移除该图书. 1 @Test 2 public void deleteIndex() throws Exception { 3 // ...
- solr服务中集成IKAnalyzer中文分词器、集成dataimportHandler插件
昨天已经在Tomcat容器中成功的部署了solr全文检索引擎系统的服务:今天来分享一下solr服务在海量数据的网站中是如何实现数据的检索. 在solr服务中集成IKAnalyzer中文分词器的步骤: ...
随机推荐
- com.netflix.zuul.exception.ZuulException: Hystrix Readed time out
通过API网关路由来访问用户服务,zuul默认路由规则 :http://zuul的Host地址:zuul端口/要调用的服务名/服务方法地址 浏览器中打开http://127.0.0.1:8000/wa ...
- 所有eclipse版本,主题黑化,代码黑化的简单两步
一.下载两个文件 二.打开eclipse,Import .epf文件 三.把.jar 复制到 eclipse的plugins目录下,重启eclipse 效果如下: 注 以上方法:来自互联网
- HashMap源码分析(二)
前言:上篇文章,笔者分析了jdk1.7中HashMap的源码,这里将对jdk1.8的HashMap的源码进行分析. 注:jdk版本:jdk1.8.0_172 1.再看put操作 public V pu ...
- 逆向工程核心原理-IA-32寄存器
IA-32由四类寄存器组成:通用寄存器,段寄存器,程序状态与控制寄存器,指令指针寄存器. 通用寄存器:用于传送和暂存数据,也可参与算数逻辑运算,并保存运算结果. EAX(0-31) 32位 ...
- Redis之持久化(RDB AOF)
Redis 提供了 RDB 和 AOF 两种持久化方案: RDB:生成指定时间间隔内的 Redis 内存中数据快照,是一个二进制文件 dumpr.rdb AOF:记录 Redis 除了查询以外的所有写 ...
- Java队列学习
队列是Java集合中的重要组成部分,具有先进先出的特性,使其具有广泛的应用场景,比如排队等.因此今天就来学习一下Java中的队列.本文的例子使用的Java8环境. 继承类图 学习队列,首先要知道它的类 ...
- 极简Python DeBug工具——PySnooper
DeBug Python 代码的方式有很多种?比如: (1)设置断点 (2)print函数 (3)... 本文要介绍的是一个新开源的项目PySnooper ,只要给有疑问的代码加上装饰器,各种信息一目 ...
- 修改注册表信息来兼容当前WebBrower程序
public class WebBrower { /// <summary> /// 修改注册表信息来兼容当前程序 /// /// </summary> public stat ...
- let const var的区别与作用
今天第一次遇到const定义的变量,查阅了相关资料整理了这篇文章.主要内容是:js中三种定义变量的方式const, var, let的区别. 1.const定义的变量不可以修改,而且必须初始化. 1 ...
- hdu-1711(hash)
题意:给你T组数据,每组数据分别输入n,m和长度为n的数字数组,和长度为m的数字数组,问你长度为m的数组第一次出现在长度为n的数组的位置 解题思路:标准字符串匹配问题,一般用kmp解,拿来练hash ...