
solr查询优化【转】filtercache
solr查询优化(实践了一下效果比较明显)
什么是filtercache?
solr应用中为了提高查询速度有可以利用几种cache来优化查询速度,分别是fieldValueCache,queryResultCache,documentCache,filtercache,在日常使用中最为立竿见影,最有效的应属filtercache,何谓filtercache?这个需要从一段solr的查询日志开始说起,下面是我截取的solr运行中打印的一段查询日志:
[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=5,queryTime_is ==> 2

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A1+AND+class_id%3A1+AND+%28group_id%3A411%29&sort=gmt_create+desc&start=0&rows=20,queryTime_is ==> 2

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=5,queryTime_is ==> 2

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A1+AND+class_id%3A1+AND+%28group_id%3A8059%29&sort=gmt_create+desc&start=0&rows=20,queryTime_is ==> 0

[search4alive-0] Request_is ==> debugQuery=on&group=true&group.field=group_id&group.ngroups=true&group.sort=gmt_create+desc&q=status%3A0++AND+biz_type%3A1+AND+class_id%3A1+AND+ha

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=30&rows=30,queryTime_is ==> 4

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=5,queryTime_is ==> 1

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A1+AND+class_id%3A1+AND+%28group_id%3A375%29&sort=gmt_create+desc&start=0&rows=20,queryTime_is ==> 3

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=5,queryTime_is ==> 1

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=30,queryTime_is ==> 4

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=5,queryTime_is ==> 1

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=30,queryTime_is ==> 4

[search4alive-0] Request_is ==> q=status%3A0++AND+biz_type%3A2+AND+class_id%3A1&sort=index_sort_order+desc&start=0&rows=30,queryTime_is ==> 3
看到这段查询日志之后,我们开始考虑如何提升查询的rt(查询速度),因为在参数q中的查询是要有磁盘IO开销的,很自然的思路是将整个查询的参数q作为key,对应的结果作为value,这样做是可以的,但是查询的命中率会很低,会占用大量内存空间。
查询参数q上基本上每次都会出现status,biz_type,class_id 对于这样的字查询,所以可以把整个查询条件分成两部分一部分是以status,biz_type,class_id 这几个条件组成的子查询条件,另外一部分是除这三个条件之外的子查询。在进程查询的时候,先将status,biz_type,class_id 条件组成的条件作为key,对应的结果作为value进行缓存,然后再和另外一部分查询的结果进行求交运算。
 |
通过上面这幅图明白了filtercache的意义是,将原先一个普通查询分割成两个组合查询的与运算,两个子查询至少有一个使用缓存,这样既减少了查询过程的IO操作,又控制了缓存的容量不会消耗过多的内存。
如何使用?
首先要配置solrconfig.xml 要开启fltercache:
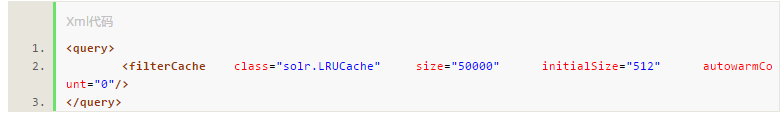
这里使用的是solr实现的基于LRU算法的缓实现,以上配置是使用solr.LRUCache ,使用这个cache在插入多,查询少的情况比较使用,如果是查询多,插入少的情况,可以使用solr.FastLRUCache缓存模块。
客户端API调用:
下面是原先的客户端端查询代码:

使用filterQuery之后的查询代码:
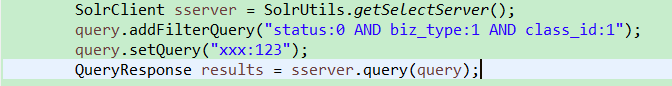
经过测试这样优化之后,查询的RT(查询速度)会明显减小,QPS(每秒查询率)会有明显提升。
使用filterquery过程中需要注意点:
●不能在filterQuery 上重复出现query中的查询参数,如果上面的filterquery调用方法如下所示:

如上,条件xxx:123 在filterQuery和query上都出现了,这样的写法非但起不到查询优化的目的,而且还会增加查询的性能开销。
●尽量减少调用addFilterQuery方法的次数
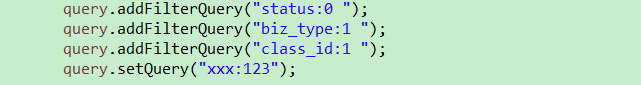
如上,将status:0 AND biz_type:1 AND class_id:1 这个组合查询条件,分三次调用filterQuery方法来完成,这样的调用方法虽然是正确的,并且能起到性能优化的效果,优化性能没有调用一次addFilterQuery方法来得高,原因是多调用了两次addFilterQuery,就意味着最后需要多进行两次结果集的求交运算,虽然结果集求交运算速度很快,但毕竟是有性能损耗的。
不过从内存开销的角度来说,调用三次addfilterQuery方法这样可以有效降低内存的使用量,这个是肯定的。所以在是否调用多次addFilterQuery方法的原则是,在内存开销允许的前提下,将量将所有filterQuery条件,通过调用有限次数的addFilterQuery方法来完成。
solr查询优化【转】filtercache的更多相关文章
- solr查询优化(实践了一下效果比较明显)
什么是filtercache? solr应用中为了提高查询速度有可以利用几种cache来优化查询速度,分别是fieldValueCache,queryResultCache,documentCache ...
- Solr 02 - 最详细的solrconfig.xml配置文件解读
目录 1 luceneMatchVersion - 指定Lucene版本 2 lib - 配置扩展jar包 3 dataDir - 索引数据路径 4 directoryFactory - 索引存储工厂 ...
- 【搜索引擎】Solr全文检索近实时查询优化
设置多个搜索建议查找算法 <searchComponent name="suggest" class="solr.SuggestComponent"> ...
- solr中Cache综述
一.概述 Solr查询的核心类就是SolrIndexSearcher,每个core通常在同一时刻只由当前的SolrIndexSearcher供上层的handler使用(当切换SolrIndexSear ...
- [Erlang 0104] 当Erlang遇到Solr
Joe Armstrong的访谈中有一段关于"打开黑盒子"的阐述,给我留下很深的印象:Joe Armstrong在做XWindows开发时没有使用对应的类库,而是在了解XW ...
- Solr入门之(6)配置文件solrconfig.xml
solrconfig.xml包含了用于配置自身行为的绝大部分参数,其作用范围是当前core.该文件位于${solr_home}/solr/core1/conf/下. 参数列表概览: A.lib B.d ...
- Solr Cloud搭建
1:搭建tomcat 配置connector: server.xm文件中: <Connector port="8080"maxThreads="200" ...
- Solr调研总结
http://wiki.apache.org/solr/ Solr调研总结 开发类型 全文检索相关开发 Solr版本 4.2 文件内容 本文介绍solr的功能使用及相关注意事项;主要包括以下内容:环境 ...
- solr性能调优
Schema Design Considerations indexed fields indexed fields 的数量将会影响以下的一些性能: 索引时的时候的内存使用量 索引段的合并时间 优化时 ...
随机推荐
- CarbonData
CarbonData http://carbondata.apache.org/ Apache顶级项目CarbonData应用实践与2.0新技术规划介绍_搜狐科技_搜狐网 https://www.so ...
- 使用Java绘制验证码
效果图: JDemo.java import java.io.File; import java.io.IOException; import static java.lang.System.out; ...
- poj 2559 Largest Rectangle in a Histogram 栈
// poj 2559 Largest Rectangle in a Histogram 栈 // // n个矩形排在一块,不同的高度,让你求最大的矩形的面积(矩形紧挨在一起) // // 这道题用的 ...
- POJ1144 Network 无向图割点
题目大意:求以无向图割点. 定义:在一个连通图中,如果把点v去掉,该连通图便分成了几个部分,则v是该连通图的割点. 求法:如果v是割点,如果u不是根节点,则u后接的边中存在割边(u,v),或者v-&g ...
- 通过mysqldumpslow来分析日志
通过mysqldumpslow来分析日志. 将mysql加入到全局变量中!!! sudo vim /etc/profile # 添加Mysql export PATH=$PATH:/usr/local ...
- JavaScript函数调用规则
1. [代码][JavaScript]代码 JavaScript函数调用规则一 (1)全局函数调用:function makeArray( arg1, arg2 ){ return [t ...
- hdu 2544 最短路 解题报告
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=2544 题目意思:给出 n 个路口和 m 条路,每一条路需要 c 分钟走过.问从路口 1 到路口 n 需 ...
- [Selenium] Selenium 疑难杂症
1. jsclick 也不管用 Actions action = new Actions(driver); WebElement theRow = page.getInvisibleElement() ...
- 「LuoguP1627 / T36198」 [CQOI2009]中位数
Description 给出1~n的一个排列,统计该排列有多少个长度为奇数的连续子序列的中位数是b.中位数是指把所有元素从小到大排列后,位于中间的数. Input 第一行为两个正整数n和b,第二行为1 ...
- AJAX --- 一种创建交互式网页应用的网页开发技术
目录 AJAX 创建XHR实例 指定readyStatechange事件处理程序 启动请求 发送请求 接收数据 取消XHR请求/响应 AJAX ajax核心技术就是 XMLHttpRequest 对象 ...