
数据挖掘 | 数据隐私(4) | 差分隐私 | 差分隐私概论(下)(Intro to Differential Privacy 2)
L4-Intro to Differential Privacy
拉普拉斯机制(Laplace Mechanism)
上一节课中,我们讨论了随机响应,这是一种适合于单个位的隐私化。这种算法一般来说并不直接也误差较大。今日所关注的是拉普拉斯机制,可以直接应用于任意一种类型的数字查询。在引入拉普拉斯机制,首先提出一个概念:函数敏感度(sensitivity),一般特指L1敏感度(即基于L1范数的敏感度),定义如下:
定义1
使\(f:\mathcal{X}^n\rightarrow\mathbb{R} ^k\),那么\(f\)的\(\mathcal{l_1}\)-敏感度为:
\]
其中\(X\)和\(X'\)为邻近数据集
后面丢掉\(f\),只使用\(\Delta\)以表示\(\mathcal{l_1}\)-敏感度。
敏感度用于衡量差分隐私的内容是合适而自然的,正因为差分隐私试图掩盖一个个个体的具体分布差距,通过这一敏感度作为上界,就可以衡量该函数应该会发生多大的改变。值得注意的是,我们用的是\(\mathcal{l_1}\)-敏感度,而非\(\mathcal{l_2}\)-敏感度,但是在其他分布例如说高斯机制中会使用。举个例子:\(f=\frac{1}{n}\sum^n_{i=1}X_i \ \ X_i\in\{0,1\}\),很容易算出敏感度为\(1/n\),因为只有一个位被翻转。
定义2
对于位置与规模参数分别为\(0\)与\(b\)的拉普拉斯分布,如下定义其密度函数:
\]
注意到拉普拉斯分布的方差为\(2b^2\)。
如下图所示,拉普拉斯分布本质是两个对称的指数分布,在\(x\in [0,\infty)\)存在正比于\(exp(-cx)\)的密度函数,而拉普拉斯分布则是在\(x\in \mathbb{R}\)存在正比于\(\exp(-c|x|)\)的密度函数。另外高斯分布的尾部要比拉普拉斯分布的稍轻一点,换句话来说就是高斯分布的中心化程度更高。
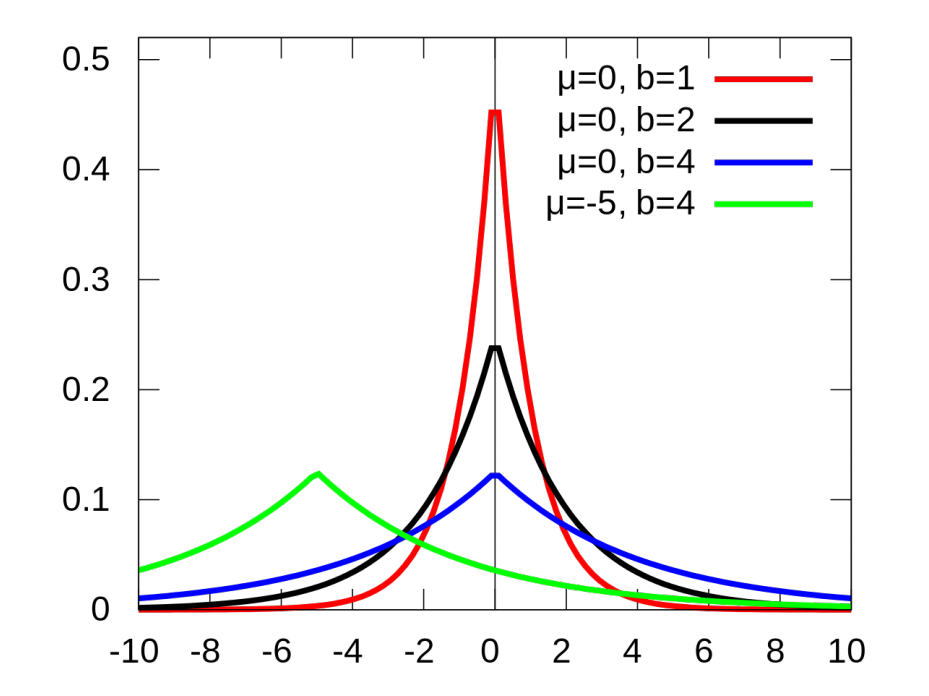
介绍了拉普拉斯分布之后,就可以引入拉普拉斯机制这一概念,原理非常简单:即是按照数据敏感度的程度添加噪音。
定义3
使\(f:\mathcal{X}^n\rightarrow \mathbb{R} ^k\),那么拉普拉斯机制即是
\]
其中\(Y_i\)是独立的拉普拉斯分布,\(Laplace(\Delta/\epsilon)\)的随机变量。
由此我们就可以将其应用于例子中的\(f=\frac{1}{n}\sum^n_{i=1}X_i\),并且\(k=1\)。那么\(\Delta = 1/n\)。为此,对其施加拉普拉机制之后得到\(\tilde p=f(X)+Y\),其中\(Y\)为\(Laplace(1/(\epsilon n))\)。由定义可知,\(\mathbf{E}[\tilde p]=p\),\(\mathbf{Var}[\tilde p]=\mathbf{Var}[Y]=O(1/(\epsilon^2 n^2))\),然后通过切比雪夫不等式就可以得到合理概率界限。对比于\(\epsilon\)-随机响应的精确度\(O(1/(\epsilon\sqrt n))\),可见拉普拉斯机制是二次的,小于\(\epsilon\)-随机响应。
定理4
拉普拉斯机制乃是\(\epsilon\)-差分隐私
证明:假若\(X\)与\(Y\)为一对邻近数据集,存在一个数据条目不一致。使得\(p_X(z)\)与\(p_Y(z)\)为点\(z\in\mathbb{R}^k\)的概率密度函数\(M(X)\)与\(M(Y)\)。为此我们需要证明其上界为\(\exp(\epsilon)\),那么对于任意一个\(X\)与\(Y\)的\(z\)
\frac{p_X(z)}{p_Y(z)} & = \frac{\prod^k_{i=1}\exp(-\frac{\epsilon|f(X)_i-z_i|}{\Delta})}
{\prod^k_{i=1}\exp(-\frac{\epsilon|f(Y)_i-z_i|}{\Delta})} \\
& = \prod^k_{i=1}\exp(-\frac{\epsilon(|f(X)_i-z_i|-|f(X)_i-z_i|)}{\Delta}) \\
& \le \prod^k_{i=1}\exp(-\frac{\epsilon|f(X)_i-f(X)_i|}{\Delta}) \\
& = \exp(\frac{\epsilon\sum^k_{i=1}|f(X)_i-f(X)_i|}{\Delta}) \\
& = \exp(\frac{\epsilon||f(X)-f(X)||_1}{\Delta}) \\
& \le \exp(\epsilon)
\end{align}
\]
首先应用三角不等式,然后应用\(\mathcal{l_1}\)-敏感度的定义。
计数查询(Counting Queries)
现在要讨论计数查询的情况了,计数查询也能用非标准化版本的差分隐私来称呼。
首先假若每个个体都拥有一个隐私为\(X_i\in\{0,1\}\),其中定义\(f\)为最终他们的求和。那么敏感度为\(1\),经过\(\epsilon\)-差分隐私的数据就是\(f(X)+\text{Laplace}(1/\epsilon)\)。其误差则为\(O(1/\epsilon)\),独立于数据集的规模。
现在我们考虑多次查询。假若我们拥有\(k\)次查询\(f=(f_1,\dots,f_k)\),都是提前指定好的。最后就会输出一个向量\(f(X) + Y\),其中\(Y_i\)都符合i.i.d条件的拉普拉斯随机变量。现在我们再考虑这个分布的规模系数。对于每个具体的查询\(f_j\)都拥有敏感度 \(1\),但是又要考虑所有查询都是基于一个数据集,也就是说单个查询的改变会影响到多种查询组合。例如说,交换两个个体,二者的位是相反的,那么所有查询都会改变\(1\),因此最终的\(\mathcal{l_1}\)-敏感度为\(k\)。我们再采用数学的方法进行证明:由于\(f(X)=\sum(f_1(X_i\dots,f_k(X_i))\),而临近数据集\(X\)与\(Y\)之间差别在于\(x\)与\(y\),为此\(\mathcal{l_1}\)差分为\(\sum_j|f_j(x)-f_j(y)|\),然后上界可以算出来得到\(\sum_j|f_j(x)-f_j(y)|\le \sum_j 1=k\)。
算出来其敏感度上界\(\Delta=1\),也就得到了噪音\(Y_i\sim\text{Laplace}(k/\epsilon)\),然后添加到每个坐标分量上面,每次计数查询都带上了总规模为\(O(k/\epsilon)\)的误差。
有些地方还是必须注意:第一点,这种处理\(k\)计数查询的方法只适用于提前指定好的查询,也就是说非适应性的查询。第二点,对于 Dinur-Nissim攻击,其中数据分析器进行\(\Omega(n)\)次技术查询,那么管理器带了总量为\(O(\sqrt n)\)的噪音,那么数据分析器
就能重构数据集并且使得其符合\(BNP\)性。而完美采用的策略使得数据分析器查询\(O(n)\)时,加入了\(O(n/\epsilon)\)的噪音,成功保护了隐私。今后还要讨论如何面对更为强大的攻击,以及如何在减少噪音的情况下隐私性不变。
直方图(Histograms)
这里提出一种新的查询方法为直方图查询(histogram query),相比于比较悲观的计数查询(因为计数查询一个改变会影响整个结果),某些特定的数据结构可以让我们的数据查询得到更好的敏感度。这里我们举个带有明确特征的例子:例如说人的年龄(注意是通过向下取整得到离散的数值)。其实类似于计数查询,每个人都只有一个年龄,而我们的查询具体就是“有多少个人其年龄为\(X\)”。函数\(f\)定义为\((f_0,f_1,\dots,f_{k-1})\),其中\(k_i\)就是查询有多少人为\(i\)岁,显然这个函数的\(\mathcal{l_1}\)-敏感度为\(2\),因为改变其中一个人的岁数会导致一个年龄桶总数的下降,另一个年龄桶总数的上升。基于上述内容,拉普拉斯机制的处理方法即是输出\(f(X)+Y\),其中\(Y_i\sim\text{Laplace}(2/\epsilon)\),最终加入的噪音总量则为桶的总量\(k\)
公理5.
对于\(Y\sim\text{Laplace}(b)\),有:
\]
那么对于第\(i\)个桶,其误差显而易见为\(Y_i\)并且符合\(\mathbf{Pr}[|Y_i|\ge2\log(k/\beta)/\epsilon]\le\beta/k\),可以证得对于任意一个桶都有误差\(\ge2\log(k/\beta)/\epsilon\)对于大多数\(\beta\)的取值。换一种说法来说,就是直方图查询的误差是对数复杂度,而计数查询为线性复杂度的误差。
差分隐私的性质(Properties of Differential Privacy)
后处理性(Post-Processing)
只要数据不再被使用,那么经过隐私化的数据将不能再被去隐私化。
定理6.
使\(M:X^n\rightarrow Y\)为\(\epsilon\)-DP算法,以及\(F:Y\rightarrow Z\)为一个随机映射。那么对于\(F\cdot M\)也是\(\epsilon\)-DP。
证明:
\mathbf{Pr}[F(M(X))\in T] & = \mathbf{E}_{f\sim F}[\mathbf{Pr}[M(X)\in f^{-1}(M)]] \\
& \le\mathbf{E}_{f\sim F}[e^{\epsilon}\mathbf{Pr}[M(X')\in f^{-1}(M)]] \\
& = e^{\epsilon}\mathbf{Pr}[F(M(X'))\in T]
\end{align}
\]
群组隐私(Group Privacy)
定理7.
使\(M:X^n\rightarrow Y\)为\(\epsilon\)-DP算法。其中\(X\)与\(X'\)为在\(k\)个位置不一致的邻近数据集。那么对于所有\(T\subseteq Y\),满足:
\mathbf{Pr}[M(X)\in T] & \le \exp(k\epsilon)\mathbf{Pr}[M(X')\in T]
\end{align}
\]
证明:先使\(X^{(0)}=X\),\(X^{(k)}=X'\),其中二者在\(k\)位置存在差异。那么存在一系列从\(X^{(0)}\)到\(X^{(k)}\)的连续邻近数据集对。那么对于所有\(T\subseteq Y\),满足:
\mathbf{Pr}[M(X^{(0)})\in T] & \le e^\epsilon \mathbf{Pr}[M(X^{(1)})\in T] \\
& \le e^{2\epsilon} \mathbf{Pr}[M(X^{(2)})\in T] \\
& \cdots\\
& \le e^{k\epsilon} \mathbf{Pr}[M(X^{(k)})\in T] \\
\end{align}
\]
基本组合性( (Basic) Composition )
对于\(M=(M_1,\dots,M_k)\),为一系列\(k\)个\(\epsilon\)-DP算法,其输出为\(y=(y_1,\dots,y_k)\),那么满足:
\frac{\mathbf{Pr}[M(X)=y]}{\mathbf{Pr}[M(X')=y]} & =
\prod^k_{i=1}\frac{\mathbf{Pr}[M_i(X)=y_i|(M_1(X),\dots,M_{i-1}(X))=(y_1,\dots,y_k)]}
{\mathbf{Pr}[M_i(X')=y_i|(M_1(X'),\dots,M_{i-1}(X'))=(y_1,\dots,y_k)]} \\
& \le \prod^k_{i=1} \exp(\epsilon) \\
& = \exp(k\epsilon)
\end{align}
\]
数据挖掘 | 数据隐私(4) | 差分隐私 | 差分隐私概论(下)(Intro to Differential Privacy 2)的更多相关文章
- 差分隐私(Differential Privacy)定义及其理解
1 前置知识 本部分只对相关概念做服务于差分隐私介绍的简单介绍,并非细致全面的介绍. 1.1 随机化算法 随机化算法指,对于特定输入,该算法的输出不是固定值,而是服从某一分布. 单纯形(simplex ...
- Mac Mail PGP Setup 如何在苹果电脑上设置安全邮件 良好隐私密码法(英语:Pretty Good Privacy,缩写为PGP)
背景知识 良好隐私密码法(英语:Pretty Good Privacy,缩写为PGP),一套用于讯息加密.验证的应用程序,采用IDEA的散列算法作为加密与验证之用. 关联文献:https://en.w ...
- 洛谷5026 Lycanthropy 差分套差分
题目链接 https://www.luogu.com.cn/problem/P5026 题意 在一个长度为m的序列中,每次给一个下标x,和一个权值v,然后从x-v*3到x-v*2单调递增,从x-v*2 ...
- 【Luogu】P4231三步必杀(差分,差分)
题目链接 郑重宣布我以后真的再也不会信样例了,三种写法都能过 另:谁评的蓝题难度qwq 蓝题有这么恐怖吗 两次差分,第一次差分,前缀和求出增量数组,第二次求出原数组顺便更新答案 看题解之后……第二次差 ...
- P2680 [NOIP2015 提高组] 运输计划 (树上差分-边差分)
P2680 题目的大意就是走完m条路径所需要的最短时间(边权是时间), 其中我们可以把一条边的权值变成0(也就是题目所说的虫洞). 可以考虑二分答案x,找到一条边,使得所有大于x的路径都经过这条边(差 ...
- 树上差分——点差分裸题 P3128 [USACO15DEC]最大流Max Flow
讲解: https://rpdreamer.blog.luogu.org/ci-fen-and-shu-shang-ci-fen #include <bits/stdc++.h> #def ...
- HDU1529-Casher Emploryment(最最...最经典的差分约束 差分约束-最长路+将环变线)
A supermarket in Tehran is open 24 hours a day every day and needs a number of cashiers to fit its n ...
- [Python数据挖掘]第5章、挖掘建模(下)
四.关联规则 Apriori算法代码(被调函数部分没怎么看懂) from __future__ import print_function import pandas as pd #自定义连接函数,用 ...
- Certified Robustness to Adversarial Examples with Differential Privacy
目录 概 主要内容 Differential Privacy insensitivity Lemma1 Proposition1 如何令网络为-DP in practice Lecuyer M, At ...
- MindArmour差分隐私
MindArmour差分隐私 总体设计 MindArmour的Differential-Privacy模块,实现了差分隐私训练的能力.模型的训练主要由构建训练数据集.计算损失.计算梯度以及更新模型参数 ...
随机推荐
- 使用 Web Compiler 2022+
使用 Web Compiler 2022+ Web Compiler 2022+ for Visual Studio 2022 Web Compiler for Visual Studio 2019 ...
- 【分享】记一次项目迁移(docker java | docker python)
项目:前端Vue3,后端Python+Java,数据库Redis+MySQL 原先部署在centos7里面的,使用的宝塔面板部署的,还算方便. 但是服务器要到期了,要将项目迁移到另外一台服务器. 另外 ...
- 【报错解决】【Linux】Name or service not known
# 配置文件位置 /etc/sysconfig/network-scripts/ # nano ifcfg-eth0查看网卡配置,确认dns已配置,且网关已配置 在虚拟机中添加临时路由网关(要与物理主 ...
- office文件所对应的的 Content-type类型总结
最近做文件下载因为涉及到不同类型的文件,所以重新查阅了一下文件所对应的的content-type类型,好记性不如烂笔头,记录一下. 文件后缀 MIME TYPE .doc application/ms ...
- 夜莺 v8 第一个版本来了,开始做有意思的功能了
夜莺 v8 大版本已经启动开发,预计 25 年 7.8 月份发正式版,相比 v7 大概会做四五个大功能,每个功能做完了做稳定了都会提前放出来供大家体验,虽然以 beta 来命名,实际是稳定的,大家可以 ...
- Qt/C++音视频开发56-udp推流和拉流/组播和单播推流
一.前言 之前已经实现了rtsp/rtmp推流,rtsp/rtmp/hls/flv/ws-flv/webrtc等拉流,这种一般都需要依赖一个独立的流媒体服务程序,有没有一种更便捷的方式不需要这种依赖, ...
- Qt音视频开发35-Onvif图片参数
一.前言 视频中的图片的配置参数一般有亮度.饱和度.对比度.锐度等,以前一直以为这些需要通过厂家的私有协议SDK来设置才行,后面通过研究Onvif Device Manager 和 Onvif Dev ...
- MySQL数据库驱动mysql-connector-java与数据库版本的匹配
jar包的下载地址:https://dev.mysql.com/downloads/file/?id=477058 之前我的MySQL数据库驱动mysql-connector-java版本号为5.1. ...
- OpenMMLab AI实战营 第五课笔记
OpenMMLab AI实战营 第五课笔记 目录 OpenMMLab AI实战营 第五课笔记 在气球数据集上训练检测模型 进入 mmdetection 主目录 下载并观察气球数据集 下载训练好的mas ...
- Python 安装package 问题汇总
1. pip 命令使用国内源安装 pip install torch==1.8.1 -i https://mirrors.aliyun.com/pypi/simple/腾讯云: https://mir ...