
Python数据分析与爬虫
数据分析重要步骤:
1.数据获取
可以进行人工收集获取部分重要数据
可以在各个数据库中导出数据
使用Python的爬虫等技术
2.数据整理
从数据库、文件中提取数据,生成DataFrame对象
采用pandas库读取文件
3.数据处理
数据准备:
对DataFrame对象(多个)进行组装、合并等操作
pandas操作
数据转化:
类型转化、分类(面元等)、异常值检测、过滤等
pandas库的操作
数据聚合:
分组(分类)、函数处理、合并成新的对象
pandas库的操作
4.数据可视化
将pandas的数据结构转化为图表的形式
matplotlib库
5.预测模型的创建和评估
数据挖掘的各种算法:
关联规则挖掘、回归分析、聚类、分类、时序挖掘、序列模式挖掘等
6.部署(得出结果)
从模型和评估中获得知识
知识的表示形式:规则、决策树、知识基、网络权值
原网址:https://blog.csdn.net/qq_35187510/article/details/80078143
爬取网页数据步骤:
简介:
(1)网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者):
是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。其实通俗的讲就是通过程序去获取web页面上自己想要的数据,也就是自动抓取数据。
(2)爬虫可以做什么?
你可以用爬虫爬图片,爬取视频等等你想要爬取的数据,只要你能通过浏览器访问的数据都可以通过爬虫获取。当你在浏览器中输入地址后,经过DNS服务器找到服务器主机,向服务器发送一个请求,服务器经过解析后发送给用户浏览器结果,包括html,js,css等文件内容,浏览器解析出来最后呈现给用户在浏览器上看到的结果
所以用户看到的浏览器的结果就是由HTML代码构成的,我们爬虫就是为了获取这些内容,通过分析和过滤html代码,从中获取我们想要资源。
页面获取
1.根据URL获取网页
- URL处理模块(库)
import urllib.request as req - 创建一个表示远程url的类文件对象
req.urlopen(' ') - 如同本地文件一样读取内容
import urllib.request as req

# 根据URL获取网页:

#http://www.hbnu.edu.cn/湖北师范大学

url = 'http://www.hbnu.edu.cn/'

webpage = req.urlopen(url) # 按照类文件的方式打开网页

# 读取网页的所有数据,并转换为uft-8编码

data = webpage.read().decode('utf-8')

print(data)
2.网页数据存入文件
#将网页爬取内容写入文件

import urllib.request

url = "http://www.hbnu.edu.cn/"

responces = urllib.request.urlopen(url)

html = responces.read()

html = html.decode('utf-8')

fileOb = open('C://Users//ALICE//Documents//a.txt','w',encoding='utf-8')

fileOb.write(html)

fileOb.close()
此时我们从网页中获取的数据已保存在我们指定的文件里,如下图所示:
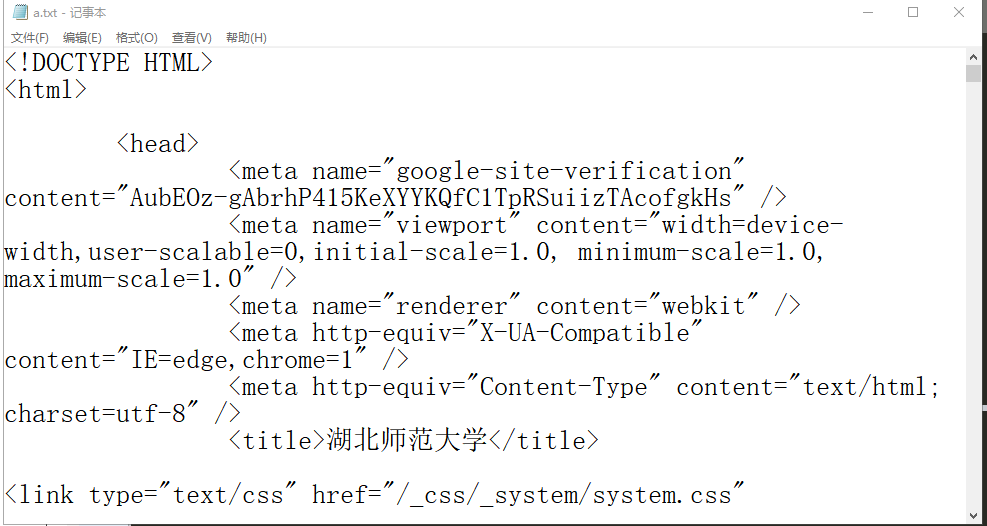
网页获取
从图中可以看出,网页的所有数据都存到了本地,但是我们需要的数据大部分都是文字或者数字信息,而代码对我们来说并没有用处。那么我们接下来要做的是清除没用的数据。
之后需要数据清洗,接下来的请听下回分解。
Python数据分析与爬虫的更多相关文章
- Python爬虫与数据分析之爬虫技能:urlib库、xpath选择器、正则表达式
专栏目录: Python爬虫与数据分析之python教学视频.python源码分享,python Python爬虫与数据分析之基础教程:Python的语法.字典.元组.列表 Python爬虫与数据分析 ...
- 零基础学习Python web开发、Python爬虫、Python数据分析,从基础到项目实战!
随着大数据和人工智能的发展,目前Python语言的上升趋势比较明显,而且由于Python语言简单易学,所以不少初学者往往也会选择Python作为入门语言. Python语言目前是IT行业内应用最为广泛 ...
- 【Python数据分析】Python3多线程并发网络爬虫-以豆瓣图书Top250为例
基于上两篇文章的工作 [Python数据分析]Python3操作Excel-以豆瓣图书Top250为例 [Python数据分析]Python3操作Excel(二) 一些问题的解决与优化 已经正确地实现 ...
- Python即时网络爬虫项目启动说明
作为酷爱编程的老程序员,实在按耐不下这个冲动,Python真的是太火了,不断撩拨我的心. 我是对Python存有戒备之心的,想当年我基于Drupal做的系统,使用php语言,当语言升级了,推翻了老版本 ...
- Python即时网络爬虫:API说明
API说明——下载gsExtractor内容提取器 1,接口名称 下载内容提取器 2,接口说明 如果您想编写一个网络爬虫程序,您会发现大部分时间耗费在调测网页内容提取规则上,不讲正则表达式的语法如何怪 ...
- 【读书笔记与思考】《python数据分析与挖掘实战》-张良均
[读书笔记与思考]<python数据分析与挖掘实战>-张良均 最近看一些机器学习相关书籍,主要是为了拓宽视野.在阅读这本书前最吸引我的地方是实战篇,我通读全书后给我印象最深的还是实战篇.基 ...
- 手把手教你从零搭建Python数据分析环境
由于最近再做推荐系统的特征处理,需要借助一些工具来筛选特征.最初使用了R,R的安装很简单,而且API也很容易使用,直接就能出图.后来,发现很多人在python和R之间做选择,所以我也在两个工具间摇摆不 ...
- 零基础学习Python数据分析
网上虽然有很多Python学习的教程,但是大多是围绕Python网页开发等展开.数据分析所需要的Python技能和网页开发等差别非常大,本人就是浪费了很多时间来看这些博客.书籍.所以就有了本文,希望能 ...
- 【python数据分析实战】电影票房数据分析(一)数据采集
目录 1.获取url 2.开始采集 3.存入mysql 本文是爬虫及可视化的练习项目,目标是爬取猫眼票房的全部数据并做可视化分析. 1.获取url 我们先打开猫眼票房http://piaofang.m ...
随机推荐
- Git仓库迁移命令
1. 从原git上clone bare下到本地 git clone --bare https://***.git 2. push mirror到目标仓库 git push --mirror https ...
- 用 Raspberry Pi 架设加密 DNS 客户端
Cloudflare 宣布使用 1.1.1.1 作为 DNS,并且强调隐私保护.由于 Cloudflare DNS 支持 DNS-over-TLS 和 DNS-over-HTTPS,这使得加密 DNS ...
- 物联网架构成长之路(36)-Vue前端入门
1. 前言 物联网平台,需要有一个类似大屏看板的功能. 找了一圈,发现阿里已经有对应的DataV产品,但是那个价格有点贵啊.所以找了这个[http://datav.jiaminghi.com/demo ...
- 微软官方 Github 上的 EF 示例项目 EntityFramework.Docs
项目地址:https://github.com/aspnet/EntityFramework.Docs/tree/master/samples/core 谢谢浏览!
- Wine添加路径PATH办法
使用wine运行某些程序时,可能会提示某些DLL找不到,需要手动把这些DLL的路径添加进去.添加方法是:wine regedit打开注册表工具:添加一个键HKEY_CURRENT_USER/Envir ...
- @property与@xxx.setter的用法
类中@property与@xxx.setter的方法介绍. 简单说,@property就是将定义的函数(方法)当作属性对象使用,不需要像调用函数那样去调用,而@xxx.setter是为@xxx的这样函 ...
- Map-HashMap-遍历
第一种遍历方法 : 先获取Map中的所有key值,然后根据key,依次从Map中去数据 (针对只取 Key 或者 Value 的情况) Map<String, String> hashMa ...
- java--Proreties
Prorerties /* * Properties,内存与文件信息交互 * 表示了一个持久的属性集 * * 构造方法: * Properties() * * */ //简单使用 创建,添加,遍历, ...
- amanda安装
下载地址 http://www.amanda.org/download.php http://www.zmanda.com/download-amanda.php 编译安装 编译出错: error: ...
- Django models 单表查询
从数据库中查询出来的结果一般是一个集合,这个集合叫做 QuerySet 1. 查看Django QuerySet执行的SQL .query.__str__()或 .query属性打印执行的sql语句 ...