
MySQL重做日志(redo log)
前面介绍了三种日志:error log、slow log、binlog,这三种都是 Server 层的。今天的 redo log 是 InnoDB引擎专有的日志文件。
为什么要有 redo log
用个酒店掌柜记账的例子说明 redo log的作用。
酒店掌柜有一个粉板,专门用来记录客人的赊账记录。如果赊账的人不多,那么他可以把顾客名和账目写在板上。但如果赊账的人多了,粉板总会有记不下的时候,这个时候掌柜一定还有一个专门记录赊账的账本
如果有人要赊账或者还账的话,掌柜一般有两种做法:
- 直接翻开账本记录(直接写磁盘)
- 先记在粉板(redo log)上,等空闲时再记录到账本(磁盘)上
当生意火爆时,不停有人来要赊账或者还账(更新操作),如果掌柜还是用第一种做法,由于记到账本上需要查找记录(随机读)那就会出现大量的人(更新操作)在等待,会影响工作(阻塞)。
第二种做法,先记在粉板上,空闲时再写回账本。因为记粉板的速度是很快的,就能大量处理赊账或者还账,当掌柜(MySQL)没那么忙的时候,就把粉板上的内容记到账本上。但如果粉板(redo log)写满了,那这时候掌柜(MySQL)就要停下工作,先去把粉板(redo log)的内容写回账本(磁盘)。
两种做法的区别是:
- 第一种是要找到记录后更新,这里涉及随时读,而随时读是很费时间的
- 第二种是记在日志上,这是顺序写的,而顺序写是很快的
因此MySQL采用第二种做法,当有一条记录需要更新的时候,InnoDB引擎就会先把记录写到redo log(粉板)里面,并更新内存,这个时候更新就算完成了。同时,InnoDB引擎会在适当的时候,将这个操作记录更新到磁盘里面,而这个更新往往是在系统比较空闲的时候做,这就像打烊以后掌柜做的事。
这就是WAL(Write-Ahead Logging),先写日志,再写磁盘。
与粉板类似,redo log 也是有固定大小的。比如可以配置为一组4个文件,每个文件的大小是1GB,那么这块“粉板”总共就可以记录4GB的操作。从头开始写,写到末尾就又回到开头循环写,如下面这个图所示。
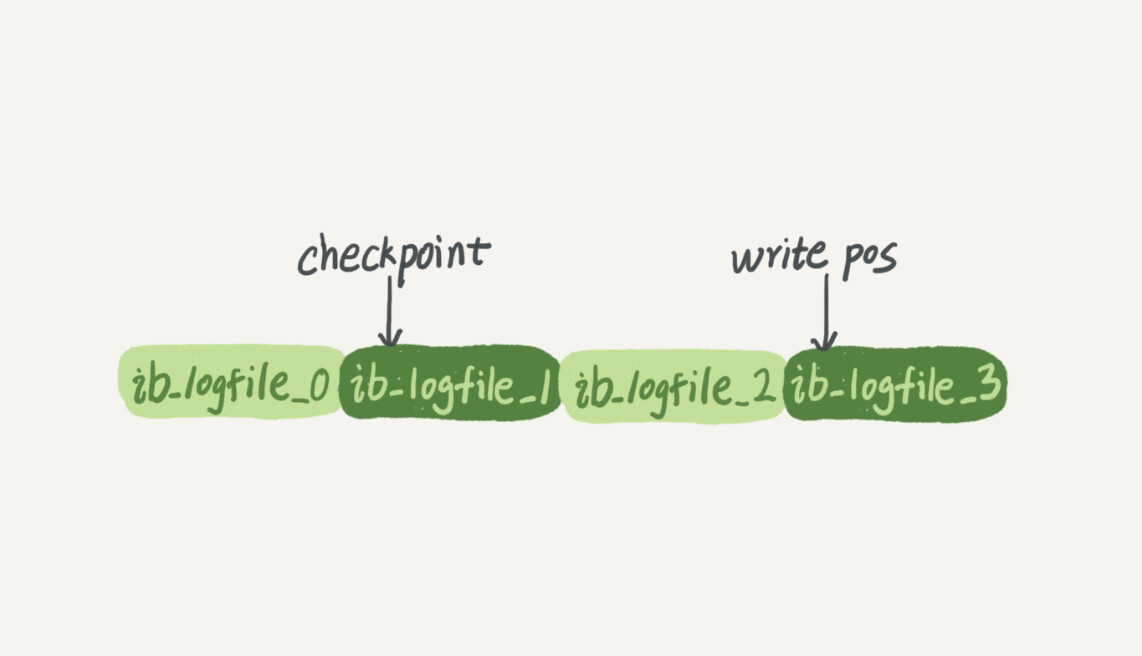
两个指针:
- write pos是当前记录的位置
- checkpoint是当前要擦除的位置
有了 redo log,InnoDB 可以保证即使数据库发生异常重启,之前提交的记录都不会丢失,这个能力称为 crash-safe。
如何写入
下面以一条Update语句来介绍 binlog 是如何记录的。这里在 binlog 里也有介绍过。
mysql> update T set c=c+1 where ID=2;
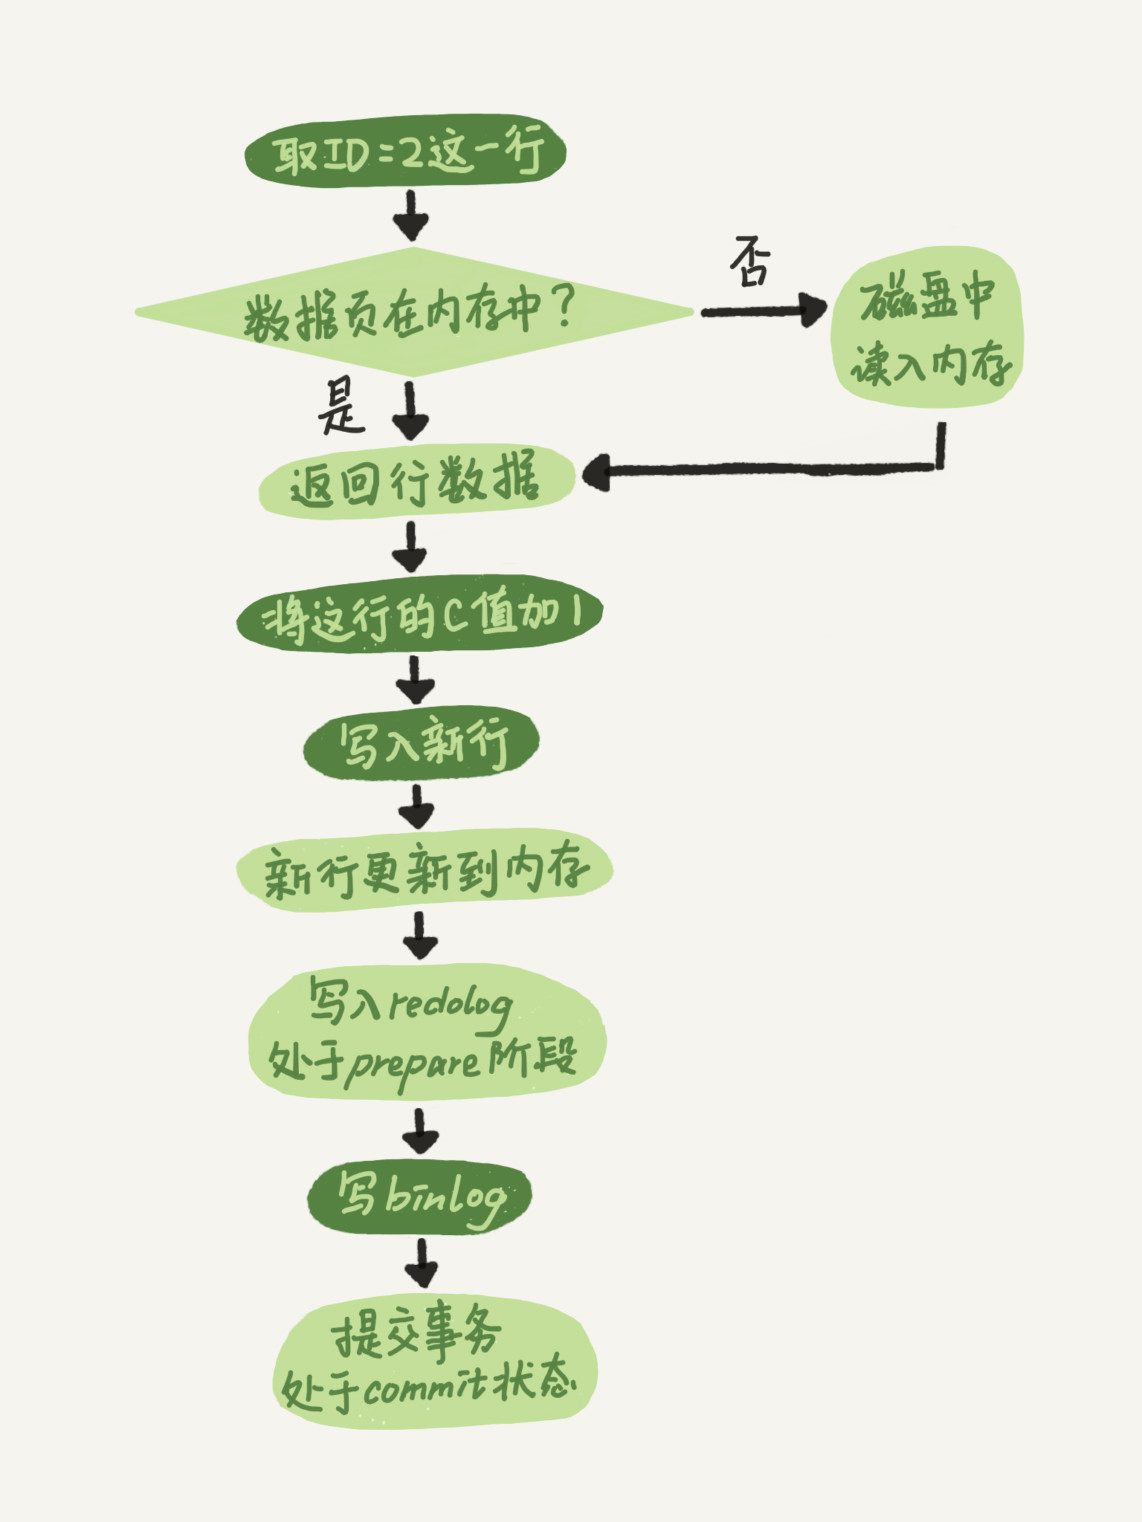
- 取得 ID=2 这一行(通过内存或磁盘读取)
- 这行的 c 值加1
- 更新到内存
- 写入 redo log(处于 prepare 阶段)
- 写 binlog
- 提交事务(处于 commit 状态)
两阶段提交
上面的流程采用了两阶段提交,那为什么要采用两阶段提交呢?是为了让 binlog 和 redo log 之间的逻辑一致。
我们假设一下上面的 update 语句在执行的每个时刻,MySQL 崩溃了,看一下两个日志间的逻辑是如何保持一致的。
- 假设在步骤4前,MySQL崩溃重启,那么事务提交失败,不会影响数据。虽然更新了内存,但崩溃后,内存会丢失。
- 假设在步骤4完成后崩溃,此时已经写入 redo log 了,重启后,发现 redo log 处于 prepare 阶段,就不恢复。
- 假设在步骤5完成后崩溃,此时已经写入 binlog 了,重启后,发现 binlog 已经写入了,就把对应的 redo log 改为 commit 状态。
这样就能保证 redo log 和 binlog 的逻辑一致性。
两阶段提交是跨系统维持数据逻辑一致性时常用的一个方案。
如何使用
这里要介绍一下 redo log 里非常重要的一个参数:innodb_flush_log_at_trx_commit。
innodb_flush_log_at_trx_commit=0 表示提交事务的时候,不立即把 redo log buffer 里的数据刷入磁盘文件的,而是依靠 InnoDB 的主线程每秒执行一次刷新到磁盘。此时可能你提交事务了,结果 mysql 宕机了,然后此时内存里的数据全部丢失。
innodb_flush_log_at_trx_commit=1 表示提交事务的时候,就必须把 redo log 从内存刷入到磁盘文件里去,只要事务提交成功,那么 redo log 就必然在磁盘里了。注意,因为操作系统的“延迟写”特性,此时的刷入只是写到了操作系统的缓冲区中,因此执行同步操作才能保证一定持久化到了硬盘中。
innodb_flush_log_at_trx_commit=2 表示提交事务的时候,把 redo 日志写入磁盘文件对应的 os cache 缓存里去,而不是直接进入磁盘文件,可能 1 秒后才会把 os cache 里的数据写入到磁盘文件里去。
如何选择
- 对数据丢失很敏感,设置为1,保证写到磁盘上。但性能较差。
- 对数据不太敏感,设置为0或2,性能较好。但可能会丢失1秒的数据。
如何查看和设置
通过以下命令查看当前 innodb_flush_log_at_trx_commit 的值是多少:
mysql> select @@innodb_flush_log_at_trx_commit;

+----------------------------------+

| @@innodb_flush_log_at_trx_commit |

+----------------------------------+

|                                1 |

+----------------------------------+

1 row in set (0.00 sec)
在 /etc/mysql/my.cnf 文件里设置 innodb_flush_log_at_trx_commit 选项:
#/etc/mysql/my.cnf

innodb_flush_log_at_trx_commit=1
修改后,重启 MySQL 服务即可。
redo log 与 binlog 的区别
- redo log 是 InnoDB 引擎特有的;binlog 是 MySQL 的 Server 层实现的,所有引擎都可以使用。
- redo log 是物理日志,记录的是“在某个数据页上做了什么修改”;binlog 是逻辑日志,记录的是这个语句的原始逻辑
- redo log 是循环写的,空间固定会用完;binlog 是可以追加写入的。
参考资料
MySQL重做日志(redo log)的更多相关文章
- 详细分析MySQL事务日志(redo log和undo log)
innodb事务日志包括redo log和undo log.redo log是重做日志,提供前滚操作,undo log是回滚日志,提供回滚操作. undo log不是redo log的逆向过程,其实它 ...
- 【MySQL (六) | 详细分析MySQL事务日志redo log】
Reference: https://www.cnblogs.com/f-ck-need-u/archive/2018/05/08/9010872.html 引言 为了最大程度避免数据写入时 IO ...
- 详细分析MySQL事务日志(redo log和undo log) 表明了为何mysql不会丢数据
innodb事务日志包括redo log和undo log.redo log是重做日志,提供前滚操作,undo log是回滚日志,提供回滚操作. undo log不是redo log的逆向过程,其实它 ...
- 【Mysql】三大日志 redo log、bin log、undo log
@ 目录 redo log(物理日志\重做日志) binlog(逻辑日志/归档日志) update语句执行流程 Uodolog(回滚日志/重做日志) undo log+redo log保证持久性 re ...
- MySQL中的redo log和undo log
MySQL中的redo log和undo log MySQL日志系统中最重要的日志为重做日志redo log和归档日志bin log,后者为MySQL Server层的日志,前者为InnoDB存储引擎 ...
- mysql重做日志
一.重做日志(redo log) 1.作用 确保事务的持久性. 防止在发生故障的时间点,尚有脏页未写入磁盘,在重启mysql服务的时候,根据redo log进行重做,从而达到事务的持久性这一特性. 2 ...
- mysql错误日志/var/log/mariadb/mariadb.log,二进制日志
mariadb-日志 IT_luo关注0人评论65人阅读2018-10-15 08:59:03 mariadb日志 mariadb日志: 1.查询日志:query log: 2.慢查询日志:slo ...
- 说说MySQL中的Redo log Undo log都在干啥
在数据库系统中,既有存放数据的文件,也有存放日志的文件.日志在内存中也是有缓存Log buffer,也有磁盘文件log file,本文主要描述存放日志的文件. MySQL中的日志文件, ...
- 【转】说说MySQL中的Redo log Undo log都在干啥
阅读目录(Content) 1 undo 1.1 undo是啥 1.2 undo参数 1.3 undo空间管理 2 redo 2.1 redo是啥 2.2 redo 参数 2.3 redo 空间管理 ...
随机推荐
- 简单操作elasticsearch(es版本7.6)
简单操作elasticsearch(es版本7.6) es 官方文档 https://www.elastic.co/guide/index.html 简单操作elasticsearch主要是指管理索引 ...
- 编码风格:Mvc模式下SSM环境,代码分层管理
本文源码:GitHub·点这里 || GitEE·点这里 一.分层策略 MVC模式与代码分层策略,MVC全名是ModelViewController即模型-视图-控制器,作为一种软件设计典范,用一种业 ...
- delphi key解密转c# 解决string 不可变长度问题
遇见问题: delphi的解密需要在c#里面实现 方法一:delphi编写delphi dll组件,c#里面调用 方法二:c#重写delphi的代码进行解析 方法一: delphi部分代码: libr ...
- ubuntu 18.04 安装anaconda
ubuntu 安装anaconda 4版本 为了学习 tensorflow python3.5 版本 使用anaconda 安装: https://mirrors.tuna.tsinghua.edu. ...
- tensorflow的广播机制
TensorFlow支持广播机制(Broadcast) TensorFlow支持广播机制(Broadcast),可以广播元素间操作(elementwise operations).正常情况下,当你想要 ...
- leetcode128-generate-parentheses
题目描述 给出n对括号,请编写一个函数来生成所有的由n对括号组成的合法组合. 例如,给出n=3,解集为: "((()))", "(()())", "( ...
- Spark架构与原理这一篇就够了
一.基本介绍 是什么? 快速,通用,可扩展的分布式计算引擎. 弹性分布式数据集RDD RDD(Resilient Distributed Dataset)弹性分布式数据集,是Spark中最基本的数据( ...
- 论文解读 - Composition Based Multi Relational Graph Convolutional Networks
1 简介 随着图卷积神经网络在近年来的不断发展,其对于图结构数据的建模能力愈发强大.然而现阶段的工作大多针对简单无向图或者异质图的表示学习,对图中边存在方向和类型的特殊图----多关系图(Multi- ...
- JS函数命名规范
语法规范: 任何合法的javascript标识符都可以作为函数的名称. 约定俗成的内容:(非ECMAScript语法,但是为了便于开发者理解和识别,约定的函数命名规范.) 命名方法: 小驼峰式命名法 ...
- “”.length()与“”.split(",").length
public class test { public static void main(String[] args){ String str = ""; System.out.pr ...