
hadoop权威指南学习(一) - 天气预报MapReduce程序的开发和部署
看过Tom White写的Hadoop权威指南(大象书)的朋友一定得从第一个天气预报的Map Reduce程序所吸引,
殊不知,Tom White大牛虽然在书中写了程序和讲解了原理,但是他以为你们都会部署了,这里轻描淡写给
带过了,这样就给菜鸟们留了课题,其实在跑书中的程序的时候,如果没经验,还是会踩坑的。
这里笔者就把踩过的坑说一下,以防后来人浪费时间了。
1. 首先,你得下载书中的ncdc气象原始数据,这个可以从书中的官网下载。
作者比较做人家,只给了2年的历史数据,无妨,2年也可以运行。
下载下来你会看到1901.gz,1902.gz
2. 然后我们可以开始我们的编码之旅了
新建一个maven项目,然后按照书中的例子,编写如下3个类(这里Mapper, Reducer, Job的原理我就不多解释了,自己去看大牛的书去)
MaxTemperatureMapper.java
package org.genesis.hadoop.temperature;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class MaxTemperatureMapper

  extends Mapper<LongWritable, Text, Text, IntWritable> {

  private static final int MISSING = 9999;

  @Override

  public void map(LongWritable key, Text value, Context context)

      throws IOException, InterruptedException {

    String line = value.toString();

    String year = line.substring(15, 19);

    int airTemperature;

    if (line.charAt(87) == '+') { // parseInt doesn't like leading plus signs

      airTemperature = Integer.parseInt(line.substring(88, 92));

    } else {

      airTemperature = Integer.parseInt(line.substring(87, 92));

    }

    String quality = line.substring(92, 93);

    if (airTemperature != MISSING && quality.matches("[01459]")) {

      context.write(new Text(year), new IntWritable(airTemperature));

    }

  }

}
MaxTemperatureReducer.java
package org.genesis.hadoop.temperature;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class MaxTemperatureReducer

  extends Reducer<Text, IntWritable, Text, IntWritable> {

  @Override

  public void reduce(Text key, Iterable<IntWritable> values,

      Context context)

      throws IOException, InterruptedException {

    int maxValue = Integer.MIN_VALUE;

    for (IntWritable value : values) {

      maxValue = Math.max(maxValue, value.get());

    }

    context.write(key, new IntWritable(maxValue));

  }

}
MaxTemperature.java
package org.genesis.hadoop.temperature;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

public class MaxTemperature {

  public static void main(String[] args) throws Exception {

    if (args.length != 2) {

      System.err.println("Usage: MaxTemperature <input path> <output path>");

      System.exit(-1);

    }

    Job job = new Job();

    job.setJarByClass(MaxTemperature.class);

    job.setJobName("Max temperature");

    FileInputFormat.addInputPath(job, new Path(args[0]));

    FileOutputFormat.setOutputPath(job, new Path(args[1]));

    job.setMapperClass(MaxTemperatureMapper.class);

    job.setReducerClass(MaxTemperatureReducer.class);

    job.setOutputKeyClass(Text.class);

    job.setOutputValueClass(IntWritable.class);

    System.exit(job.waitForCompletion(true) ? 0 : 1);

  }

}
然后把我们的Java程序打包,你认为自己是一个Java熟手,不是吗,熟练的命令或者IDE都可以(mvn clean install)
Ok, 包打完了,得到如下jar包: xxx.jar
好了,你可能会试着用书中或者网上的命令(前提是你已经配置好$hadoop_home)
hadoop jar xxx.jar 你的主类名 你的本地gz文件存放的目录 你本地另外一个输出目录
然而,很不幸,你的程序跑不了,理由很简单,根本就找不到你的gz文件的目录。
喔,查了下网上的资料,发现我似乎应该把本地文件拷贝到HDFS,赶快查资料,下一步。。。
3. 将本地数据拷贝到HDFS(前提是你已经安装了hadoop并且把服务给启动了起来)
3-1) 我们先在hdfs根目录下建个data目录
hadoop fs -mkdir /data
3-2) 把我们的gz数据拷贝到刚刚新建的目录
hadoop fs -copyFromLocal /Users/KG/Documents/MyWork/Hadoop/data/ncdc/*.gz /data
3-3)把我们的jar包拷贝到一个地方,然后进入命令行,进入哪个目录
cd /Users/KG/Documents/MyTest/Jar
3-4) 使用hadoop jar运行命令
但是,这里你会报错: 找不到主类名
解决方案:你需要给自己的pom配置shade插件
我的pom.xml
<?xml version="1.0" encoding="UTF-8"?>

<project xmlns="http://maven.apache.org/POM/4.0.0"

         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

    <modelVersion>4.0.0</modelVersion>

    <groupId>org.genesis</groupId>

    <artifactId>MaxTemperature</artifactId>

    <version>1.0-SNAPSHOT</version>

    <dependencies>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-core</artifactId>

            <version>1.2.1</version>

        </dependency>

        <dependency>

            <groupId>org.apache.hadoop</groupId>

            <artifactId>hadoop-common</artifactId>

            <version>2.7.2</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <groupId>org.apache.maven.plugins</groupId>

                <artifactId>maven-shade-plugin</artifactId>

                <version>2.4.1</version>

                <executions>

                    <execution>

                        <phase>package</phase>

                        <goals><goal>shade</goal></goals>

                        <configuration>

                            <transformers>

                                <transformer implementation="org.apache.maven.plugins.shade.resource.ManifestResourceTransformer">

                                    <mainClass>org.genesis.hadoop.temperature.MaxTemperature</mainClass>

                                </transformer>

                            </transformers>

                        </configuration>

                    </execution>

                </executions>

            </plugin>

        </plugins>

    </build>

</project>
3-5)再次运行完整命令,如下:
hadoop jar original-MaxTemperature-1.0-SNAPSHOT.jar org.genesis.hadoop.temperature.MaxTemperature /data /data/output
如果你看到如下输出,那么你成功了
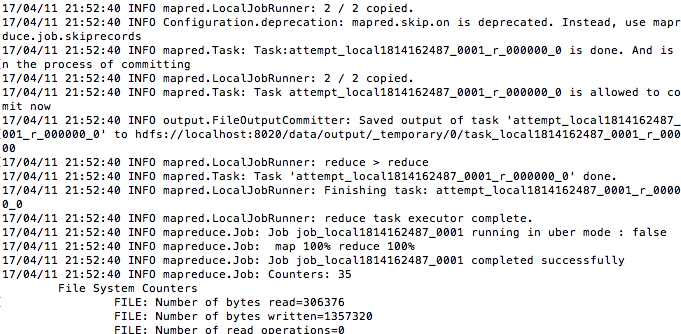
4. 验证分析结果
使用如下命令:
hadoop fs -cat /data/output/*
输出结果如下:
1901 317
1902 244
hadoop权威指南学习(一) - 天气预报MapReduce程序的开发和部署的更多相关文章
- Hadoop权威指南学习笔记二
MapReduce简单介绍 声明:本文是本人基于Hadoop权威指南学习的一些个人理解和笔记,仅供学习參考,有什么不到之处还望指出,一起学习一起进步. 转载请注明:http://blog.csdn.n ...
- Hadoop权威指南学习笔记一
Hadoop简单介绍 声明:本文是本人基于Hadoop权威指南学习的一些个人理解和笔记,仅供学习參考,有什么不到之处还望指出.一起学习一起进步. 转载请注明:http://blog.csdn.net/ ...
- Hadoop权威指南学习笔记三
HDFS简单介绍 声明:本文是本人基于Hadoop权威指南学习的一些个人理解和笔记,仅供学习參考.有什么不到之处还望指出,一起学习一起进步. 转载请注明:http://blog.csdn.net/my ...
- Hadoop权威指南 - 学习笔记
初识Hadoop.关于MapReduce Hadoop宏观介绍 相对于其他系统的优势 关系型数据库管理系统 为什么不能用配有大量硬盘的数据库进行大规模分析?为什么需要Hadoop? 因为计算机硬盘的发 ...
- 转载:Hadoop权威指南学习笔记
转自:http://pieux.github.io/blog/2013-05-08-learn-hadoop-the-definitive-guide.html 1 前言 Hadoop的内部工作机制: ...
- Hadoop 权威指南学习1 (主要框架)
1. Hadoop 最出名的是 MapReduce和 HDFS,不过也有很多其他有用的子项目. 技术栈如下: Core 一系列分布式文件系统和通用I/O的组件和接口(序列化.Java RPC和持久化数 ...
- Hadoop 权威指南学习2 (Sqoop)
6. Sqoop Apache sqoop is an open source tool that allow users to extract data from structured data s ...
- hadoop权威指南学习
通常情况下,处理少量的大型文件更容易.更有效,为什么呢? map阶段中的键如果不需要可以忽略掉? MapReduce过程也可以用于本地文件的处理,但是如果是要使用到集群的话还需要HDFS. Data ...
- Hadoop权威指南:MapReduce应用开发
Hadoop权威指南:MapReduce应用开发 [TOC] 一般流程 编写map函数和reduce函数 编写驱动程序运行作业 用于配置的API Hadoop中的组件是通过Hadoop自己的配置API ...
随机推荐
- (一)什么是webservice?
第一节: 第一节:Webservice 简介 第二节: 第二节:CXF 简介 webservice 有的人一看到这个,估计会认为这个是一种新技术,一种新框架. 其实不是,严格的说,webservice ...
- python 全栈开发,Day141(flask之应用上下文,SQLAlchemy)
一.flask之应用上下文 由于时间关系,详细过程略... 草稿图 参考链接: http://www.cnblogs.com/zhaopanpan/p/9457343.html 总结: 上下文管理(应 ...
- 2017-2018-2 20155309 南皓芯 Exp5 MSF基础应用
实践内容 本实践目标是掌握metasploit的基本应用方式,重点常用的三种攻击方式的思路.具体需要完成: 1.1一个主动攻击实践,如ms08_067; 1.2 一个针对浏览器的攻击,如ms11_05 ...
- DDD领域模型实现依赖注入(六)
添加下订单的值对象: public partial class CustomerInfo:ValueObject { /// <summary> /// 下订单的值对象 /// </ ...
- C++Primer笔记——文本查询程序(原创,未使用类)
#include <iostream> #include <vector> #include <set> #include <map> #include ...
- linux学习之使用fdisk命令进行磁盘分区(八)
linux下使用fdisk命令进行磁盘分区 目录 分区类型 分区方法表示 文件系统 fdisk命令分区过程 分区类型 主分区:总共最多只能分四个 扩展分区:只能有一个,也算作主分区的一种,也就是说主分 ...
- WebPack 学习:从阮神的15个DEMO开始
WebPack 是什么 官方就一句话,打包所有的资源. 从阮神的 15 DEOM入手 Webpack Github 地址 阮神GIT 按照 ReadME 操作 npm webpack-dev-serv ...
- zip&ftp命令
zip: C:\Users\IBM_ADMIN>zip -09r Oracle.zip ./Oracle/* C:\Users\IBM_ADMIN>ftp ftp> open adm ...
- Nginx 安装配置文件解析
源地址:https://www.cnblogs.com/Chiler/p/8027167.html 前言 Nginx (engine x) 是一个高性能的HTTP和反向代理服务器,也是一个IMAP/P ...
- 【随笔】借鉴 & KPI式设计
1. 别人(某成功案例)是这么做的,我们也就这么做吧 刚来组里一会就目睹了需求讨论会上的一场争执,大概就是某产品经理在解释需求解释到后面有些说不通了就说“xxx App是这么做的我觉得我们也可以这样做 ...