
python爬虫基本原理及入门
爬虫:请求目标网站并获得数据的程序
爬虫的基本步骤:
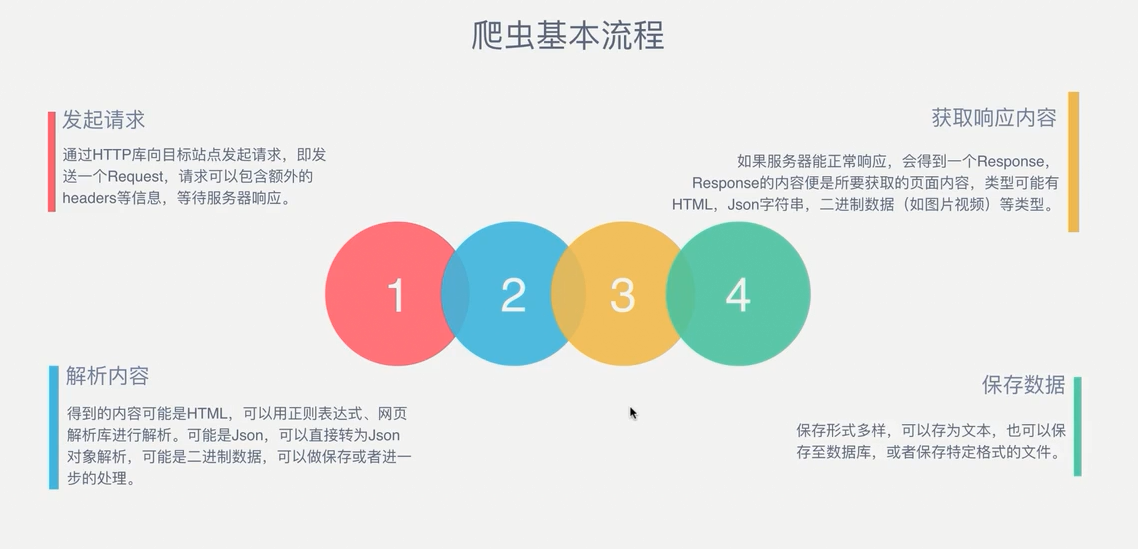
使用python自带的urllib库请求百度:
import urllib.request

response = urllib.request.urlopen('http://www.baidu.com')

print(type(response))

#打印结果

<class 'http.client.HTTPResponse'>
可以从类型上看出来,response是一个HTTP响应
请求:
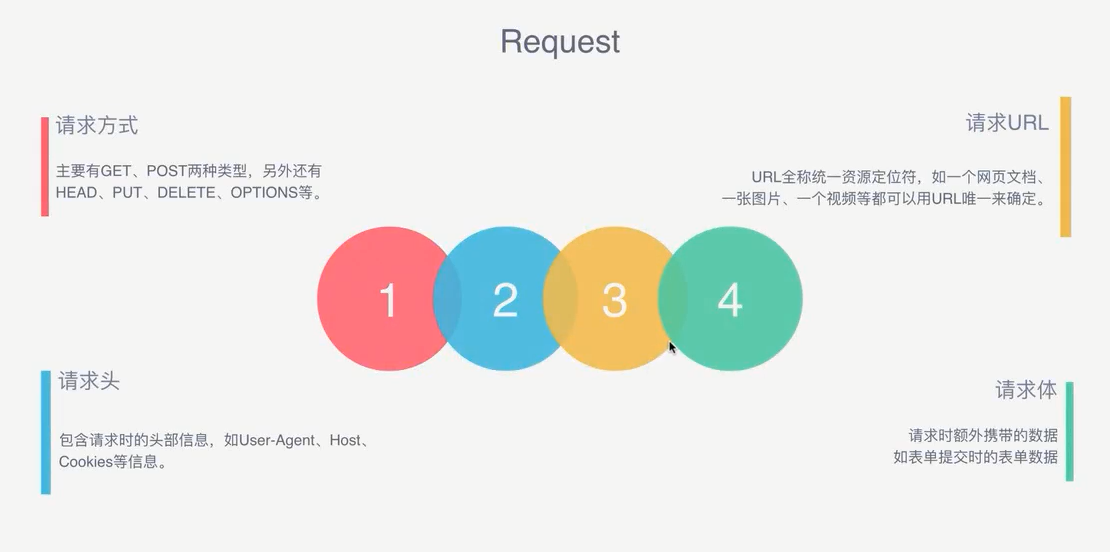
请求的方式以GET和POST最为常用,一般的GET方法将请求参数放在URL中。如在百度中搜索一个关键词,这就形成了以GET在URL中更改参数的方法。
而POST将参数放在表单内进行请求。如请求登陆百度,需要向百度服务器发送你的账号密码这些东西。
请求头是一个很重要的请求内容,在一般的浏览器请求中,网站会返回一个你的浏览器信息,如果在代码不伪装程浏览器的情况下,你的IP地址会迅速的被网站封掉,每个爬虫库的伪装方式都是不同的,如urllib库
import urllib.request

heads = {}

    heads['User-Agent'] = 'Mozilla/5.0 ' \

                          '(Macintosh; U; Intel Mac OS X 10_6_8; en-us) AppleWebKit/534.50 ' \

                          '(KHTML, like Gecko) Version/5.1 Safari/534.50'

req = urllib.request.Request(url=url, data=data, method='POST', headers=heads)

response = urllib.request.urlopen(req)
print(response.getheaders())    #getheaders()方法将会返回给你一些请求信息,如时间,服务器信息等,包含user-agent
响应:
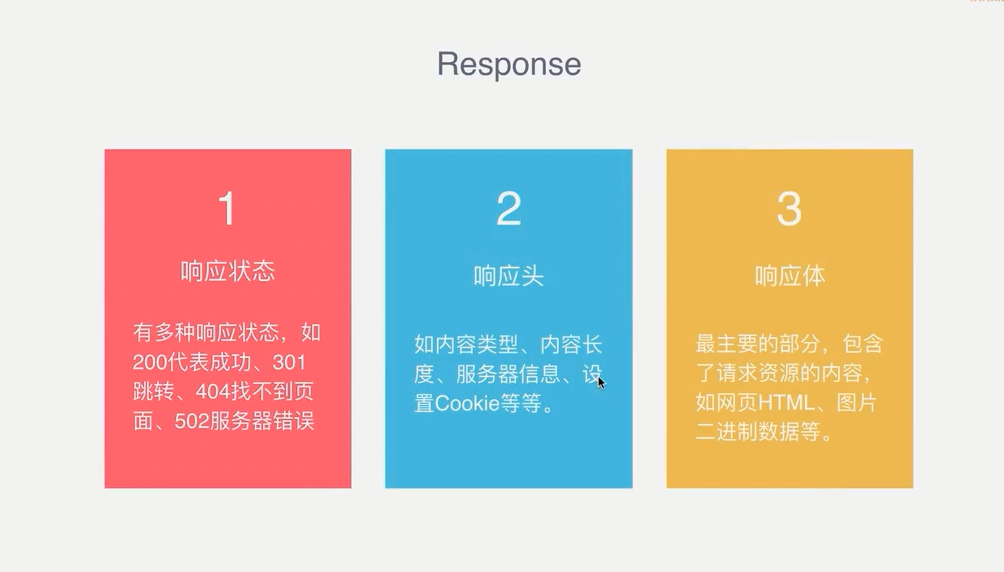
响应就是请求之后浏览器所呈现的东西,最重要的就是响应体,包含了网页的源文件
在代码的情况下查看响应状态:
import urllib.request

response = urllib.requset.urlopen('http://www.baidu.com')

print(response.getcode())

#返回200表示成功
解析方式:
当想要获得网页中某些元素应该怎样去解析?
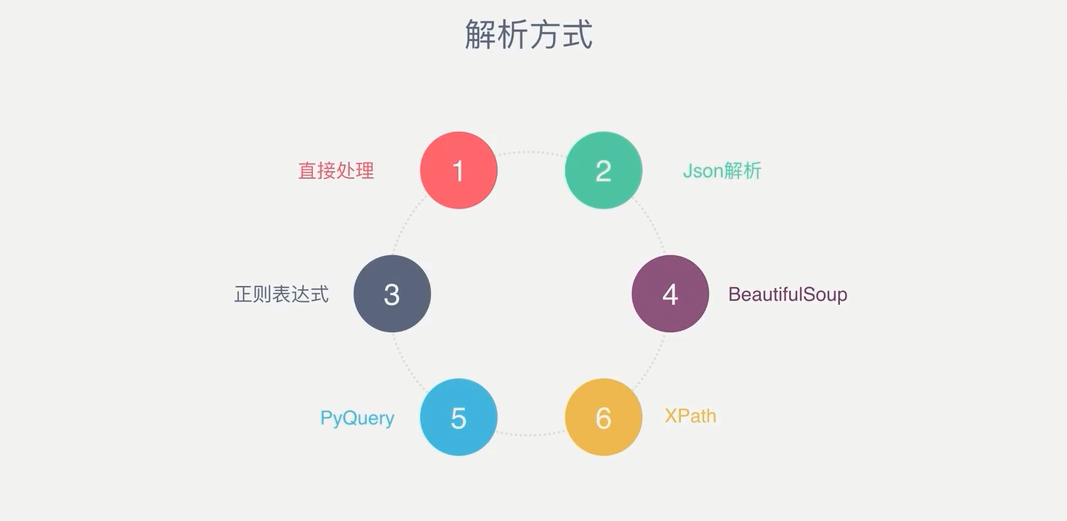
解析的方式多种多样,目前还只是使用正则来做解析,听说xpath是最简单解析方式,不过我觉得每个库还是要使用一下试试的,看看哪个更适合你。
为什么有的网页请求源码和在浏览器中查看到的不一样?
这是因为动态网站使用了JS渲染,元素都是经过js动态加载出来的,所以想要获得源码还要去模拟浏览器的行为,像selenium驱动browser,PhantomJS等工具。
python爬虫基本原理及入门的更多相关文章
- 0.Python 爬虫之Scrapy入门实践指南(Scrapy基础知识)
目录 0.0.Scrapy基础 0.1.Scrapy 框架图 0.2.Scrapy主要包括了以下组件: 0.3.Scrapy简单示例如下: 0.4.Scrapy运行流程如下: 0.5.还有什么? 0. ...
- Python爬虫的简单入门(一)
Python爬虫的简单入门(一) 简介 这一系列教学是基于Python的爬虫教学在此之前请确保你的电脑已经成功安装了Python(本教程使用的是Python3).爬虫想要学的精通是有点难度的,尤其是遇 ...
- Python爬虫Scrapy框架入门(0)
想学习爬虫,又想了解python语言,有个python高手推荐我看看scrapy. scrapy是一个python爬虫框架,据说很灵活,网上介绍该框架的信息很多,此处不再赘述.专心记录我自己遇到的问题 ...
- Python爬虫基础知识入门一
一.什么是爬虫,爬虫能做什么 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.比如它在抓取一个网 ...
- Python爬虫基本原理
爬虫基本原理 1. 什么是爬虫 请求网站并提取数据的自动化程序. 2. 爬虫基本流程 发起请求 通过HTTP库向目标站点发起请求,即发送一个Request,请求可以包含额外的headers等信息,等待 ...
- Python爬虫三年没入门,传授一下绝世神功,经理唏嘘不已!
长期枯燥的生活,敲代码的时间三天两头往吸烟室跑,被项目经理抓去训话. "入门"是学习Python最重要的阶段,虽然这个过程也许会非常缓慢.当你心里有一个目标时,那么你学习起来就不会 ...
- 这个Python爬虫的简单入门及实用的实例,你会吗?
前言本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理.作者:HOT_and_COOl 利用爬虫可以进行数据挖掘,比如可以爬取别人的网 ...
- Python爬虫零基础入门(系列)
一.前言上一篇演示了如何使用requests模块向网站发送http请求,获取到网页的HTML数据.这篇来演示如何使用BeautifulSoup模块来从HTML文本中提取我们想要的数据. update ...
- Python爬虫Scrapy框架入门(2)
本文是跟着大神博客,尝试从网站上爬一堆东西,一堆你懂得的东西 附上原创链接: http://www.cnblogs.com/qiyeboy/p/5428240.html 基本思路是,查看网页元素,填写 ...
随机推荐
- SAP应用创新-维护控制表、视图统一路径
SAP应用创新-维护控制表.视图统一路径 背景: Sap 里面通过技术支持人员维护表的值控制业务操作的表不少,一般通过事物代码或记录在系统外的文档或在某个程序上放置一个按钮.缺点:分散,不易记,不好找 ...
- React绑定事件动态化的实现方法
一.什么是绑定事件 1.1 事件 我这里指的事件一般指的是React自带的触发事件,我这里先简单举例几个 onClick //鼠标点击 onMouseEnter //鼠标滑进 onMouseLeave ...
- SNMOJ 31
考虑将给入的$A$数组差分,得到差分数组$C$ 每一次操作相当于把差分数组的每一位${+1}$,其中一个位置上${-n+1}$. 我们可以直接算出要进行多少次操作:${T=\frac{\sum A[i ...
- python的json模块的dumps,loads,dump,load方法介绍
dumps和loads方法都在内存中转换, dump和load的方法会多一个步骤,dump是把序列化后的字符串写到一个文件中,而load是从一个文件中读取字符串 将列表转为字符串 >>&g ...
- L1-047. 装睡
水题直接上代码: #include<iostream> #include<algorithm> using namespace std; int main() { int n; ...
- 30秒了解Excel的前世今生
JS 大家日常工作离不开的Excel,实际上脱胎于1979年问世的Apple II电脑上的一款杀手级应用VisiCalc. VisiCalc在问世后的6年间,以100美金一份的价格卖出了超过70万份, ...
- MySQL学习(十五)
索引的概念 索引是数据的目录,能快速定位数据的位置.索引提高了查询速度,降低了增删改的速度.并非加的越多越好. 一般在查询频率高的列上加,而且在重复度低的列上加效果更好.如在性别列上不用加索引,但是身 ...
- OP社区相关
●相关网站官网: http://openstack.org Wiki: http://wiki.openstack.org 代码贡献统计:http://stackalytics.com/ Bug跟踪: ...
- Ubuntu vim终端常用的快捷键
Ubuntu中常用的快捷键 Ubuntu中的许多操作在终端(Terminal)中十分的快捷,记住一些快捷键的操作更得心应手.在Ubuntu中打开终端的快捷键是Ctrl+Alt+T.其他的一些常用的快捷 ...
- HeadFirst Ruby 第七章总结 references
前言 这一章的内容关于 references,讲了当 Ruby 程序中可能会遇到关于 reference 与 object 之间概念混淆而导致的问题. 导言 本章从一个 astronomer 发现 s ...