
<强化学习>马尔可夫决策过程MDP
一.MDP / NFA :马尔可夫模型和不确定型有限状态机的不同
状态自动机:https://www.cnblogs.com/AndyEvans/p/10240790.html
MDP和NFA唯一相似的地方就是它们都有状态转移,抛掉这一点两者就八竿子打不着了。
二.MP -> MRP -> MDP

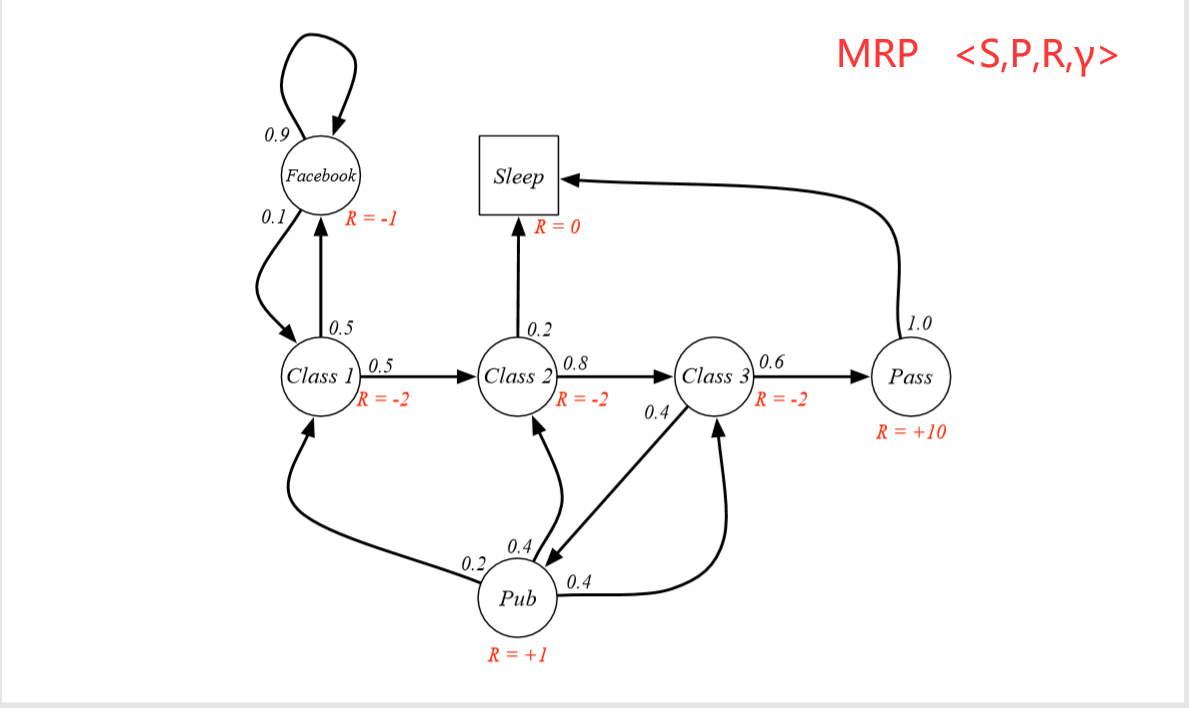
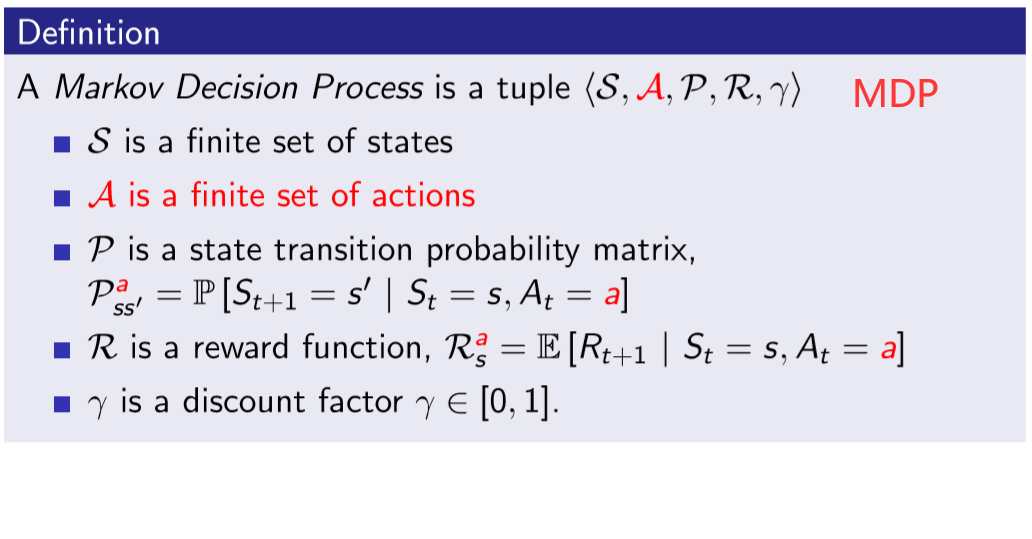
三.计算给定策略下的价值函数 / 贝尔曼期望方程
我们用贝尔曼期望方程求解在某个给定策略π和环境ENV下的价值函数:
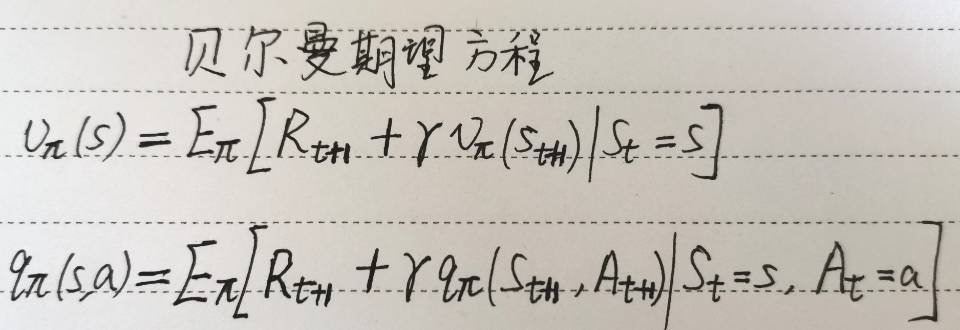
具体解法是:(下面是对于V(s)的解法)

从而对于每一个特定的π,都能得到其对应的价值函数。所以我们可以有一组的{ (π1,value_function_of_π1) ,(π2,value_function_of_π2) ...... }
但是我们解决问题的目标是拿到最优的那组,其他的扔掉,解决方法就是使用贝尔曼最优方程确定最优价值函数。
四. 确定最优价值函数 /贝尔曼最优方程
我们的“最优价值函数”和“最优策略”是如下定义的,找最优价值函数的过程也就是找最优策略的过程
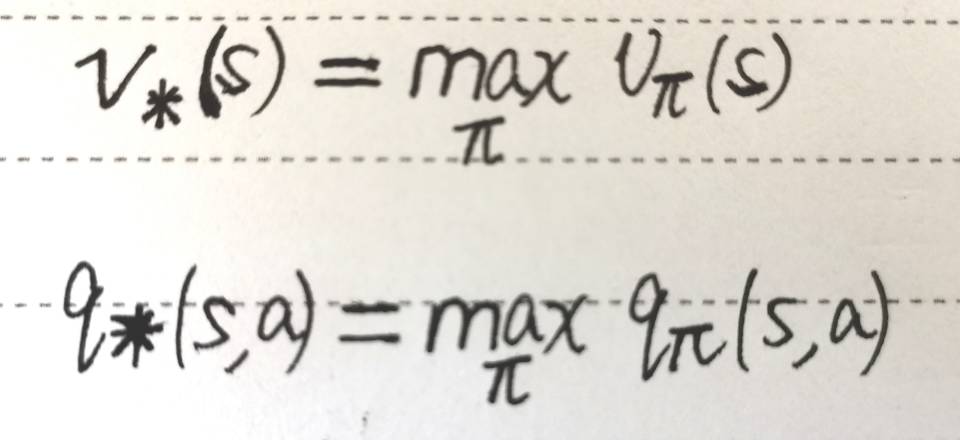
最优价值函数 ==== 一个MDP中的可能的最好的表现
解决一个MDP ==== 确定唯一的最优价值函数
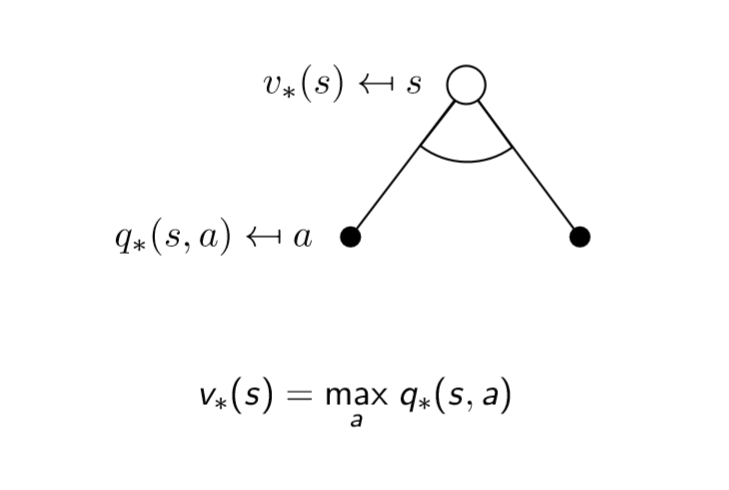
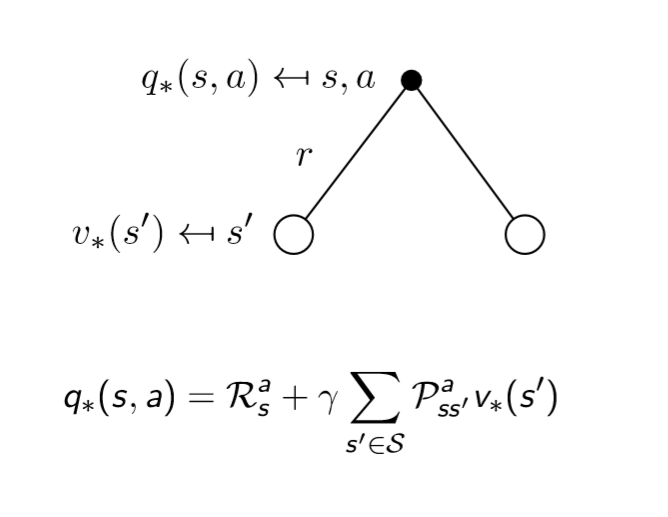
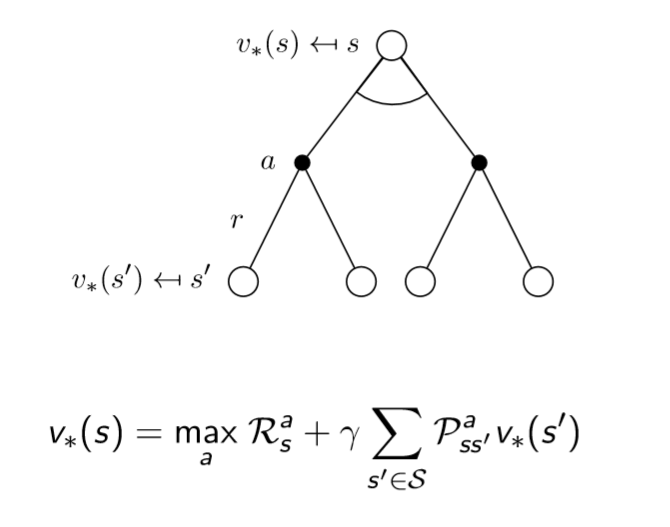
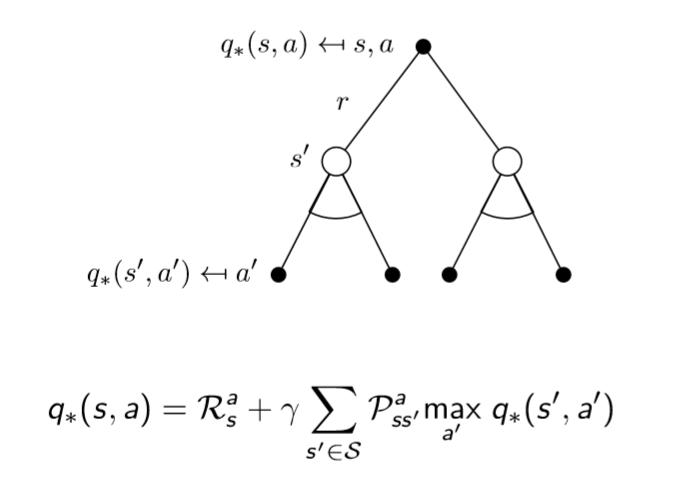
传统的强化学习算法就是找定“最优价值”&“最优策略”的算法,好比SVM是要找定“最大间隔超平面”(“传统”和“现代”相区分,“现代”强化学习算法都是使用神经网络将其不确定化,转化为一个回归问题,训练模型参数,抛弃了“传统”方法的数学硬推)。
贝尔曼最优方程是非线性的,没有一个固定解法。所以,你就知道这是最原始的强化学习问题就好了,没有人会用这个硬推来解决强化学习问题的。
比它稍微高级一点儿,我们采用迭代法来求解最优价值最优策略:
——Value iteration
——Policy iteration
——Q-learning
——Sarsa
——Sarsa(lamda)
五.无限MDP和连续MDP
转换为离散MDP即可。
六.POMDP

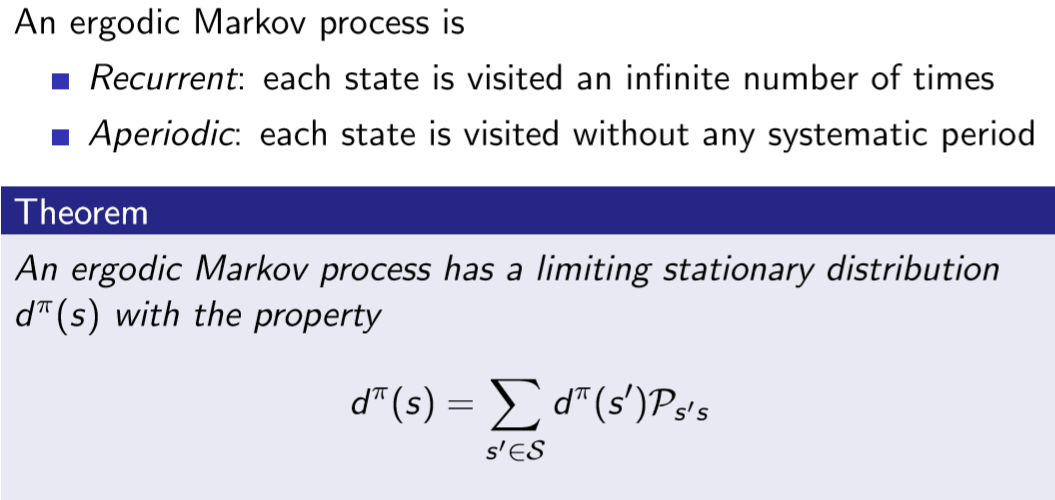
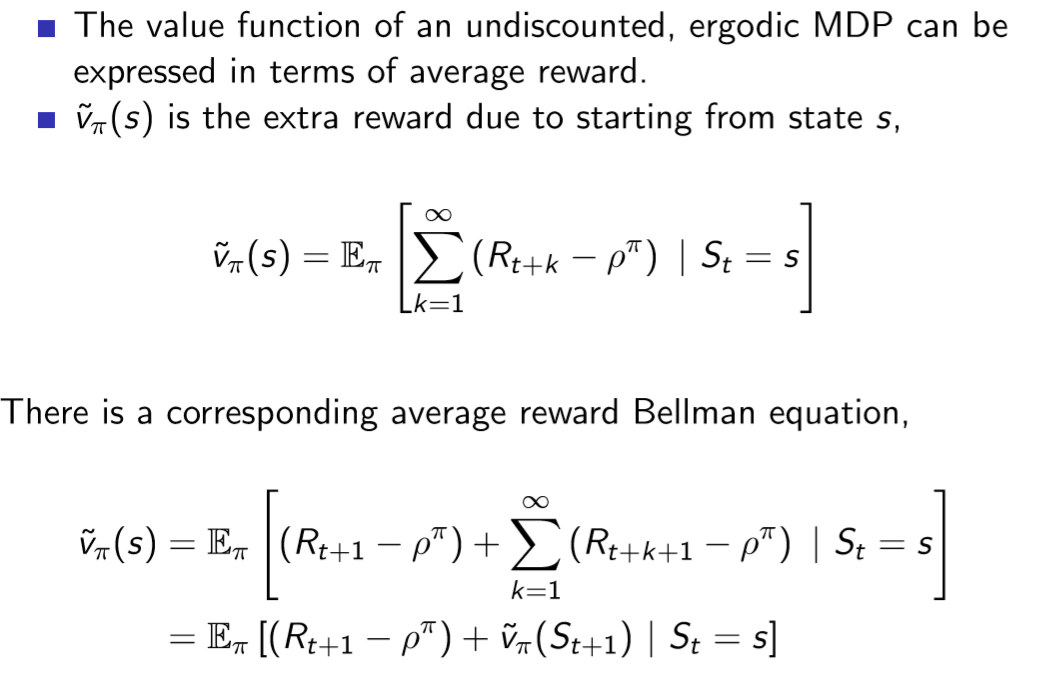
七.Undiscounted average reward MDP

<强化学习>马尔可夫决策过程MDP的更多相关文章
- 转:增强学习(二)----- 马尔可夫决策过程MDP
1. 马尔可夫模型的几类子模型 大家应该还记得马尔科夫链(Markov Chain),了解机器学习的也都知道隐马尔可夫模型(Hidden Markov Model,HMM).它们具有的一个共同性质就是 ...
- 增强学习(二)----- 马尔可夫决策过程MDP
1. 马尔可夫模型的几类子模型 大家应该还记得马尔科夫链(Markov Chain),了解机器学习的也都知道隐马尔可夫模型(Hidden Markov Model,HMM).它们具有的一个共同性质就是 ...
- 马尔可夫决策过程MDP
1. 马尔可夫模型的几类子模型 马尔科夫链(Markov Chain),了解机器学习的也都知道隐马尔可夫模型(Hidden Markov Model,HMM).它们具有的一个共同性质就是马尔可夫性(无 ...
- 强化学习-MDP(马尔可夫决策过程)算法原理
1. 前言 前面的强化学习基础知识介绍了强化学习中的一些基本元素和整体概念.今天讲解强化学习里面最最基础的MDP(马尔可夫决策过程). 2. MDP定义 MDP是当前强化学习理论推导的基石,通过这套框 ...
- 强化学习入门基础-马尔可夫决策过程(MDP)
作者:YJLAugus 博客: https://www.cnblogs.com/yjlaugus 项目地址:https://github.com/YJLAugus/Reinforcement-Lear ...
- David Silver强化学习Lecture2:马尔可夫决策过程
课件:Lecture 2: Markov Decision Processes 视频:David Silver深度强化学习第2课 - 简介 (中文字幕) 马尔可夫过程 马尔可夫决策过程简介 马尔可夫决 ...
- 【cs229-Lecture16】马尔可夫决策过程
之前讲了监督学习和无监督学习,今天主要讲“强化学习”. 马尔科夫决策过程:Markov Decision Process(MDP) 价值函数:value function 值迭代:value iter ...
- 【RL系列】马尔可夫决策过程——状态价值评价与动作价值评价
请先阅读上两篇文章: [RL系列]马尔可夫决策过程中状态价值函数的一般形式 [RL系列]马尔可夫决策过程与动态编程 状态价值函数,顾名思义,就是用于状态价值评价(SVE)的.典型的问题有“格子世界(G ...
- 【RL系列】马尔可夫决策过程——Jack‘s Car Rental
本篇请结合课本Reinforcement Learning: An Introduction学习 Jack's Car Rental是一个经典的应用马尔可夫决策过程的问题,翻译过来,我们就直接叫它“租 ...
随机推荐
- Metasploit学习笔记——网络服务渗透攻击
1.内存攻防技术 1.1缓冲区溢出漏洞机理 1.2栈溢出利用机理 1.3缓冲区溢出利用的限制条件 2.网络服务渗透攻击面 3. Windows服务渗透攻击实战案例——MS08-067安全漏洞 示例代码 ...
- css的艺术
鲁先生曾经说过:"html和css都不能算一门语言..." html确实不能算一门语言,他只是二三十个英语单词而已,但是css不一样,css是==艺术== 骚操作 上图的12个图标 ...
- 047、Java中使用if…else if…else判断
01.代码如下: package TIANPAN; /** * 此处为文档注释 * * @author 田攀 微信382477247 */ public class TestDemo { public ...
- select rank() over
select * from (select rank() over(partition by barcode order by sheetdate) num, * from ScanRecord wh ...
- WinForm_UI设计
下载
- 吴裕雄--天生自然java开发常用类库学习笔记:Stack类
import java.util.Stack ; public class StackDemo{ public static void main(String args[]){ Stack<St ...
- 51nod 1559 车和矩形
http://www.51nod.com/Challenge/Problem.html#problemId=1559 倘若矩形是受保护的,那么矩形内每一行至少有一个车或者每一列至少有一个车 判断矩形内 ...
- NO3 cat-xargs-cp-mv-rm-find命令
·cat #查看文件内容 eg:cat oldboy.txt·xargs #从标准输入获取内容创建和执行命令 -n 加数字:分组 ·cp ...
- 软件管理-RPM命令管理:安装升级与卸载
1.包名与包全名 包名 : 操作已经安装的软件包时,使用包名:系统会搜索var/lib/rpm中的数据库 包全名: 操作的包时没有安装的软件包时,使用包全名,而且注意路径 2.RPM安装 切换到光盘p ...
- PyTorch自动微分基本原理
序言:在训练一个神经网络时,梯度的计算是一个关键的步骤,它为神经网络的优化提供了关键数据.但是在面临复杂神经网络的时候导数的计算就成为一个难题,要求人们解出复杂.高维的方程是不现实的.这就是自动微分出 ...