
Spark 2.x Troubleshooting Guide
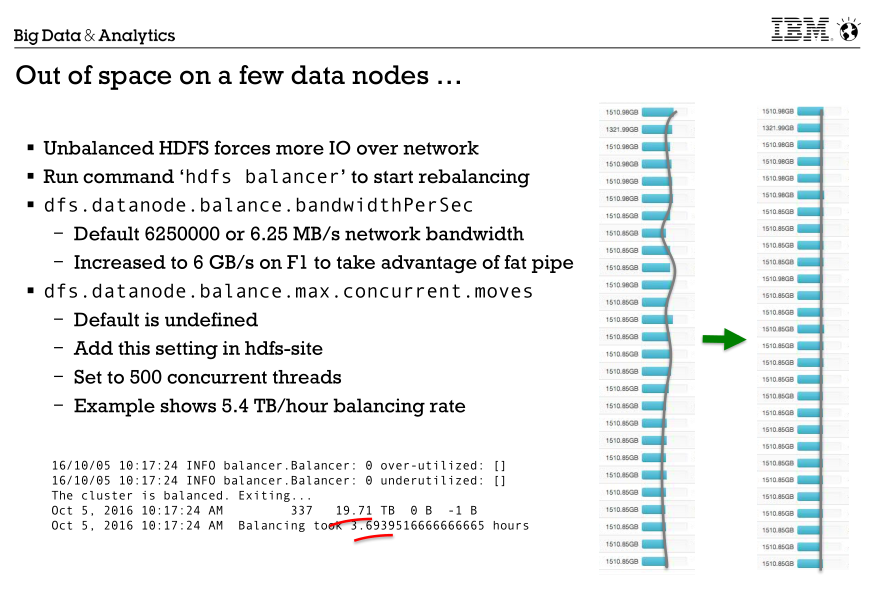
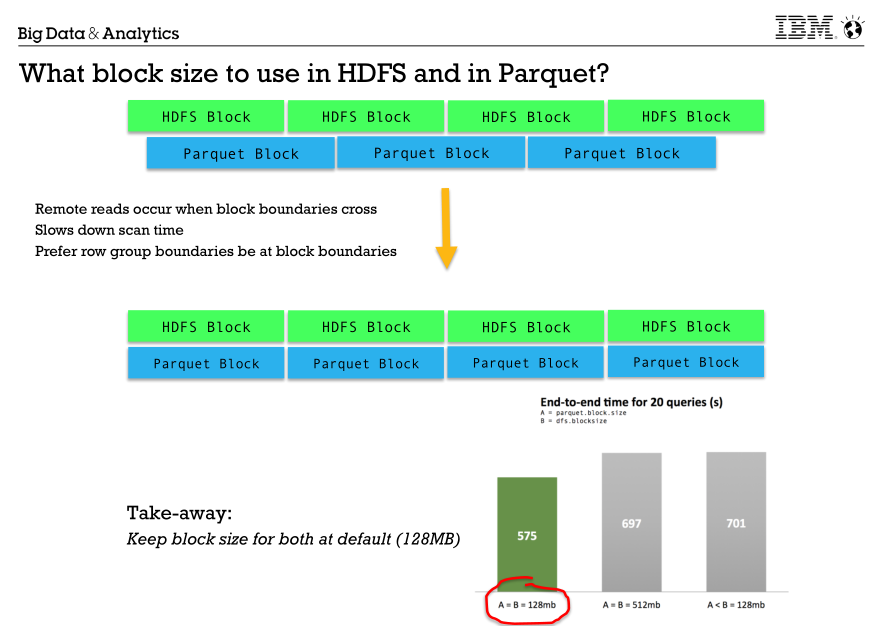
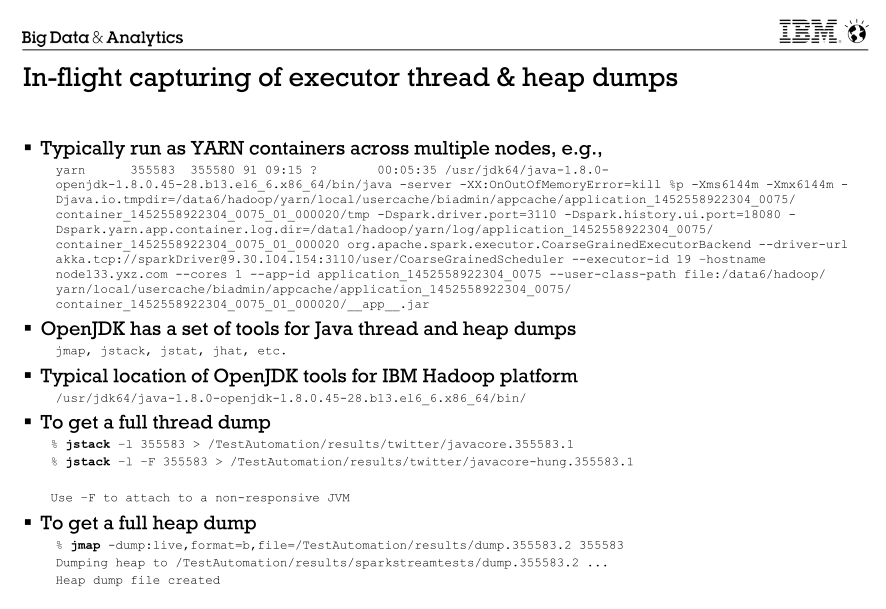
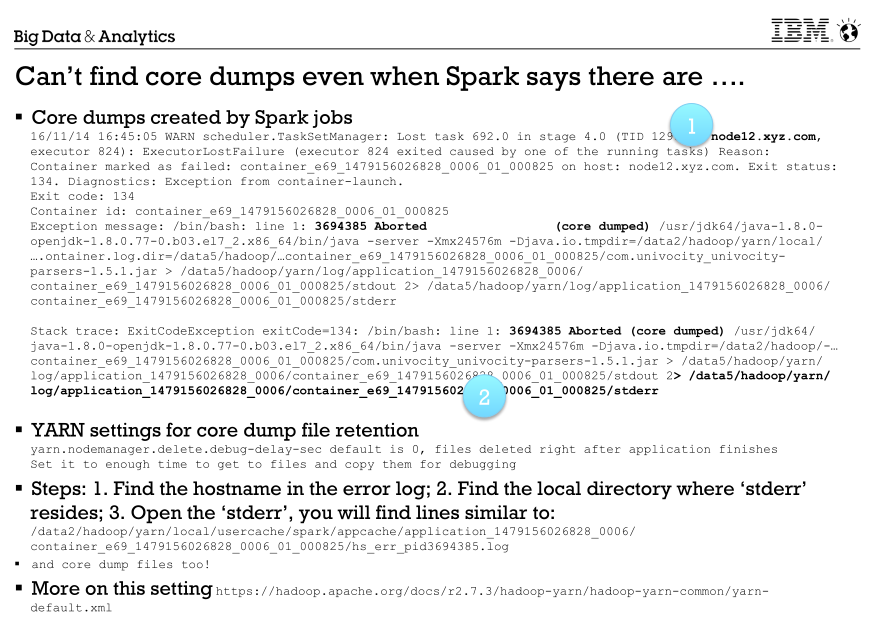
IBM在spark summit上分享的内容,包括编译spark源码,运行spark时候常见问题(缺包、OOM、GC问题、hdfs数据分布不均匀等),spark任务堆/thread dump
目录
编译spark的问题
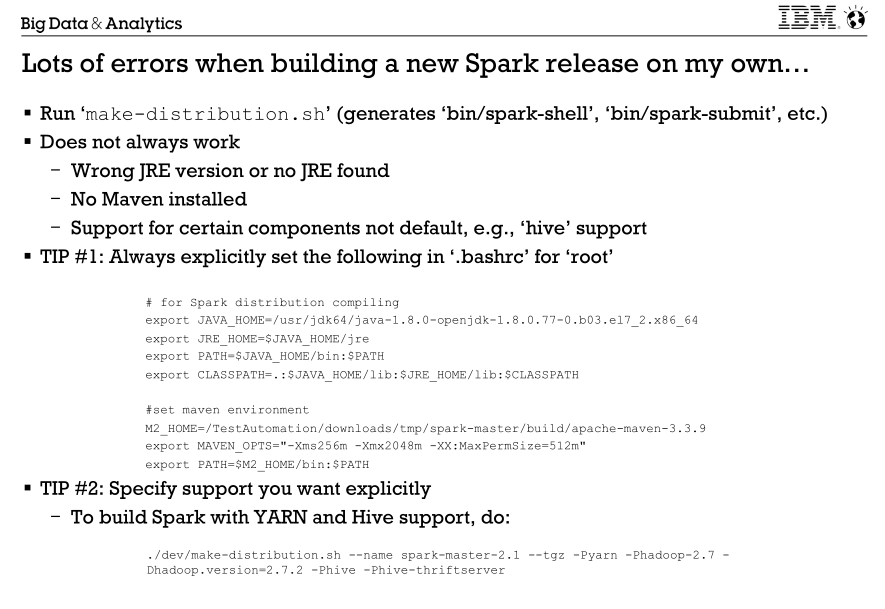
1.正确配置相关环境,如Maven,JRE
2.显示指定你要集成的功能
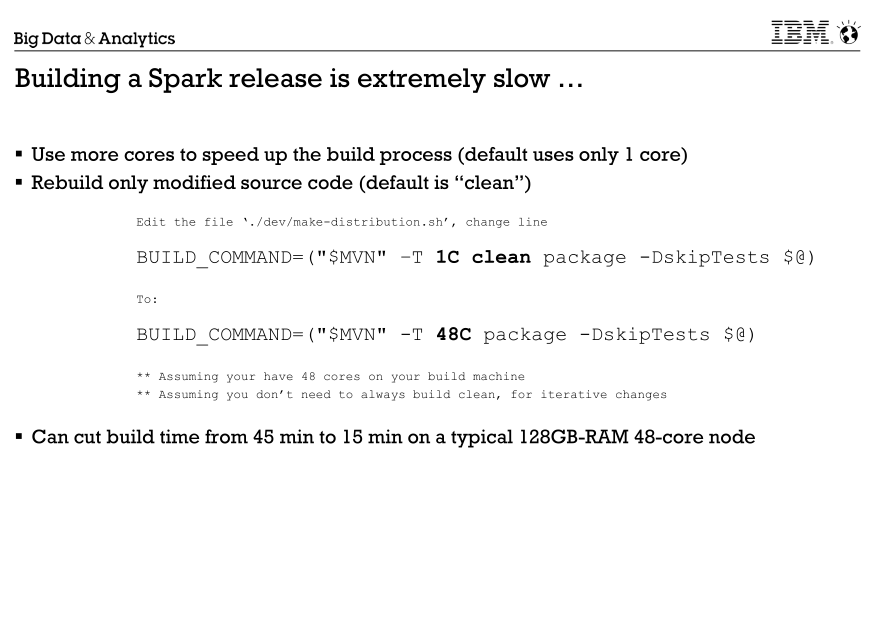
3.编译速度比较慢的话,可以根据自己的环境设置多core提高速度
spark运行时遇到的问题
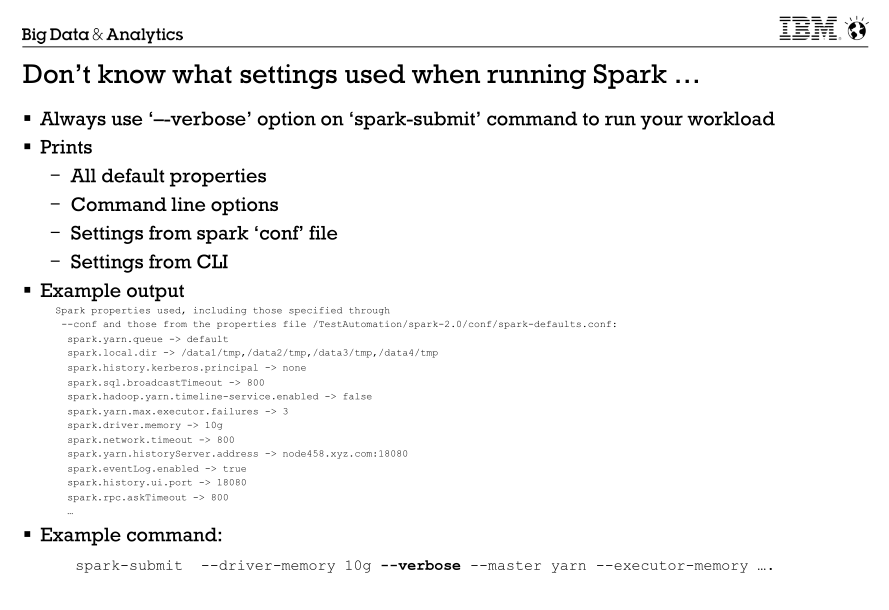
1.在不清楚spark某些配置时候,可以在spark-submit时候使用--verbose打印出当前环境具体信息
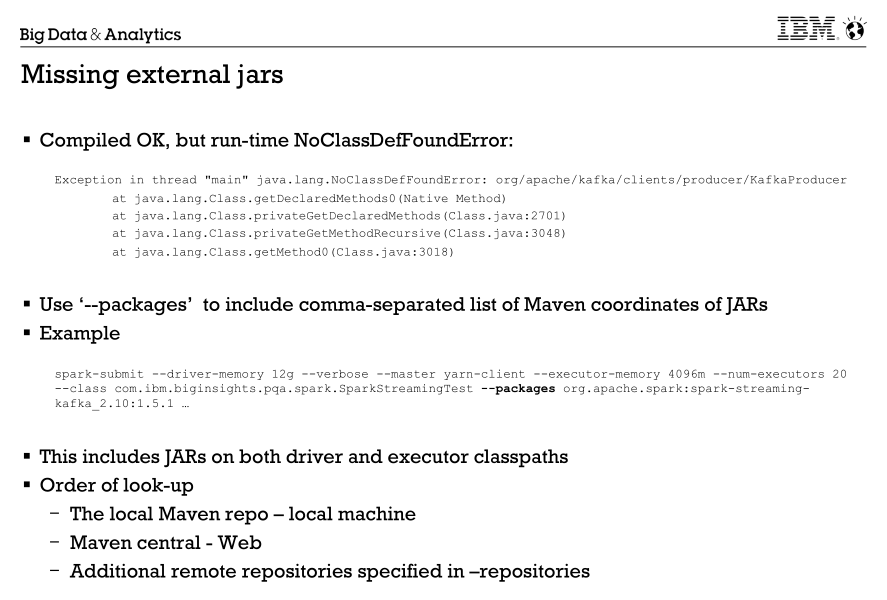
2.缺少外部jar包问题,可以使用--packages参数指定缺失的jar包,--packages会先到本地maven仓库中找指定的jar包,如果本地仓库没有,就需要外部maven仓库下载。
所以一般在生成环境,--packages不一定合适。在jar包比较少的情况下,可以通过--jars指定,比较多的话,也可以通过指定class path。这两种方式都是比较合适的
2.Spark Driver OOM,默认driver内存一般都比较小(512M),建议自己指定。这个要根据实际情况设置

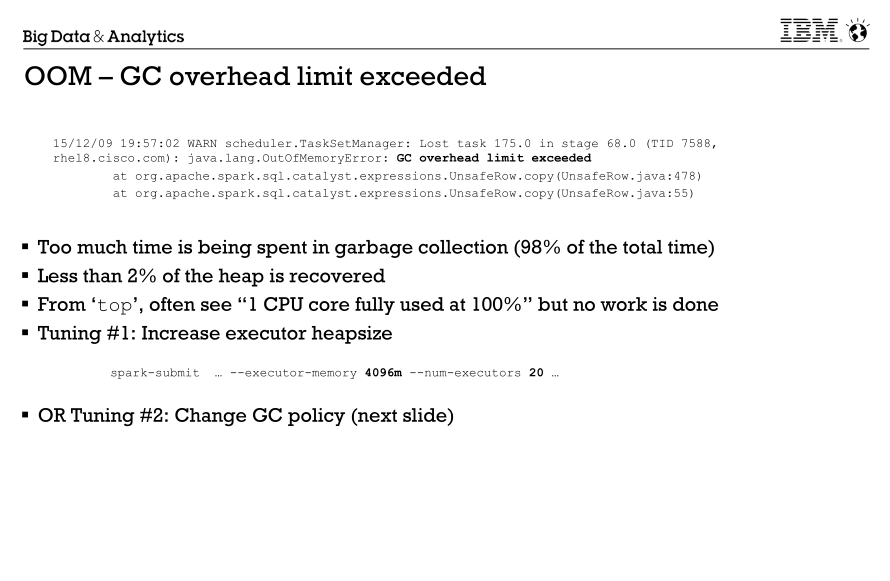
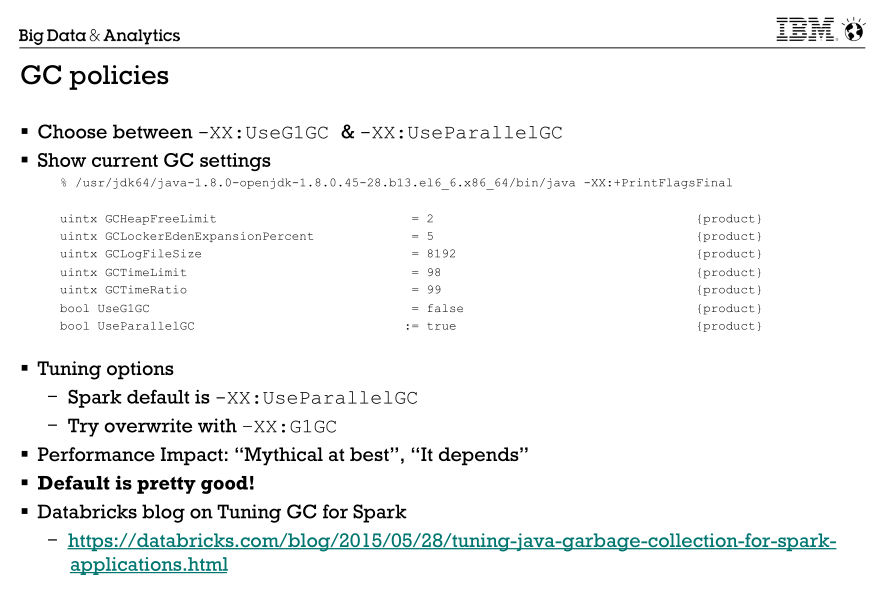
3.GC时间过长,首先应该从代码逻辑判断是否有问题,然后考虑内存是否太小,最后考虑GC算法,目前来说G1 GC是针对大堆(4G以上)首选的GC算法,databricks有一遍关于spark任务优化G1 GC的文章写的很不错,链接在下面。
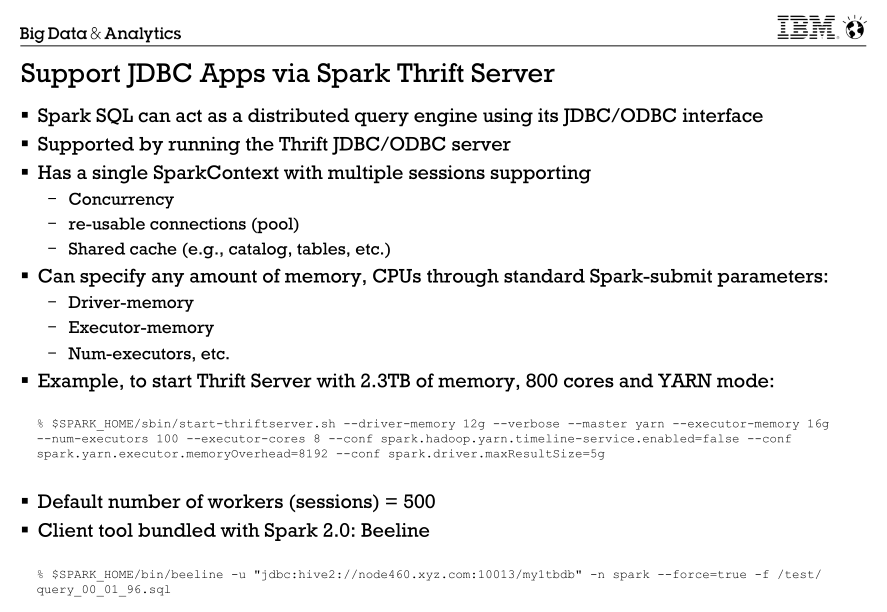
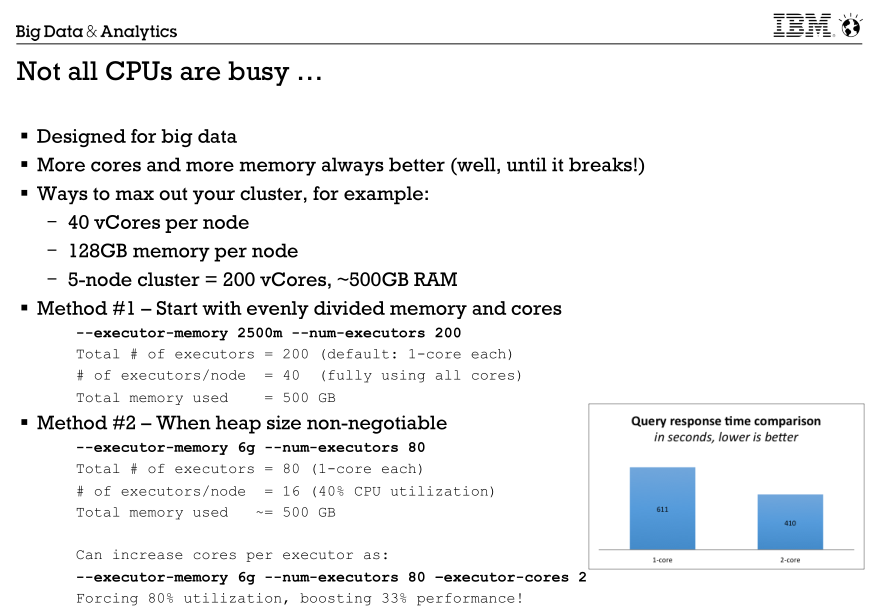
4.关于spark任务资源的问题,如何最大化利用资源
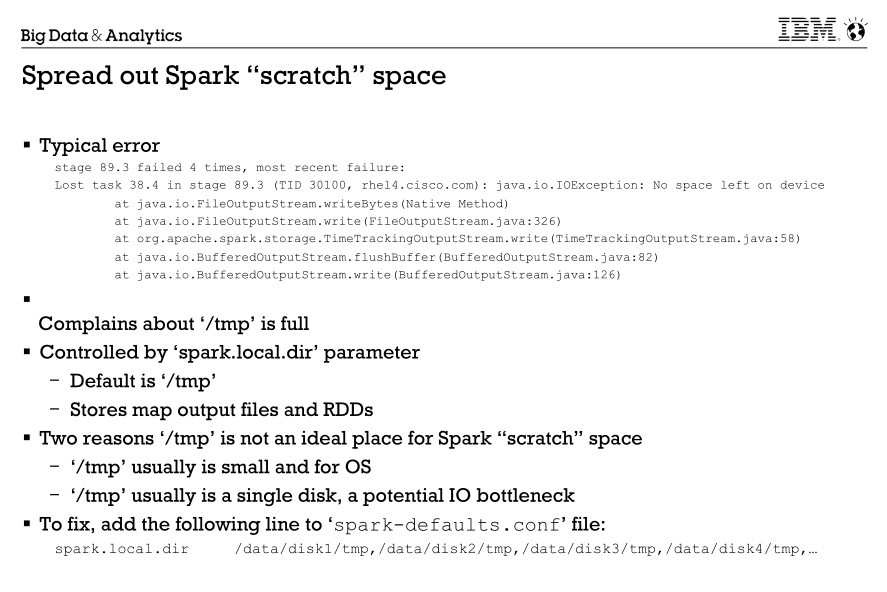
5.关于spark的"scratch" ,尽量不要使用默认的/tmp,图中描述的比较详细了。
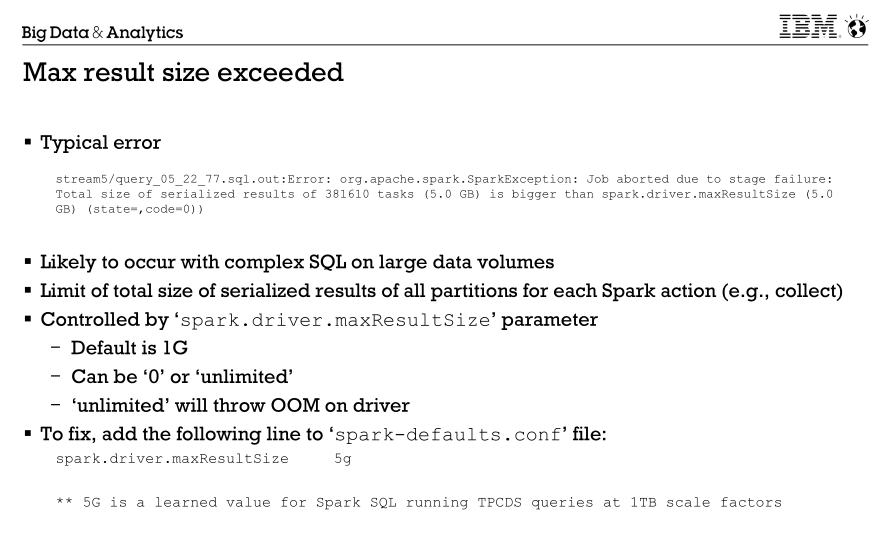
6.这种问题一般是用户在spark-sql中直接查询返回的数据量过大造成。也可能是用户应用中使用了拉取数据到driver端的API(例如:collect、show)。
解决方法:用户应该考虑拉取数据到driver端是否合理?如果不合理,增加过滤条件或者采用insert overwrite directory命令解决;如果合理,则适当增加spark.driver.maxResultSize的大小。

Spark 2.x Troubleshooting Guide的更多相关文章
- Spark SQL 之 Migration Guide
Spark SQL 之 Migration Guide 支持的Hive功能 转载请注明出处:http://www.cnblogs.com/BYRans/ Migration Guide 与Hive的兼 ...
- FNDCPASS Troubleshooting Guide For Login and Changing Applications Passwords
In this Document Goal Solution 1. Error Starting Application Services After Changing APPS Pass ...
- What To Do When MySQL Runs Out of Memory: Troubleshooting Guide
In this article, I will show you how to use the new version of MySQL (5.7+) and how to troubleshoot ...
- Spark SQL and DataFrame Guide(1.4.1)——之DataFrames
Spark SQL是处理结构化数据的Spark模块.它提供了DataFrames这样的编程抽象.同一时候也能够作为分布式SQL查询引擎使用. DataFrames DataFrame是一个带有列名的分 ...
- Spark Streaming + Kafka Integration Guide原文翻译及解析
前面写了关于kafka和spark streaming的结合使用(https://www.cnblogs.com/qfxydtk/p/11662591.html),其具体使用用法其实来自于原文:htt ...
- Java troubleshooting guide
http://www.oracle.com/technetwork/java/javase/toc-135973.html --不同的 OutOfMemoryError/内存溢出,以及相关的解决
- Troubleshooting Guide for ORA-12541 TNS: No Listener
Server side checks (not platform specific): 1) Check the result on the server using tnsping to the ...
- spark第六篇:Spark Streaming Programming Guide
预览 Spark Streaming是Spark核心API的扩展,支持高扩展,高吞吐量,实时数据流的容错流处理.数据可以从Kafka,Flume或TCP socket等许多来源获取,并且可以使用复杂的 ...
- Spark踩坑记——Spark Streaming+Kafka
[TOC] 前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark strea ...
随机推荐
- Java程序员常用工具类库
有人说当你开始学习Java的时候,你就走上了一条不归路,在Java世界里,包罗万象,从J2SE,J2ME,J2EE三大平台,到J2EE中的13中核心技术,再到Java世界中万紫千红的Framework ...
- 集合set 1
集合只能通过set() 函数进行创建 无序,不重复 每个元素必须是可哈希的,不可变类型(不可变数据类型在第一次声明赋值声明的时候, 会在内存中开辟一块空间, 用来存放这个变量被赋的值, 而 ...
- Vue 前后台交互,插件
目录 Vuex 插件 前端存储数据汇总 前后台交互方式(重点) axios 插件 同源策略-跨域问题 前后台分离项目交互流程 异步请求细节 Element-ui 插件 jQ + Bs插件 Django ...
- Day2-E-Catch That Cow-POJ3278
Farmer John has been informed of the location of a fugitive cow and wants to catch her immediately. ...
- Day4-B-最短路径问题 HDU3790
给你n个点,m条无向边,每条边都有长度d和花费p,给你起点s终点t,要求输出起点到终点的最短距离及其花费,如果最短距离有多条路线,则输出花费最少的. Input输入n,m,点的编号是1~n,然后是m行 ...
- ajax请求QQ音乐
搜索歌曲 function go() { var val = document.getElementById("name").value; ...
- 1-6SpringBoot之事务管理@Transactional
以前学ssh ssm都有事务管理service层通过applicationContext.xml配置,所有service方法都加上事务操作: 用来保证一致性,即service方法里的多个dao操作,要 ...
- 无线渗透--wifiphisher之wifi钓鱼获取wifi密码
本来是想试验一下暴力破解的,但是由于字典太大,跑的时间也比较长,于是使用了钓鱼的方法. 先说一下wifiphisher钓鱼获取wifi密码的原理: wifiphisher对于你在攻击中选定的wifi会 ...
- 动态代理,AOP和Spring
笔记 1. 什么是AOP? Aspect-Oriented Programming 面向切面编程,关注一个统一的切面,相对于OOP(面向对象编程). 适合的场景: 日志 缓存 鉴权 如果用OOP来做怎 ...
- LeetCode242 有效的字母异位词(Java字符数组排序&自定义排序记录)
题目: 给定两个字符串 s 和 t ,编写一个函数来判断 t 是否是 s 的字母异位词. 示例 1: 输入: s = "anagram", t = "nagaram& ...