
StreamSets学习系列之StreamSets的Core Tarball方式安装(图文详解)
不多说,直接上干货!
前期博客
StreamSets学习系列之StreamSets支持多种安装方式【Core Tarball、Cloudera Parcel 、Full Tarball 、Full RPM 、Docker Image和Source Code 】(图文详解)
核心安装包(Core Tarball)
该安装包包含核心的SDC软件,使该软件具有最小的软件连接器集合,当然你可以手动下载额外的节点(Stage)
① 通过Streamsets的UI进行安装,UI上点击的位置为:在该软件界面的右边(图标是一个礼物盒子。。。)。
② 也可以通过使用CLI进行安装,安装过程如下所示:
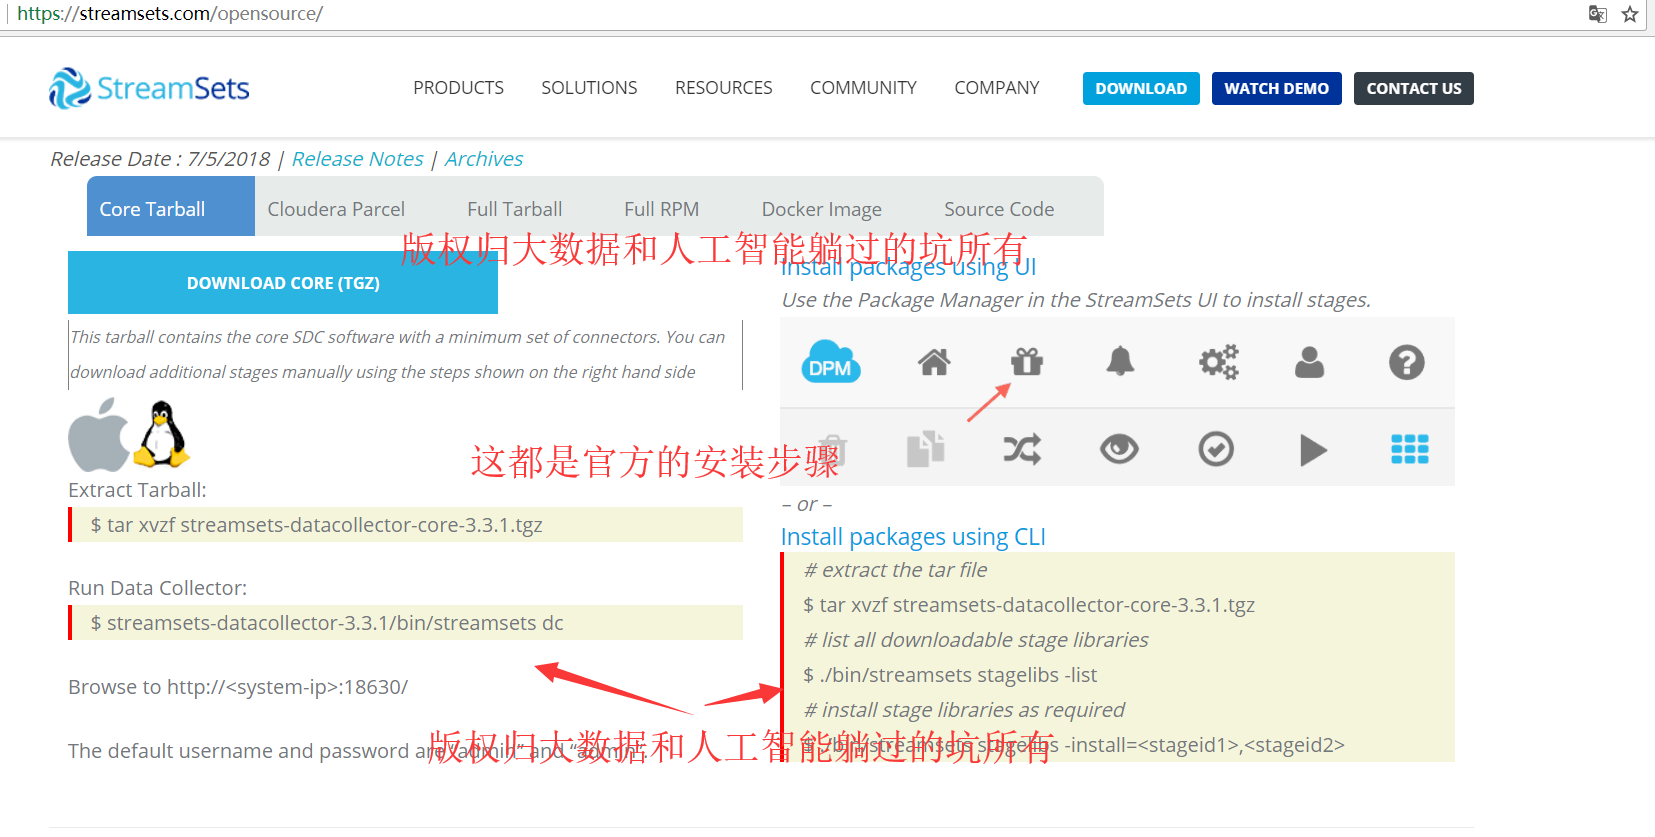
第一步、下载该【核心安装包】,比如版本为:streamsets-datacollector-core-3.3.0.tgz

第二步、解压该安装包
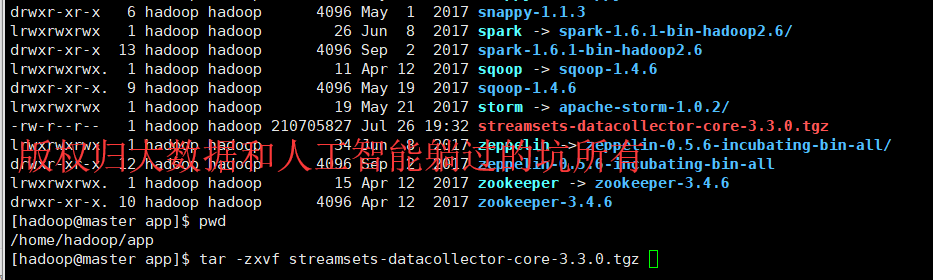
[hadoop@master app]$ tar -zxvf streamsets-datacollector-core-3.3..tgz
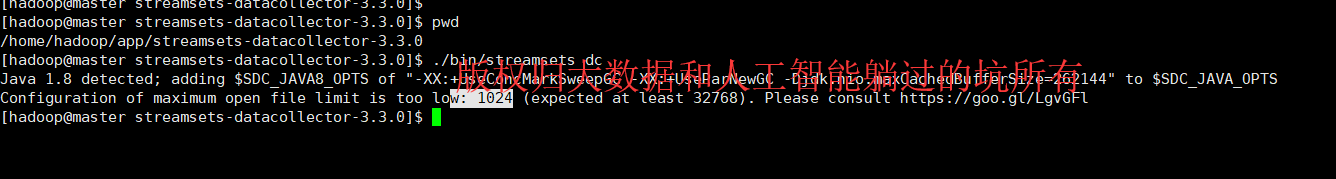
[hadoop@master streamsets-datacollector-3.3.]$ ./bin/streamsets dc

Java 1.8 detected; adding $SDC_JAVA8_OPTS of "-XX:+UseConcMarkSweepGC -XX:+UseParNewGC -Djdk.nio.maxCachedBufferSize=262144" to $SDC_JAVA_OPTS

Configuration of maximum open file limit is too low:  (expected at least ). Please consult https://goo.gl/LgvGFl

[hadoop@master streamsets-datacollector-3.3.]$
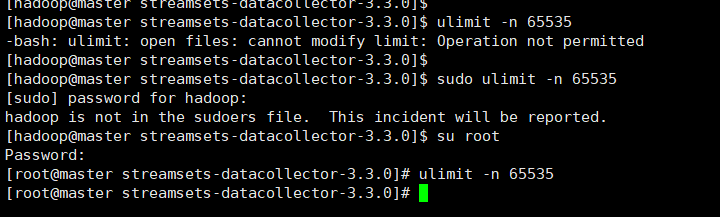
注:在这个启动的过程中会出现启动报错的情况,错误提示是:最大的文件数为1024,而streamsets需要更大的文件数,因此就要必要的设置一下环境了。
设置方式有两种:
(1)修改配置文件,然后重启centos永久生效,
(2)通过一个命令进行生效:
ulimit -n

Browse to http://<system-ip>:18630/

The default username and password are “admin” and “admin”.
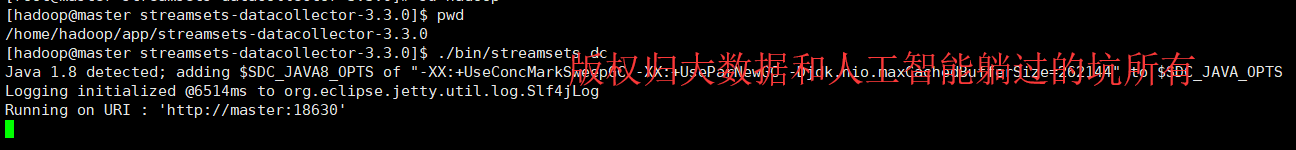
[hadoop@master streamsets-datacollector-3.3.]$ pwd

/home/hadoop/app/streamsets-datacollector-3.3.

[hadoop@master streamsets-datacollector-3.3.]$ ./bin/streamsets dc

Java 1.8 detected; adding $SDC_JAVA8_OPTS of "-XX:+UseConcMarkSweepGC -XX:+UseParNewGC -Djdk.nio.maxCachedBufferSize=262144" to $SDC_JAVA_OPTS

Logging initialized @6514ms to org.eclipse.jetty.util.log.Slf4jLog

Running on URI : 'http://master:18630'
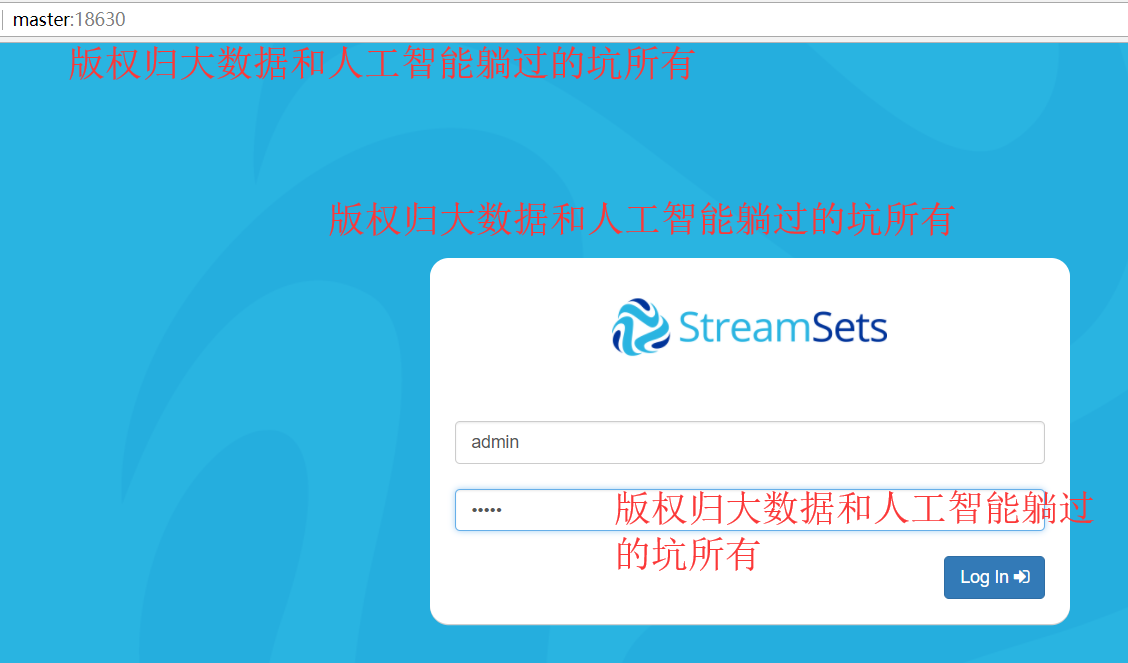
通过这种方式:你就可以看到正真的streamsets真面目了。。。。后面我们看看他真面目里面的一些细节。。。。这个工具主要进行数据移动及数据清洗有很大的帮助。
或者

[hadoop@master streamsets-datacollector-3.3.]$ pwd

/home/hadoop/app/streamsets-datacollector-3.3.

[hadoop@master streamsets-datacollector-3.3.]$ nohup /home/hadoop/app/streamsets-datacollector-3.3./bin/streamsets dc &

[]

[hadoop@master streamsets-da
也许,你在启动过程中,会出现
StreamSets学习系列之启动StreamSets时出现Caused by: java.security.AccessControlException: access denied ("java.util.PropertyPermission" "test.to.ensure.security.is.configured.correctly" "read")错误的解决办法
安装成功的后续步骤(建议去做):
1、添加sdc用户的进程操作文件描述符的并行度
[root@master streamsets-datacollector-3.3.]# vim /etc/security/limits.conf
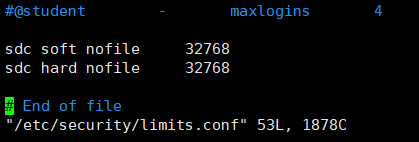
sdc soft nofile

sdc hard nofile
2、vim /etc/profile
[root@master streamsets-datacollector-3.3.]# vim /etc/profile
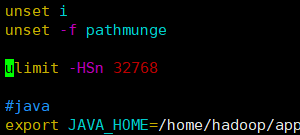
[root@master streamsets-datacollector-3.3.]# source /etc/profile
3、创建文件目录,用于放日志信息
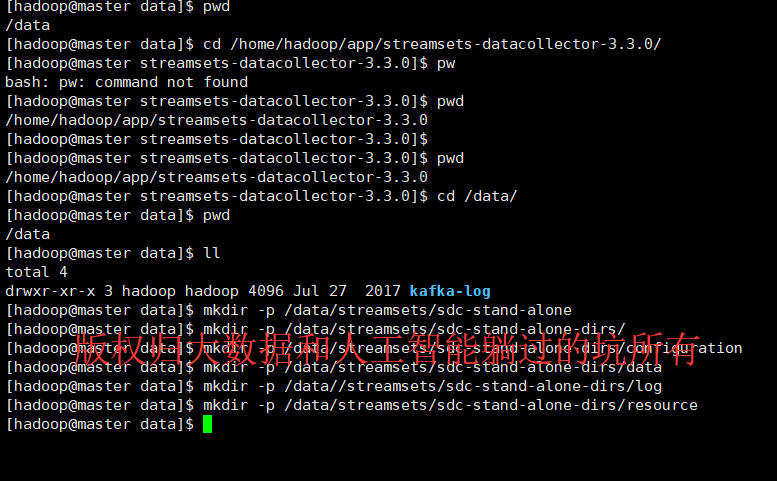
[root@master data]# su hadoop

[hadoop@master data]$ pwd

/data

[hadoop@master data]$ cd /home/hadoop/app/streamsets-datacollector-3.3./

[hadoop@master streamsets-datacollector-3.3.]$ pw

bash: pw: command not found

[hadoop@master streamsets-datacollector-3.3.]$ pwd

/home/hadoop/app/streamsets-datacollector-3.3.

[hadoop@master streamsets-datacollector-3.3.]$

[hadoop@master streamsets-datacollector-3.3.]$ pwd

/home/hadoop/app/streamsets-datacollector-3.3.

[hadoop@master streamsets-datacollector-3.3.]$ cd /data/

[hadoop@master data]$ pwd

/data

[hadoop@master data]$ ll

total

drwxr-xr-x  hadoop hadoop  Jul    kafka-log

[hadoop@master data]$ mkdir -p /data/streamsets/sdc-stand-alone

[hadoop@master data]$ mkdir -p /data/streamsets/sdc-stand-alone-dirs/

[hadoop@master data]$ mkdir -p /data/streamsets/sdc-stand-alone-dirs/configuration

[hadoop@master data]$ mkdir -p /data/streamsets/sdc-stand-alone-dirs/data

[hadoop@master data]$ mkdir -p /data/streamsets/sdc-stand-alone-dirs/log

[hadoop@master data]$ mkdir -p /data/streamsets/sdc-stand-alone-dirs/resource

[hadoop@master data]$
修改配置文件
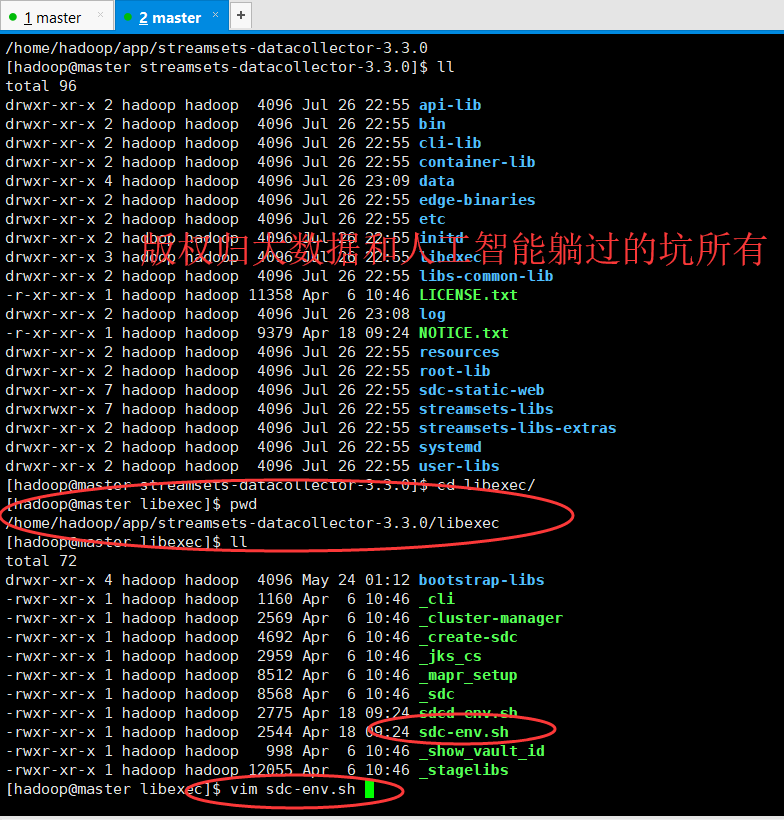
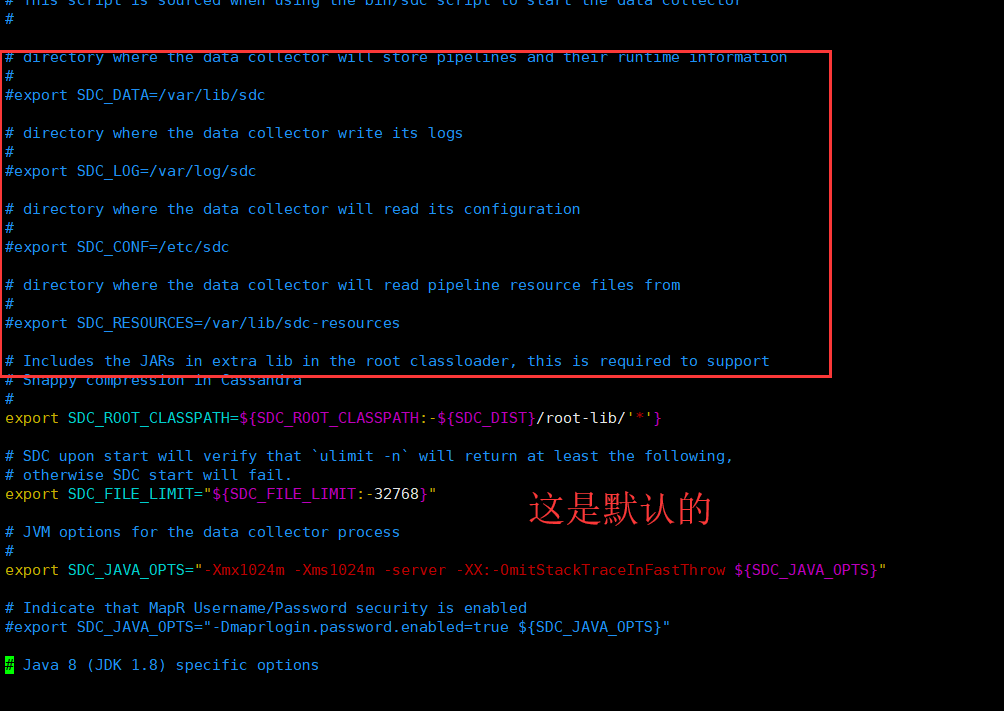
# directory where the data collector will store pipelines and their runtime information

#

#export SDC_DATA=/var/lib/sdc

# directory where the data collector write its logs

#

#export SDC_LOG=/var/log/sdc

# directory where the data collector will read its configuration

#

#export SDC_CONF=/etc/sdc

# directory where the data collector will read pipeline resource files from

#

#export SDC_RESOURCES=/var/lib/sdc-resources
改为
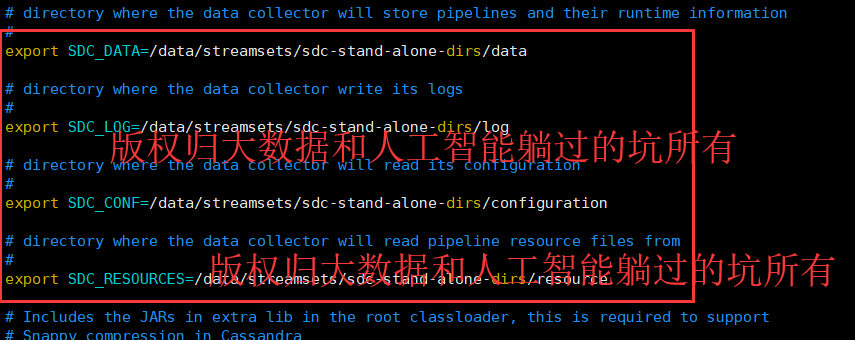
# directory where the data collector will store pipelines and their runtime information

#

export SDC_DATA=/data/streamsets/sdc-stand-alone-dirs/data

# directory where the data collector write its logs

#

export SDC_LOG=/data/streamsets/sdc-stand-alone-dirs/log

# directory where the data collector will read its configuration

#

export SDC_CONF=/data/streamsets/sdc-stand-alone-dirs/configuration

# directory where the data collector will read pipeline resource files from

#

export SDC_RESOURCES=/data/streamsets/sdc-stand-alone-dirs/resource
同时,大家可以关注我的个人博客:
http://www.cnblogs.com/zlslch/ 和 http://www.cnblogs.com/lchzls/ http://www.cnblogs.com/sunnyDream/
详情请见:http://www.cnblogs.com/zlslch/p/7473861.html
人生苦短,我愿分享。本公众号将秉持活到老学到老学习无休止的交流分享开源精神,汇聚于互联网和个人学习工作的精华干货知识,一切来于互联网,反馈回互联网。
目前研究领域:大数据、机器学习、深度学习、人工智能、数据挖掘、数据分析。 语言涉及:Java、Scala、Python、Shell、Linux等 。同时还涉及平常所使用的手机、电脑和互联网上的使用技巧、问题和实用软件。 只要你一直关注和呆在群里,每天必须有收获
对应本平台的讨论和答疑QQ群:大数据和人工智能躺过的坑(总群)(161156071)
StreamSets学习系列之StreamSets的Core Tarball方式安装(图文详解)的更多相关文章
- TortoiseGit学习系列之TortoiseGit基本操作拉取项目(图文详解)
前面博客 TortoiseGit学习系列之TortoiseGit基本操作克隆项目(图文详解) TortoiseGit学习系列之TortoiseGit基本操作修改提交项目(图文详解) TortoiseG ...
- Git学习系列之Git基本操作拉取项目(图文详解)
前面博客 Git学习系列之Git基本操作推送项目(图文详解) 当然,如果多人协作,或者多个客户端进行修改,那么我们还要拉取(Pull ... )别人推送到在线仓库的内容下来. 大神们是不推荐使用 pu ...
- TortoiseGit学习系列之TortoiseGit基本操作修改提交项目(图文详解)
前面博客 TortoiseGit学习系列之TortoiseGit基本操作克隆项目(图文详解) TortoiseGit基本操作修改提交项目 项目克隆完成后(可以将克隆 clone 理解为 下载,检出 c ...
- Git学习系列之Git基本操作推送项目(图文详解)
前面博客 Git学习系列之Git基本操作提交项目(图文详解) 如果完成到一定程度,那么可以推送到远端在线仓库. 推送之前,请确保你已经设置了全局的 user.name 和 user.email, 如果 ...
- SPSS学习系列之SPSS Statistics的菜单栏介绍(图文详解)
不多说,直接上干货! 以下是菜单栏 1.以下是文件栏: 2.以下是编辑栏 3.以下是查看栏 4.以下是数据栏: 5.以下是转换栏: 6.以下是分析栏: 7.以下是直销栏: 8.以下是图形栏: 9. ...
- StreamSets学习系列之StreamSets的集群安装(图文详解)
不多说,直接上干货! 若是集群安装 需要在对应节点执行相同的操作. 见 StreamSets学习系列之StreamSets支持多种安装方式[Core Tarball.Cloudera Parcel . ...
- StreamSets学习系列之StreamSets的Create New Pipeline(图文详解)
不多说,直接上干货! 前期博客 StreamSets学习系列之StreamSets支持多种安装方式[Core Tarball.Cloudera Parcel .Full Tarball .Full R ...
- Python操作redis学习系列之(集合)set,redis set详解 (六)
# -*- coding: utf-8 -*- import redis r = redis.Redis(host=") 1. Sadd 命令将一个或多个成员元素加入到集合中,已经存在于集合 ...
- 反射实现Model修改前后的内容对比 【API调用】腾讯云短信 Windows操作系统下Redis服务安装图文详解 Redis入门学习
反射实现Model修改前后的内容对比 在开发过程中,我们会遇到这样一个问题,编辑了一个对象之后,我们想要把这个对象修改了哪些内容保存下来,以便将来查看和追责. 首先我们要创建一个User类 1 p ...
随机推荐
- 简单MVC实现增删改查
反射工具类RelfectionUtils package Utils; import java.lang.reflect.Field; import java.lang.reflect.Invocat ...
- 单片机CPU
MCS-51的CPU由 运算部件和 控制部件构成 运算部件 包括ALU.位处理器.累加器A.暂存器.程序状态寄存器PSW.寄存器B 累加器A 一个8位累加器,A的进位标志Cy同时是位处理器的一位累加器 ...
- (转)WAMP多站点配置
转自:http://wislab.net/archives/43.html Wamp正在被广泛使用,其傻瓜式的安装配置,使得我们可以得心应手地完成以往较为烦琐的服务器环境搭建过程,直接进入到网页程序的 ...
- String、Stringbuffer、Stringbuilder三者之间的区别
1.首先说运行速度,速度由快到慢排列:StringBuilder > StringBuffer > String String最慢的原因: String为字符串常量,而StringBuil ...
- java实现在图片上编辑文本内容
package com.yin.text; import java.awt.Color; import java.awt.Font; import java.awt.Graphics2D; impor ...
- web-day11
第11章WEB11-Cookie&Session篇 今日任务 显示用户的上次访问时间 登录系统以后显示商品浏览记录 购买商品将商品添加到购物车 系统登录的验证码的校验 教学导航 教学目标 了解 ...
- 使用 ipmitool 实现远程管理Dell 系列服务器
IBM 文档: http://www.ibm.com/developerworks/cn/linux/l-ipmi/index.html ipmi命令收集: http://hi.baidu ...
- .net 使用HtmlAgilityPack做爬虫
HtmlAgilityPack官网:https://html-agility-pack.net/?z=codeplex .net中使用HtmlAgilityPack做爬虫步骤: 1.在nuget中安装 ...
- 记一次autofac+dapper+mvc的框架搭建实践
1,环境 .net framework4.7.2,Autofac,Autofac.Mvc5,sql server 2,动机 公司项目用的是ef,之前留下代码的大哥,到处using,代码没有分层,连复用 ...
- Winform下的Combox根据值来选中项
其实很简单,因为Combox的Item是一个K/V的object,那么就可以把它的items转换成IEnumerable<DictionaryEntry>类型的(System.Collec ...