
聊聊ChatGLM-6B的源码分析
基于ChatGLM-6B第一版,要注意还有ChatGLM2-6B以及ChatGLM3-6B
PrefixEncoder
作用:在微调时(以P-Tuning V2为例),方法训练时冻结模型的全部参数,只激活PrefixEncoder的参数。
其源码如下,整体来看是比较简单的。
class PrefixEncoder(torch.nn.Module):

    def __init__(self, config):

        super().__init__()

        self.prefix_projection = config.prefix_projection

        if self.prefix_projection:

            # 使用一个两层(线性层)的MLP编码prefix

            self.embedding = torch.nn.Embedding(config.pre_seq_len, config.hidden_size)

            self.trans = torch.nn.Sequential(

                torch.nn.Linear(config.hidden_size, config.hidden_size),

                torch.nn.Tanh(),

                torch.nn.Linear(config.hidden_size, config.num_layers * config.hidden_size * 2)

            )

        else:

            self.embedding = torch.nn.Embedding(config.pre_seq_len, config.num_layers * config.hidden_size * 2)

    def forward(self, prefix: torch.Tensor):

        if self.prefix_projection:

            prefix_tokens = self.embedding(prefix)

            past_key_values = self.trans(prefix_tokens)

        else:

            past_key_values = self.embedding(prefix)

        return past_key_values
为什么源码注释中会说到MLP?定位追溯:
self.mlp = GLU(

    hidden_size,

    inner_hidden_size=inner_hidden_size,

    bias=use_bias,

    layer_id=layer_id,

    params_dtype=params_dtype,

    empty_init=empty_init

)

def default_init(cls, *args, **kwargs):

    return cls(*args, **kwargs)

class GLU(torch.nn.Module):

    def __init__(self, hidden_size, inner_hidden_size=None,

                 layer_id=None, bias=True, activation_func=gelu, params_dtype=torch.float, empty_init=True):

        super(GLU, self).__init__()

        if empty_init:

            init_method = skip_init

        else:

            init_method = default_init

        self.layer_id = layer_id

        self.activation_func = activation_func

        # Project to 4h.

        self.hidden_size = hidden_size

        if inner_hidden_size is None:

            inner_hidden_size = 4 * hidden_size

        self.inner_hidden_size = inner_hidden_size

        self.dense_h_to_4h = init_method(

            torch.nn.Linear,

            self.hidden_size,

            self.inner_hidden_size,

            bias=bias,

            dtype=params_dtype,

        )

        # Project back to h.

        self.dense_4h_to_h = init_method(

            torch.nn.Linear,

            self.inner_hidden_size,

            self.hidden_size,

            bias=bias,

            dtype=params_dtype,

        )

    def forward(self, hidden_states):

        """

        hidden_states: [seq_len, batch, hidden_size]

        """

        # [seq_len, batch, inner_hidden_size]

        intermediate_parallel = self.dense_h_to_4h(hidden_states)

        intermediate_parallel = self.activation_func(intermediate_parallel)

        output = self.dense_4h_to_h(intermediate_parallel)

        return output

# 转载请备注出处:https://www.cnblogs.com/zhiyong-ITNote/
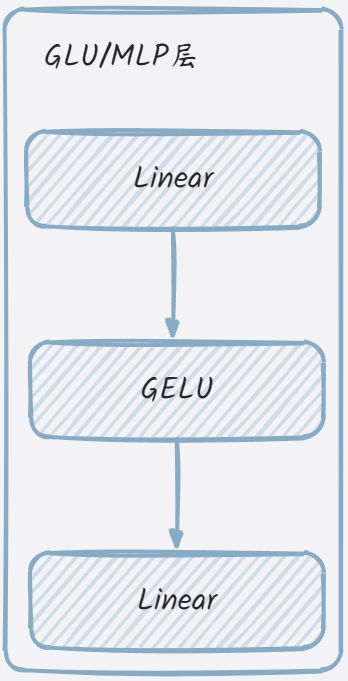
init_method对应到default_init,这个函数的作用与直接调用类构造函数相同,但它提供了一种更灵活的方式来创建类的实例,因为它可以接受任意数量的位置参数和关键字参数。在Pytorch中,用于模块化的构造函数。从源码分析来看,GLU/MLP类就是构造了两个线性层与gelu激活函数,其结构可简化如下:
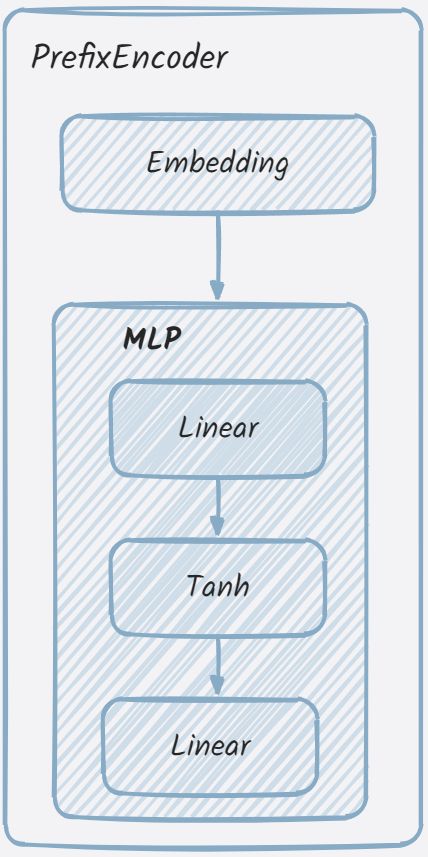
从PrefixEncoder类的初始化方法来看,其就是embedding层与MLP的组合。其结构可简化如下:
详细解读可参考 ChatGLM的模型架构
Q:在这里还有一个问题,从哪里可以定位溯源到微调时禁用了全部的参数,只激活PrefixEncoder的参数并调用了该类?
激活函数与位置编码
代码简单明了,RoPE的理论知识可以多了解。
attention_fn
伪代码表示为:
def attention_fn(

        self,

        query_layer,

        key_layer,

        value_layer,

        attention_mask,

        hidden_size_per_partition,

        layer_id,

        layer_past=None,

        scaling_attention_score=True,

        use_cache=False,

):

    xxxx
标准的注意力机制计算公式如下:


多头注意力就是将多个单头注意力的结果拼接起来,再点乘一个新的权重参数。


attention_fn函数实现了注意力的核心计算过程(即上述数学表达式),包括计算注意力分数、注意力概率和上下文层。这些计算对于实现许多自然语言处理任务,如语言建模、命名实体识别等,都是非常重要的。
SelfAttention
伪代码表示为:
class SelfAttention(torch.nn.Module):

    xxxx
attention_mask_func将注意力掩码应用于Transformer模型中的注意力得分中。
@staticmethod

def attention_mask_func(attention_scores, attention_mask):

    attention_scores.masked_fill_(attention_mask, -10000.0)

    return attention_scores
apply_rotary_pos_emb_index函数为 注入了RoPE位置信息,然后调用
attention_fn计算注意力概率、上下文层表示,并得到返回值。这些都是在forward函数中调用处理的。

最后还调用了dense对上下文表示做线性计算,返回输出。
GLU
GLU也可以理解为是MLP,在后面版本的ChatGLM中,去掉了GLU类的定义声明,直接换成了MLP。在上面已经写过不再赘述。
GLMBlock
一般都会把GLMBlock对应为transformer结构的实现。从其构造函数来看,主要是拼接各个层到一起。
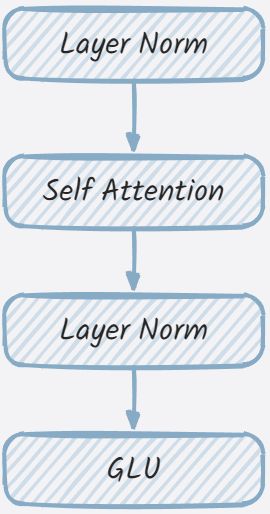
从代码来看,中间有两次的残差连接,如下所示
# Residual connection.

alpha = (2 * self.num_layers) ** 0.5

hidden_states = attention_input * alpha + attention_output

mlp_input = self.post_attention_layernorm(hidden_states)

# MLP.

mlp_output = self.mlp(mlp_input)

# Second residual connection.

output = mlp_input * alpha + mlp_output
ChatGLMPreTrainedModel
TODO....
ChatGLMModel
TODO....
聊聊ChatGLM-6B的源码分析的更多相关文章
- 【小家Spring】聊聊Spring中的数据绑定 --- DataBinder本尊(源码分析)
每篇一句 唯有热爱和坚持,才能让你在程序人生中屹立不倒,切忌跟风什么语言或就学什么去~ 相关阅读 [小家Spring]聊聊Spring中的数据绑定 --- 属性访问器PropertyAccessor和 ...
- HashMap实现原理及源码分析
哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技术(比如memcached)的核心其实就是在内存中维护一张大的哈希表,而HashMap的实现原理也常常出 ...
- TextView 的新特性,Autosizing 到底是如何实现的? | 源码分析
一.前言 Hi,大家好,我是承香墨影! 前两天聊了一下 Autosizing 的使用,反映还不错.毕竟是这种能解决实际问题的新 Api,确实在需要的时候,用起来会很顺手. 简单回顾一下,Autosiz ...
- HashMap和ConcurrentHashMap实现原理及源码分析
HashMap实现原理及源码分析 哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技术(比如memcached)的核心其实就是在内存中维护一张大的哈希表, ...
- HashMap实现原理及源码分析(JDK1.7)
转载:https://www.cnblogs.com/chengxiao/p/6059914.html 哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技 ...
- Dubbo 源码分析 - SPI 机制
1.简介 SPI 全称为 Service Provider Interface,是 Java 提供的一种服务发现机制.SPI 的本质是将接口实现类的全限定名配置在文件中,并由服务加载器读取配置文件,加 ...
- 转载-HashMap1.7源码分析
原文地址-https://www.cnblogs.com/chengxiao/p/6059914.html HashMap实现原理及源码分析 哈希表(hash table)也叫散列表,是一种非常重 ...
- MyBatis 源码分析系列文章导读
1.本文速览 本篇文章是我为接下来的 MyBatis 源码分析系列文章写的一个导读文章.本篇文章从 MyBatis 是什么(what),为什么要使用(why),以及如何使用(how)等三个角度进行了说 ...
- EasyUI学习总结(三)——easyloader源码分析(转载)
声明:这一篇文章是转载过来的,转载地址忘记了,原作者如果看到了,希望能够告知一声,我好加上去! easyloader模块是用来加载jquery easyui的js和css文件的,而且它可以分析模块的依 ...
- HashMap实现原理及源码分析之JDK7
攻克集合第一关!! 转载 http://www.cnblogs.com/chengxiao/ 哈希表(hash table)也叫散列表,是一种非常重要的数据结构,应用场景及其丰富,许多缓存技术(比如m ...
随机推荐
- Go 1.22 中的 For 循环
原文在这里. 由 David Chase and Russ Cox 发布于2023年9月19日 Go 1.21 版本包含了对 for 循环作用域的预览更改,我们计划在 Go 1.22 中发布此更改,以 ...
- 一种对数据库友好的GUID的变种使用方法
概述 .NET生成的GUID唯一性很好,用之方便,但是,缺少像雪花算法那样的有序性.虽然分布式系统中做不到绝对的有序,但是,相对的有序对于目前数据库而言,索引效率等方面的提升还是有明显效果的(当然,我 ...
- 深挖 Python 元组 pt.1
哈喽大家好,我是咸鱼 好久不见甚是想念,2023 年最后一次法定节假日已经结束了,不知道各位小伙伴是不是跟咸鱼一样今天就开始"搬砖"了呢? 我们知道元组(tuple)是 Pytho ...
- jmeter生成随机英文的几种方法
第一种:用BeanShell后置处理程序 1.写脚本 import java.util.Random; String random(int s_length) { strings= &qu ...
- 采用ResNet网络+TSNE降维算法对自建图像数据集进行二维可视化显示
起因:某一天下午,我在"玩"的时候,突然接到了老板的电话,说是要对图像做可视化降维.因此,我拿到了一批图像的数据. 数据的特点: 1.数据集的图像分为4类,并且每一种类的图像多少不 ...
- oracle 命令4 热备份
热备份:不停数据库,一定范围内(内存写满后,用户操作挂起),不影响用户使用.数据库开着,时刻变化,因此热备份通过以下手段保持一致性:1.开启归档2.备份前,通知数据库,把文件锁定,在备份未完成前,不操 ...
- 从一次Kafka宕机说起(JVM hang)
一.背景 时间大概是在夏天7月份,突然收到小伙伴的情报,我们线上的一个kafka实例的某个broker突然不提供服务了,也没看到什么异常日志,反正就是生产.消费都停了.因为是线上服务,而且进程还在,就 ...
- Codeforces Round 823 (Div. 2)C
C. Minimum Notation 思路:我们可以进行的操作时将一个位置的数删除然后在任意位置处添加一个比当前数大1并且小于9的数,所以我们的操作只会让一个数变大,我们统计一个最大值的后缀,贪心的 ...
- AttributeError: module 'sqlalchemy' has no attribute '__all__'
升级组件 pip install --upgrade flask-sqlalchemy
- [Python急救站课程]简单的人机对话
一个简单的人机对话程序 name = input("输入姓名:") # input输入数据 print("{}同学,学好Python,前途无量!".format ...