
LightGBM和XGBoost的区别?
首先声明,LightGBM是针对大规模数据(样本量多,特征多)时,对XGBoost算法进行了一些优化,使得速度有大幅度提高,但由于优化方法得当,而精度没有减少很多或者变化不大,理论上还是一个以精度换速度的目的。如果数据量不大,那就对XGBoost没有什么优势了。
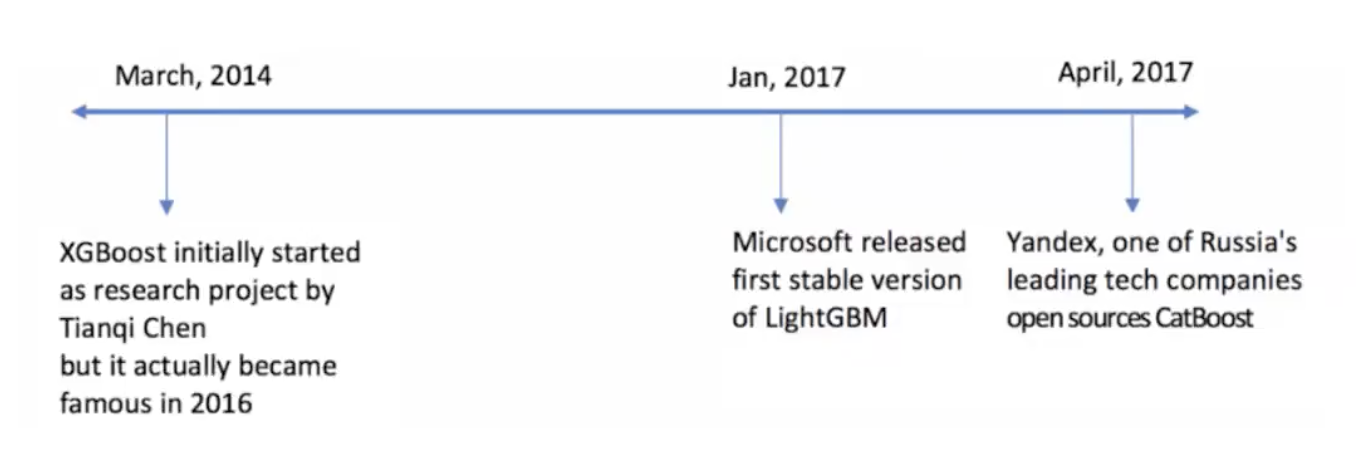
我认为有这几点:
1.GOSS(Gradient-based One-Side Sampling),基于梯度的单侧采样,对训练样本的采样。
如原始训练数据100w,高梯度数据有1w,那么会计算 1w+随机选择b%*余下的99w数据,然后把后部分数据进行加倍(*(1-a)/b),基于这些数据来得到特征的切分点。
2.EFB(Exclusive Feature Bundling),排斥特征整合,通过对某些特征整合来降低特征数量。
上面两点是在原论文中多次提到的,主要的不同。
参考原论文:https://papers.nips.cc/paper/6907-lightgbm-a-highly-efficient-gradient-boosting-decision-tree.pdf
其它的我认为还有两点:
3.查找连续变量 切分点 的方法
XGBoost默认使用的是pre-sorted algorithm,即先将连续变量排序,然后从前向后计算每个切分点后的信息增益,这样算法复杂度是#data*#feature。好像也可以支持使用histogram。
LightGBM使用的是histogram-based algorithms,即将连续值先bin成k箱,然后再求切分点,每次计算切分点的复杂度是#k*#feature,但这样会有一些精度损失。但由于,a粗精度可以相当于正则化的效果,防止过拟合。b单棵树的精度可能会差一些,但在gbdt框架下,总体的效果不一定差。c在gbdt中决策树是弱模型,精度不高影响也不大。
4.树的生长方式
XGBoost是level(depdh)-wise,即左右子树都是一样深的,要生长一块生长,要停一块停。
LightGBM是leaf-wise,即可能左右子树是不一样深的,即使左子树已经比右子树深很多,但只要左子树的梯度划分仍然比右子树占优,就继续在左子树进行划分。

5、对类别特征的支持
实际上大多数机器学习工具都无法直接支持类别特征,一般需要把类别特征,转化到多维的0/1 特征,降低了空间和时间的效率。而类别特征的使用是在实践中很常用的。基于这个考虑,LightGBM 优化了对类别特征的支持,可以直接输入类别特征,不需要额外的0/1 展开。并在决策树算法上增加了类别特征的决策规则。在 Expo 数据集上的实验,相比0/1 展开的方法,训练速度可以加速 8 倍,并且精度一致。据我们所知,LightGBM 是第一个直接支持类别特征的 GBDT 工具。
参考:https://blog.csdn.net/friyal/article/details/82756777
LightGBM和XGBoost的区别?的更多相关文章
- 随机森林RF、XGBoost、GBDT和LightGBM的原理和区别
目录 1.基本知识点介绍 2.各个算法原理 2.1 随机森林 -- RandomForest 2.2 XGBoost算法 2.3 GBDT算法(Gradient Boosting Decision T ...
- LightGBM大战XGBoost,谁将夺得桂冠?
引 言 如果你是一个机器学习社区的活跃成员,你一定知道 提升机器(Boosting Machine)以及它们的能力.提升机器从AdaBoost发展到目前最流行的XGBoost.XGBoost实际上已经 ...
- GBDT XGBOOST的区别与联系
Xgboost是GB算法的高效实现,xgboost中的基学习器除了可以是CART(gbtree)也可以是线性分类器(gblinear). 传统GBDT以CART作为基分类器,xgboost还支持线性分 ...
- 机器学习算法中GBDT和XGBOOST的区别有哪些
首先xgboost是Gradient Boosting的一种高效系统实现,并不是一种单一算法.xgboost里面的基学习器除了用tree(gbtree),也可用线性分类器(gblinear).而GBD ...
- RF,GBDT,XGBoost,lightGBM的对比
转载地址:https://blog.csdn.net/u014248127/article/details/79015803 RF,GBDT,XGBoost,lightGBM都属于集成学习(Ensem ...
- XGBoost、LightGBM、Catboost总结
sklearn集成方法 bagging 常见变体(按照样本采样方式的不同划分) Pasting:直接从样本集里随机抽取的到训练样本子集 Bagging:自助采样(有放回的抽样)得到训练子集 Rando ...
- 机器学习-树模型理论(GDBT,xgboost,lightBoost,随机森林)
tree based ensemble algorithms 主要介绍以下几种ensemble的分类器(tree based algorithms) xgboost lightGBM: 基于决策树算法 ...
- xgboost gbdt特征点分烈点
lightGBM与XGBoost的区别:(来源于:http://baijiahao.baidu.com/s?id=1588002707760744935&wfr=spider&for= ...
- L2R 三:常用工具包介绍之 XGBoost与LightGBM
L2R最常用的包就是XGBoost 和LightGBM,xgboost因为其性能及快速处理能力,在机器学习比赛中成为常用的开源工具包, 2016年微软开源了旗下的lightgbm(插句题外话:微软的人 ...
随机推荐
- ArchLinux安装(BIOS)
ArchLinux安装(BIOS) 说在前头:在经历过无数次的失败尝试过后总结出的可用的安装过程(比官方的简单一点) 官方安装指导 一.连接网络 1.连接 # wifi-menu 2.检查是否联通 ( ...
- GPU 、APU、CUDA、TPU、FPGA介绍
购买显卡主要关注:显存.带宽和浮点运算数量 GPU :图形处理器(英语:Graphics Processing Unit,缩写:GPU),又称显示核心.视觉处理器.显示芯片,是一种专门在个人电脑. ...
- trove module使用说明
原文来自:https://github.com/openstack/openstack-manuals/blob/master/doc/user-guide/source/database-modul ...
- pytorch 自动求梯度
自动求梯度 在深度学习中,我们经常需要对函数求梯度(gradient).PyTorch提供的autograd包能够根据输入和前向传播过程自动构建计算图,并执行反向传播.本节将介绍如何使用autogra ...
- c++ 排序 冒泡 插入 选择 快速
//冒泡 #include <iostream> using namespace std; void bubbleSort(int* list,int index) { ;i--) //i ...
- HTTPS(身披SSL协议的HTTP)
参考链接: HTTP 与 HTTPS 的区别 HTTPS科普扫盲帖 HTTPS小结 HTTP 和 HTTPS 区别 HTTP是明文传输未加密,安全性差,HTTPS(HTTP + SSL)数据传输是加密 ...
- PAT Advanced 1123 Is It a Complete AVL Tree (30) [AVL树]
题目 An AVL tree is a self-balancing binary search tree. In an AVL tree, the heights of the two child ...
- 转载:Apache优化:修改最大并发连接数
本文转自:https://blog.csdn.net/bjash/article/details/50394894 Apache是一个跨平台的web服务器,由于其简单.稳定安全的特性,被广泛应用于计算 ...
- 2020 年最流行的 Java 开发技术
不知不觉间,2020 年即将于十几天之后到来,作为技术圈中你,准备好迎接最新的变化了吗?在本文中,我们将以编程界最常用的编程语言 Java 为例,分享最为主流的技术与工具. 作者 | divyesh. ...
- Object arrays cannot be loaded when allow_pickle=False
问题再现 代码是Deep Learning with Python中的: from keras.datasets import imdb (train_data, train_labels), (te ...