
node.js基础模块http、网页分析工具cherrio实现爬虫
node.js基础模块http、网页分析工具cherrio实现爬虫
一、前言
说是爬虫初探,其实并没有用到爬虫相关第三方类库,主要用了node.js基础模块http、网页分析工具cherrio。 使用http直接获取url路径对应网页资源,然后使用cherrio分析。 这里我主要学习过的案例自己敲了一遍,加深理解。在coding的过程中,我第一次把jq获取后的对象直接用forEach遍历,直接报错,是因为jq没有对应的这个方法,只有js数组可以调用。
二、知识点
①:superagent抓去网页工具。我暂时未用到。
②:cherrio 网页分析工具,你可以理解其为服务端的jQuery,因为语法都一样。
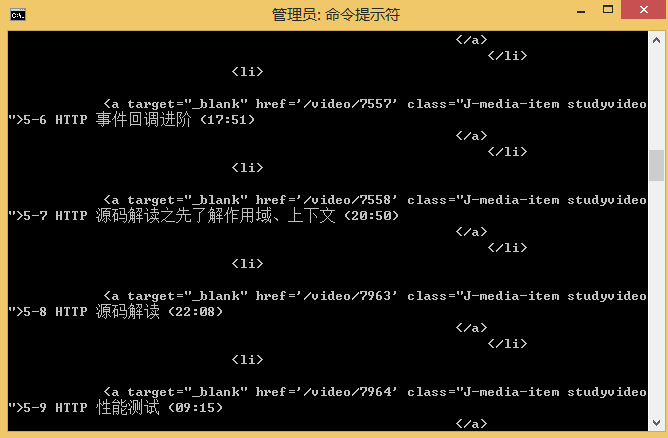
效果图
1、抓取整个网页
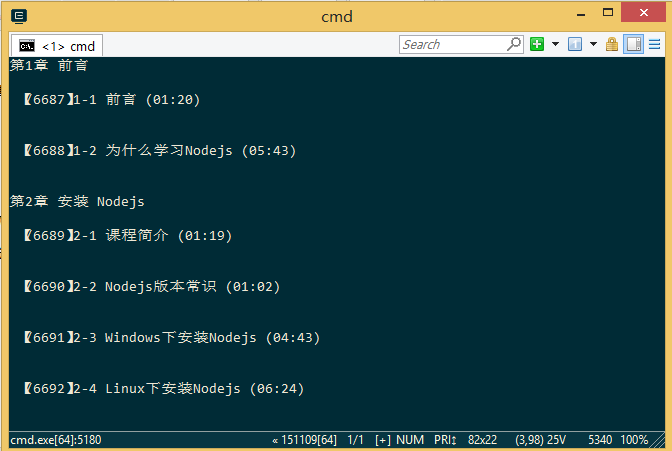
2、分析后的数据,提供的示例为案例实现的例子。
爬虫初探源码分析
var http=require('http');
var cheerio=require('cheerio');

var url='http://www.imooc.com/learn/348';

/****************************
打印得到的数据结构
[{
 chapterTitle:'',
 videos:[{
  title:'',
  id:''
 }]
}]
********************************/
function printCourseInfo(courseData){
 courseData.forEach(function(item){
  var chapterTitle=item.chapterTitle;
  console.log(chapterTitle+'\n');
  item.videos.forEach(function(video){
   console.log(' 【'+video.id+'】'+video.title+'\n');
  })
 });
}

/*************
分析从网页里抓取到的数据
**************/
function filterChapter(html){
 var courseData=[];

 var $=cheerio.load(html);
 var chapters=$('.chapter');
 chapters.each(function(item){
  var chapter=$(this);
  var chapterTitle=chapter.find('strong').text(); //找到章节标题
  var videos=chapter.find('.video').children('li');

  var chapterData={
   chapterTitle:chapterTitle,
   videos:[]
  };

  videos.each(function(item){
   var video=$(this).find('.studyvideo');
   var title=video.text();
   var id=video.attr('href').split('/video')[1];

   chapterData.videos.push({
    title:title,
    id:id
   })
  })

  courseData.push(chapterData);
 });

 return courseData;
}

http.get(url,function(res){
 var html='';

 res.on('data',function(data){
  html+=data;
 })

 res.on('end',function(){
  var courseData=filterChapter(html);
  printCourseInfo(courseData);
 })
}).on('error',function(){
 console.log('获取课程数据出错');
})
参考资料:
https://github.com/alsotang/node-lessons/tree/master/lesson3
node.js基础模块http、网页分析工具cherrio实现爬虫的更多相关文章
- Node.js Web模块
什么是Web服务器? Web服务器是处理由HTTP客户端发送的,如web浏览器的HTTP请求的软件应用程序,并返回响应于客户端网页. Web服务器通常伴随着图片,样式表和脚本的HTML文档. 大多数W ...
- Node.js基础知识
Node.js入门 Node.js Node.js是一套用来编写高性能网络服务器的JavaScript工具包,一系列的变化由此开始.比较独特的是,Node.js会假设在POSIX环境下运行 ...
- 进击Node.js基础(二)
一.一个牛逼闪闪的知识点Promise npm install bluebird 二.Promise实例 ball.html <!doctype> <!DOCTYPE html> ...
- Node.js之模块机制
> 文章原创于公众号:程序猿周先森.本平台不定时更新,喜欢我的文章,欢迎关注我的微信公众号.  ...
随机推荐
- Linux守护进程详解(init.d和xinetd)
一 Linux守护进程 Linux 服务器在启动时需要启动很多系统服务,它们向本地和网络用户提供了Linux的系统功能接口,直接面向应用程序和用户.提供这些服务的程序是由运行在后台的守护进程来执行的. ...
- xml写代码
#include <QDomDocument> #include <QtGui> int main(int argc, char *argv[]) { QApplication ...
- Java基础知识强化之集合框架笔记38:Set集合之Set集合概述和特点
1. Set集合概述和特点 Collection |--List 有序(存储顺序和取出顺序一致),可重复 |--Se ...
- 事件触发函数中的this,target,currentTarget,srcElement
要解释其中的区别,首先要理解浏览器的事件机制, 现在主流的浏览器事件基本是先捕获再冒泡,IE浏览器只有冒泡阶段 事件是在冒泡阶段触发的 看看这个HTML 当我点击"我是父节点的时候" ...
- 常用的 css 命名规则
头:header 内容:content/container 尾:footer 导航:nav 侧栏:sidebar 栏目:column 页面外围控制整体布局宽度:wrapper 左右中:left rig ...
- PropertyPlaceholderConfigurer的用法(使用spring提供的类读取数据库配置信息.properties)
http://www.cnblogs.com/wanggd/archive/2013/07/04/3172042.html(写的很好)
- 10集合:List<T>,Dictionary<K,V>
List<T>泛型集合 List<T>是C#中一种快捷.易于使用的泛型集合类型,使用泛型编程为编写面向对象程序增加了极大的效率和灵活性. 1.List<T>用法 ...
- Spring 实例化bean的方式
实例化bean的方式有三种: 1.用构造器来实例化 2.使用静态工厂方法实例化 3.使用实例工厂方法实例化 当采用构造器来创建bean实例时,Spring对class并没有特殊的要求, 我们通常使用的 ...
- python3 读取大文件分解成若干小文件
有个数据实在太大了,有1.7G,打开慢,改文件也慢,我们将其分解成若干个中等文件 #!/usr/bin/env python3 # -*- coding: utf-8 -*- f = open(& ...
- 人人网FED CSS编码前端开发规范
文件相关规范 1.文件名必须由小写字母.数字.中划线-组成 2.文件必须用utf-8编码 3.文件引入可通过外联或内联方式引入: 3.1 外联方式:<link rel=”stylesheet” ...