
Python之-爬虫
1、得到页面的HTML代码


第一个参数是URL
第二三个参数可以不传送,数据和时间
2、request请求
HTTP是基于请求和应答的,客户端发出请求,服务端做出响应,所以urllib2创建一个request对象,代表发送的HTTP请求。

3、数据传送POST和GET
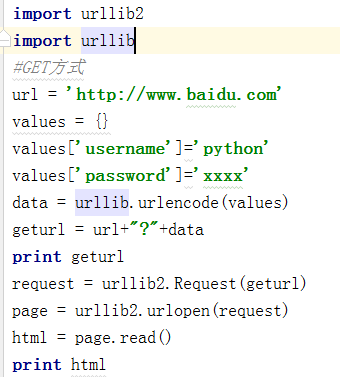
GET方式
直接把参数写到URL当中。
和我们平常GET访问方式一模一样,用一个问号连接传送的数据
POST方式

4、Headers
有些网站不会同意程序直接用上面的方式进行访问,如果识别有问题,那么站点根本不会响应,所以为了完全模拟浏览器的工作,我们需要设置一些Headers 的属性。

5、异常处理
【1】URLEeeor
产生的原因:
网络无连接
服务器不存在
连接不到服务器
在代码中,我们需要用try-except语句来包围并捕获相应的异常

【2】HTTPEeeor
每个来自服务器的HTTP应答都包含一个数值的状态码。有时候,状态码表明服务器不能满足我们做出的请求。默认的handlers将会帮我们处理一些应答(例如,应答是一个重定向,要求客户端从不同的URL抓取资源,urllib2将会替你处理好)。但是总有一些不能处理好,urloprn将会抛出一个HTTPError异常。典型的异常有404(页面丢失),403(请求被禁止),401(要求验证)


注意,HTTPError一定要放在最前面进行捕获。因为HTTPError是URLError的子集,不然的话会一直捕获到的是URLError

6、Cookie
Cookie,指某些网站为了辨别用户身份、进行session跟踪而储存在用户本地终端上的数据(通常经过加密)
比如说有些网站需要登录后才能访问某个页面,在登录之前,你想抓取某个页面内容是不允许的。那么我们可以利用Urllib2库保存我们登录的Cookie,然后再抓取其他页面就达到目的了。
但是URLopen只接受三个参数:url、data、timeout
urllib2库.官方文档翻译 - 莫利斯安的博客 - 博客频道 - CSDN.NET http://blog.csdn.net/u014343243/article/details/49308043
Python之-爬虫的更多相关文章
- Python简单爬虫入门三
我们继续研究BeautifulSoup分类打印输出 Python简单爬虫入门一 Python简单爬虫入门二 前两部主要讲述我们如何用BeautifulSoup怎去抓取网页信息以及获取相应的图片标题等信 ...
- Ubuntu下配置python完成爬虫任务(笔记一)
Ubuntu下配置python完成爬虫任务(笔记一) 目标: 作为一个.NET汪,是时候去学习一下Linux下的操作了.为此选择了python来边学习Linux,边学python,熟能生巧嘛. 前期目 ...
- Python简单爬虫入门二
接着上一次爬虫我们继续研究BeautifulSoup Python简单爬虫入门一 上一次我们爬虫我们已经成功的爬下了网页的源代码,那么这一次我们将继续来写怎么抓去具体想要的元素 首先回顾以下我们Bea ...
- [Python] 网络爬虫和正则表达式学习总结
以前在学校做科研都是直接利用网上共享的一些数据,就像我们经常说的dataset.beachmark等等.但是,对于实际的工业需求来说,爬取网络的数据是必须的并且是首要的.最近在国内一家互联网公司实习, ...
- python简易爬虫来实现自动图片下载
菜鸟新人刚刚入住博客园,先发个之前写的简易爬虫的实现吧,水平有限请轻喷. 估计利用python实现爬虫的程序网上已经有太多了,不过新人用来练手学习python确实是个不错的选择.本人借鉴网上的部分实现 ...
- GJM : Python简单爬虫入门(二) [转载]
感谢您的阅读.喜欢的.有用的就请大哥大嫂们高抬贵手"推荐一下"吧!你的精神支持是博主强大的写作动力以及转载收藏动力.欢迎转载! 版权声明:本文原创发表于 [请点击连接前往] ,未经 ...
- Python分布式爬虫原理
转载 permike 原文 Python分布式爬虫原理 首先,我们先来看看,如果是人正常的行为,是如何获取网页内容的. (1)打开浏览器,输入URL,打开源网页 (2)选取我们想要的内容,包括标题,作 ...
- Python 网页爬虫 & 文本处理 & 科学计算 & 机器学习 & 数据挖掘兵器谱(转)
原文:http://www.52nlp.cn/python-网页爬虫-文本处理-科学计算-机器学习-数据挖掘 曾经因为NLTK的缘故开始学习Python,之后渐渐成为我工作中的第一辅助脚本语言,虽然开 ...
- 关于Python网络爬虫实战笔记③
Python网络爬虫实战笔记③如何下载韩寒博客文章 Python网络爬虫实战笔记③如何下载韩寒博客文章 target:下载全部的文章 1. 博客列表页面规则 也就是, http://blog.sina ...
- 关于Python网络爬虫实战笔记①
python网络爬虫项目实战笔记①如何下载韩寒的博客文章 python网络爬虫项目实战笔记①如何下载韩寒的博客文章 1. 打开韩寒博客列表页面 http://blog.sina.com.cn/s/ar ...
随机推荐
- python魔法方法__reduce__()的妙用
一.__reduce__()介绍 当定义扩展类型时(也就是使用Python的C语言API实现的类型),如果你想pickle它们,你必须告诉Python如何pickle它们. __reduce__ 被定 ...
- JS删除对象属性
项目中有些属性使用之后需要重置 var user = {}; user.name = "123"; user.age="30"; console.log(use ...
- 嵌入式C语言3.4 关键字---类型描述符auto/register/static/const/extern/volatile/
对内存资源存放位置的限定 1. auto 默认值---分配的内存都是可读可写的区域 auto int a; 区域如果出现 {} 我们认为在栈空间 2. register register int a; ...
- django-3-视图(views.py)与网址(urls.py)
视图与网址 操作文件:urls.py.views.py urls.py 作用:用于处理前台的链接(如前台访问:127.0.0.1:8080/index/1212/21212),其实永远访问的是同一个文 ...
- django-2-目录结构
django是MVC或者叫MTV框架
- 怎么学习PHP
学习PHP有半个月了.每天都要打代码and写笔记.学过C和Java,在学习PHP的过程中比较顺利吧 (^-^) 代码打得越多,运行得越多,慢慢得会对程序理解得越深.下面就讲讲我学习PHP的心得.PHP ...
- Python字符串前缀
1,r/R表示raw string(原始字符串) #!/usr/bin/python str1 = 'hello \n world' str2 = r'hello \n world' print(st ...
- 53-python基础-python3-列表-列表解析
列表解析 将for循环和创建新元素的代码合并成一行,并自动附加新元素. 实例:使用列表解析创建平方数列表. 首先指定一个描述性的列表名,如squares : 然后,指定一个左方括号,并定义一个表达式, ...
- HDU 3571 N-dimensional Sphere( 高斯消元+ 同余 )
N-dimensional Sphere Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Oth ...
- Codeforces 492E Vanya and Field
E. Vanya and Field time limit per test 2 seconds memory limit per test 256 megabytes input standard ...