
spark运行时出现Neither spark.yarn.jars nor spark.yarn.archive is set错误的解决办法(图文详解)
不多说,直接上干货!
福利 => 每天都推送
问题详情
每次提交spark任务到yarn的时候,总会出现uploading resource(打包spark jars并上传)到hdfs上。恶劣情况下,会在这里卡住很久。
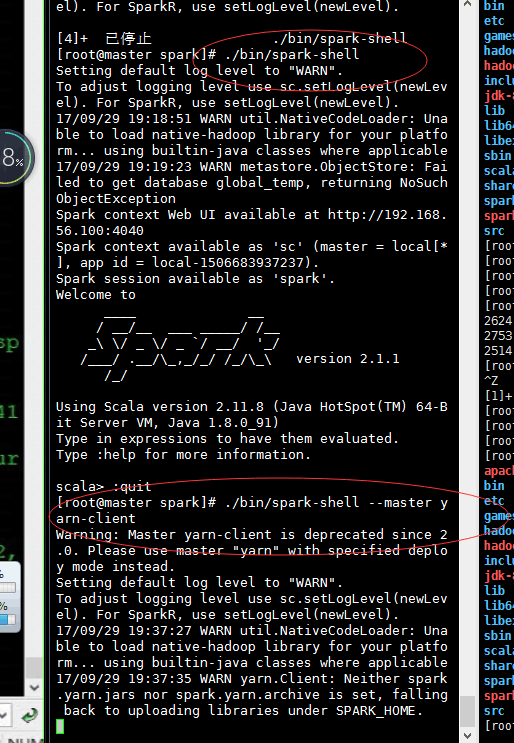
// :: INFO Client: Preparing resources for our AM container

// :: WARN Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploadi

ng libraries under SPARK_HOME.

// :: INFO Client: Uploading resource file:/tmp/spark-28ebde0d-c77a-4be3--a6d3bcccc253/__spar

k_libs__7542776655448713545.zip -> hdfs://dipperCluster/user/hadoop/.sparkStaging/application_1484215273436_0

/__spark_libs__7542776655448713545.zip

// :: INFO Client: Uploading resource file:/tmp/spark-28ebde0d-c77a-4be3--a6d3bcccc253/__spar

k_conf__8972755978315292177.zip -> hdfs://dipperCluster/user/hadoop/.sparkStaging/application_1484215273436_0

/__spark_conf__.zip
其实可以发现,上图中,已经有提示了,说被弃用了。
解决办法1
在hdfs上创建目录:
hdfs dfs -mkdir /home/hadoop/spark_jars
上传spark的jars(spark1.6 只需要上传spark-assembly-1.6.0-SNAPSHOT-hadoop2.6.0.jar)
hdfs dfs -put /opt/spark/jars/* /home/hadoop/spark_jars/
在spark的conf的spark-default.conf ,添加如下的配置
spark.yarn.jars=hdfs://master:9000/opt/spark/jars/* /home/hadoop/spark_jars/
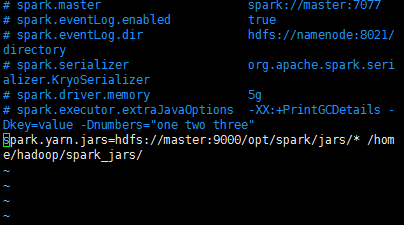
即可解决。不会出现这个问题。
当,再次启动时,则
Source and destination file systems are the same. Not copying hdfs://master:9000/home/hadoop/spark_jars/zookeeper-3.4.6.jar
之后快速开始提交任务,启动任务。
解决办法2
其实啊,说白了,就是spark2.1.0或spark2.2.0以上的版本的命令有所变化。所以压根可以需改动解决办法1所示的配置,直接用官网这样的命令来操作就可以了。
http://spark.apache.org/docs/latest/running-on-yarn.html

同时,大家可以关注我的个人博客:
http://www.cnblogs.com/zlslch/ 和 http://www.cnblogs.com/lchzls/ http://www.cnblogs.com/sunnyDream/
详情请见:http://www.cnblogs.com/zlslch/p/7473861.html
人生苦短,我愿分享。本公众号将秉持活到老学到老学习无休止的交流分享开源精神,汇聚于互联网和个人学习工作的精华干货知识,一切来于互联网,反馈回互联网。
目前研究领域:大数据、机器学习、深度学习、人工智能、数据挖掘、数据分析。 语言涉及:Java、Scala、Python、Shell、Linux等 。同时还涉及平常所使用的手机、电脑和互联网上的使用技巧、问题和实用软件。 只要你一直关注和呆在群里,每天必须有收获
对应本平台的讨论和答疑QQ群:大数据和人工智能躺过的坑(总群)(161156071)
打开百度App,扫码,精彩文章每天更新!欢迎关注我的百家号: 九月哥快讯
spark运行时出现Neither spark.yarn.jars nor spark.yarn.archive is set错误的解决办法(图文详解)的更多相关文章
- Spark Mllib里决策树回归分析如何对numClasses无控制和将部分参数设置为variance(图文详解)
不多说,直接上干货! 在决策树二元或决策树多元分类参数设置中: 使用DecisionTree.trainClassifier 见 Spark Mllib里如何对决策树二元分类和决策树多元分类的分类 ...
- Spark Mllib里决策树回归分析使用.rootMeanSquaredError方法计算出以RMSE来评估模型的准确率(图文详解)
不多说,直接上干货! Spark Mllib里决策树二元分类使用.areaUnderROC方法计算出以AUC来评估模型的准确率和决策树多元分类使用.precision方法以precision来评估模型 ...
- ClouderManger搭建大数据集群时ERROR 2003 (HY000): Can't connect to MySQL server on 'ubuntucmbigdata1' (111)的问题解决(图文详解)
问题详情 相关问题的场景,是在我下面的这篇博客里 Cloudera Manager安装之利用parcels方式(在线或离线)安装3或4节点集群(包含最新稳定版本或指定版本的安装)(添加服务)(Ubun ...
- Spark Mllib里相似度度量(基于余弦相似度计算不同用户之间相似性)(图文详解)
不多说,直接上干货! 常见的推荐算法 1.基于关系规则的推荐 2.基于内容的推荐 3.人口统计式的推荐 4.协调过滤式的推荐 协调过滤算法,是一种基于群体用户或者物品的典型推荐算法,也是目前常用的推荐 ...
- Spark Mllib里如何对决策树二元分类和决策树多元分类的分类数目numClasses控制(图文详解)
不多说,直接上干货! 决策树二元分类的分类数目numClasses控制 具体,见 Hadoop+Spark大数据巨量分析与机器学习整合开发实战的第13章 使用决策树二元分类算法来预测分类Stumble ...
- Spark Mllib里如何记录开始训练时间、完成训练时间、所需训练时间(图文详解)
不多说,直接上干货! 具体,见 Hadoop+Spark大数据巨量分析与机器学习整合开发实战的第16章 朴素贝叶斯二元分类算法来预测分类StumbleUpon数据集
- Spark Mllib里如何将trainDara训练数据文件里提取第M到第N字段(图文详解)
不多说,直接上干货! 具体,见 Hadoop+Spark大数据巨量分析与机器学习整合开发实战的第13章 使用决策树二元分类算法来预测分类StumbleUpon数据集
- Spark Mllib里如何将数据集按比例随机地分成trainData、testData和validationData数据集(图文详解)
不多说,直接上干货! 具体详情见 Hadoop+Spark大数据巨量分析与机器学习整合开发实战的第11章 电影推荐引擎
- Android SDK Manager检查更新时遇到Failed to fetch URL xxxxxxx reason: Connection to xxxxxx的错误的解决办法!
首先说明的是这个问题并不是每个人都存在,但是我和我的一个同学都有这种情况,所以我同学百度了一下,找出了解决办法. 问题描述: 使用Android SDK Manager检查在线更新,提示以下错误: & ...
随机推荐
- Java Serializable(序列化)的理解和总结
1.序列化是干什么的? 简单说就是为了保存在内存中的各种对象的状态(也就是实例变量,不是方法),并且可以把保存的对象状态再读出来.虽然你可以用你自己的各种各样的方法来保存object st ...
- 【C#】 ref out
ref 通常我们向方法中传递的是值,方法获得的是这些值的一个拷贝,然后使用这些拷贝,当方法运行完毕后,这些拷贝将被丢弃,而原来的值不会受到影响. 这种情况是通常的,当然还有另外一种情况,我们向方法传递 ...
- jquery.validate弹窗验证
$(document).ready(function () { //开始验证 $("#form1").validate({ submitHan ...
- 协程《三》gevent模块
一 gevent模块 安装 pip3 install gevent Gevent 是一个第三方库,可以轻松通过gevent实现并发同步或异步编程,在gevent中用到的主要模式是Greenlet, 它 ...
- Javascript 上传文件到Azure存储
对一些前端工程师来讲,使用javascript上传文件到Azure存储中可能是需要掌握的技能,希望这篇博客能给到帮助. 在开始前我们需要了解以下几点: 共享访问签名(Shared Access Sig ...
- P4855 MloVtry的idea
$ \color{#0066ff}{ 题目描述 }$ MloVtry是一个脑洞很大的人,它总会想出一些奇奇怪怪的idea. 可问题是,MloVtry作为一个蒟蒻,很多时候都没办法解决自己提出的问题,所 ...
- linux的发行版
Linux的不同版本以及应用领域 1.Linux内核及发行版介绍 <1>Linux内核版本 内核(kernel)是系统的心脏,是运行程序和管理像磁盘和打印机等硬件设备的核心程序,它提供了一 ...
- select和epoll的实现
select:fd_set是输入结果参数,每次select之后,还得重置fd_set (1)使用copy_from_user从用户空间拷贝fd_set到内核空间,第一步需要复制所有感兴趣的文件描述符到 ...
- win10进入安全模式的方法
https://jingyan.baidu.com/article/a3aad71ac5919bb1fa009667.html
- JS中Math函数的常用方法
Math 是数学函数,但又属于对象数据类型 typeof Math => ‘object’ console.dir(Math) 查看Math的所有函数方法. 1,Math.abs() 获取绝对值 ...