
python抓取中文网页乱码通用解决方法
注:转载自http://www.cnpythoner.com/
我们经常通过python做采集网页数据的时候,会碰到一些乱码问题,今天给大家分享一个解决网页乱码,尤其是中文网页的通用方法。
首页我们需要安装chardet模块,这个可以通过easy_install 或者pip来安装。
安装完以后我们在控制台上导入模块,如果正常就可以。
比如我们遇到的一些ISO-8859-2也是可以通过下面的方法解决的。
直接上代码吧:
import sys
import chardet
req = urllib2.Request("http://www.163.com/")##这里可以换成http://www.baidu.com,http://www.sohu.com
content = urllib2.urlopen(req).read()
typeEncode = sys.getfilesystemencoding()##系统默认编码
infoencode = chardet.detect(content).get('encoding','utf-8')##通过第3方模块来自动提取网页的编码
html = content.decode(infoencode,'ignore').encode(typeEncode)##先转换成unicode编码,然后转换系统编码输出
print html
通过上面的代码,相信能够解决你采集乱码的问题。
接着开始学习网络爬虫的深入点儿的东东:
以抓取韩寒博客文章目录来加以说明:http://blog.sina.com.cn/s/articlelist_1191258123_0_1.html,下面是截图
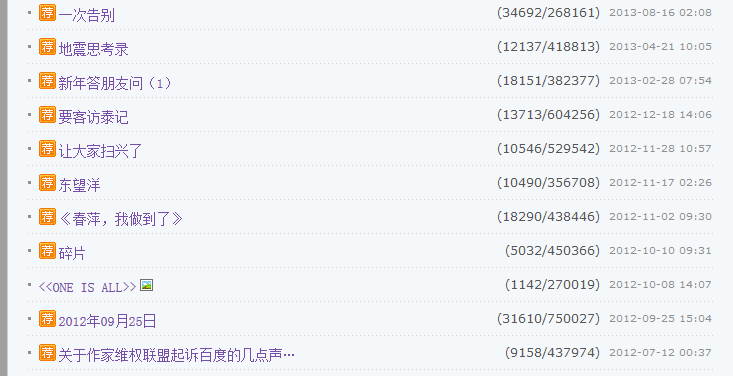
我用的是Chrome浏览器(firefox也行),打开上述网页,鼠标右击,选择审查元素,就会出现下面所示
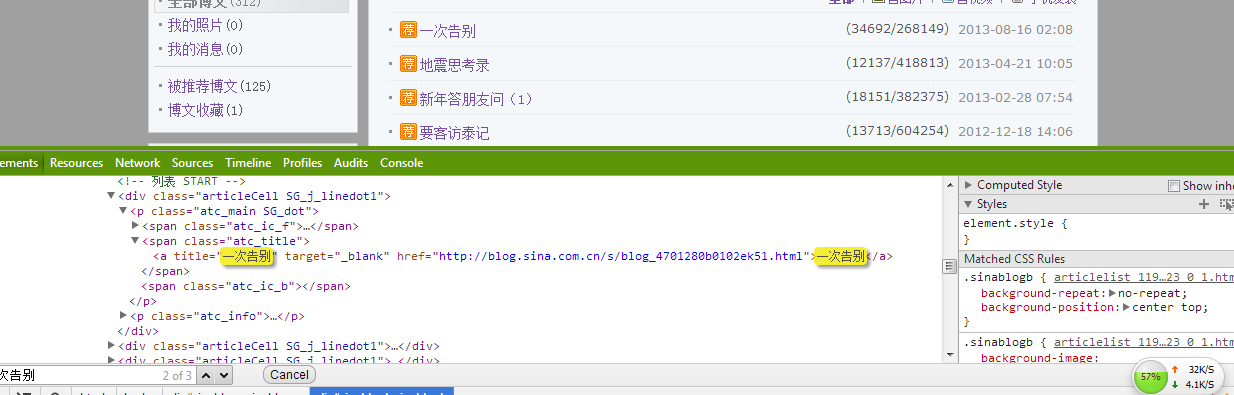
首先我们来实现抓取第一篇文章“一次告别”的page的url
按住ctrl+f就会在上图左下角打开搜索栏,输入”一次告别“,就会自动定位到html源码所在位置,如上高亮显示的地方
接下来我们就是要把对应的url:http://blog.sina.com.cn/s/blog_4701280b0102ek51.html提取出来
详细实现代码如下:
 #coding:utf-8

 import urllib

 str0 = '<a title="一次告别" target="_blank" href="http://blog.sina.com.cn/s/blog_4701280b0102ek51.html">一次告别</a>'

 title = str0.find(r'<a title')

 print title

 href = str0.find(r'href=')

 print href

 html = str0.find(r'.html')

 print html

 url = str0[href + 6:html + 5]

 print url

 content = urllib.urlopen(url).read()

 #print content

 filename = url[-26:]

 print filename

 open(filename, 'w').write(content)
catchBlog.py
下面对代码进行解释:
首先利用find函数开始依次匹配查找'<a title','href=','.html',这样就可以找到关键字符所在的索引位置,然后就可以定位到http://blog.sina.com.cn/s/blog_4701280b0102ek51.html的位置[href+6:html+5]
最后利用urllib的相关函数打开并读取网页内容,写到content中
运行程序:
0
40
93
http://blog.sina.com.cn/s/blog_4701280b0102ek51.html
blog_4701280b0102ek51.html
于是在代码所在目录生成html文件blog_4701280b0102ek51.html
至此便抓取到第一篇文章的url及网页内容;上述操作主要学习了以下几个内容:1.分析博客文章列表特征2.提取字符串中的网络连接地址3.下载博文到本地
接下来继续深入:获取博文目录第一页所有文章的链接并将所有文章下载下来
 #coding:utf-8

 import urllib

 import time

 url = ['']*50

 con = urllib.urlopen('http://blog.sina.com.cn/s/articlelist_1191258123_0_1.html').read()

 i = 0

 title = con.find(r'<a title=')

 href = con.find(r'href=', title)

 html = con.find(r'.html', href)

 while title != -1 and href != -1 and html != -1 and i < 50:

     url[i] = con[href+6:html+5]

     print url[i]

     title = con.find(r'<a title=', html)

     href = con.find(r'href=', title)

     html = con.find(r'.html', href)

     i = i + 1

 else:

     print "Find end!"

 j = 0

 while j < 50:

     content = urllib.urlopen(url[j]).read()

     open(r'hanhan/' + url[j][-26:], 'w+').write(content)

     j = j + 1

     print 'downloading', url[j]

     time.sleep(15)

 else:

     print 'Download article finish!'

 #print 'con', con
catchBlog1.py
python抓取中文网页乱码通用解决方法的更多相关文章
- 解决Scrapy抓取中文网页保存为json文件时中文不显示而是显示unicode的问题
注意:此方法跟之前保存成json文件的写法有少许不同之处,注意区分 情境再现: 使用scrapy抓取中文网页,得到的数据类型是unicode,在控制台输出的话也是显示unicode,如下所示 {'au ...
- ECSHOP编辑器Fckeditor上传图片中文名称乱码的解决方法
ECSHOP编辑器Fckeditor上传图片中文名称乱码的解决方法 ECSHOP教程/ ecshop教程网(www.ecshop119.com) 2015-02-11 中文名乱码是因为:FCKed ...
- 用c#读取文件内容中文是乱码的解决方法:
用c#读取文件内容中文是乱码的解决方法: //方法1: StreamReader din = new StreamReader(@"C:\1.txt", System.Text.E ...
- URL传参时中文参数乱码的解决方法
URL传参时,中文参数乱码的解决: 今天在工作中遇到了这样的一个问题,在页面之间跳转时,我将中文的参数放入到url中,使用location进行跳转传参,但是发现接收到的参数值是乱码.我的代码是这样写的 ...
- python(27)requests 爬取网页乱码,解决方法
最近遇到爬取网页乱码的情况,找了好久找到了种解决的办法: html = requests.get(url,headers = head) html.apparent_encoding html.enc ...
- SecureCRT中文显示乱码的解决方法
注:本文出自:http://riching.iteye.com/blog/349754 最近开始用SecureCRT登陆linux系统,由于是新手,很多问题不清楚,碰到显示中文乱码的问题,困扰了好几天 ...
- Fiddler - 工具配置及在ios抓取不了https的解决方法
一.首先,官网下载最新版fiddler工具: https://www.telerik.com/fiddler 二.打开fiddler,点击Tools - Options 我电脑上的各项配置如下图(也可 ...
- PLSQL Developer 中文显示乱码的解决方法
PLSQL Developer 中文显示乱码是因为 Oracle 数据库所用的编码和 PLSQL Developer 所用的编码不同所导致的. 解决方法: 1. 先查询 Oracle 所用的编码 se ...
- win使用telnet到ubuntu下vim显示中文为乱码的解决方法~
1.几个路径: ubuntu: /etc/default/locale 相当于 centos:/etc/sysconfig/i18n vimrc的路径:① ~/.vimrc ② /etc/vi ...
随机推荐
- RMAN-06059: expected archived log not found, loss of archived log compromises recoverability
归档日志被物理删除后执行rman操作报错: RMAN> backup database plus archivelog; Starting backup at -JUL- :: current ...
- PostgreSQL Replication之第十章 配置Slony(5)
10.5 给复制添加表和管理的问题 一旦我们增加了此表到系统中,我们可以将它添加到复制设置.这样做有点复杂.首先,我们必须创建我们自己的新表集合并把这个和我们已经有的表合并.因此,过一段时间,我们将有 ...
- C# 微信支付教程系列之扫码支付
微信支付教程系列之扫码支付 今天,我们来一起探讨一下这个微信扫码支付.何为扫码支付呢?这里面,扫的码就是二维码了,就是我们经常扫一扫的那种二维码图片,例如,我们自己添加好友的时候 ...
- SQL top order between 一起使用
select * from emp;
- Android中操作数据的集中方式---文件,SQLite,ContentProvider
http://blog.csdn.net/he90227/article/details/33734239 转
- Python快速建站系列-Part.One-组装开发环境
|版权声明:本文为博主原创文章,未经博主允许不得转载. 源代码都在github上:SmallStudyStation 现在是个demo,但回来会租个服务器,等功能完善了放到服务器上挂着,域名jusot ...
- mongodb聚合内存不足解决方案
原因:mongodb每一个文档默认只有16M.聚合的结果是一个BSON文档,当超过16M大小时,就会报内存不够错误. exceeded memory limit for $group.but didn ...
- Delphi中SQL批量插入记录
http://www.cnblogs.com/azhqiang/p/4050331.html 在进行数据库操作时, 我们经常会遇到批量向数据库中写入记录的情况. 在这里我提供3种操作方式: 1. ...
- PAT乙级 1007. 素数对猜想 (20)
1007. 素数对猜想 (20) 时间限制 400 ms 内存限制 65536 kB 代码长度限制 8000 B 判题程序 Standard 作者 CHEN, Yue 让我们定义 dn 为:dn = ...
- json_encode注意
PHP5.2或以上的版本把json_encode作为内置函数来用,但只支持utf-8编码的字符,否则中文就会出现乱码或者空值.解决办法如下: 1.保证在使用JSON处理的时候字符是以UTF8编码的.具 ...