
python学习笔记(一)——Python基础
一、python 基础语法
python 的解释器在启动时会自动加载一个内建的模块,因此我们在使用 print()、input()等函数时不用导入其他模块文件。
基本语法:
- 每条语句结尾没有分号
- 定义变量不需要前置声明变量的类型(动态语言)
- 定义常量不需要特殊关键字,如 PI=3.14,但是PI可改变如PI=5
- 注释,采用 # 进行单行注释,用""“xxx”""或’’‘xxx’’'多行注释
基本数据类型
整型(int):类似于C语言中的 long long类型,取值范围取决于计算机内存大小,甚至一个数可以占满整个内存。
进制表示 十进制 二进制 八进制 十六进制 不同进制表示 整数10 0b1010 0o12 0xa 进制转换 任意整数x bin(x) oct(x) hex(x) 转换成十进制 任意数xxx int(‘xxx’,2) int(‘xxx’,8) int(‘xxx’,16) 浮点数类型(float)
字符串类型(str):用
""或''之间的的字符为一个字符串。该类型支持+拼接、*重复运算。用print()输出,支持转义字符\,加参数r屏蔽转义功能。bool 类型:True、False(首字母大写)。非0为True, 0、空字符、空列表、空元组、None都认为是False。
None 类型:类似C语言的NULL,表示一个空值。
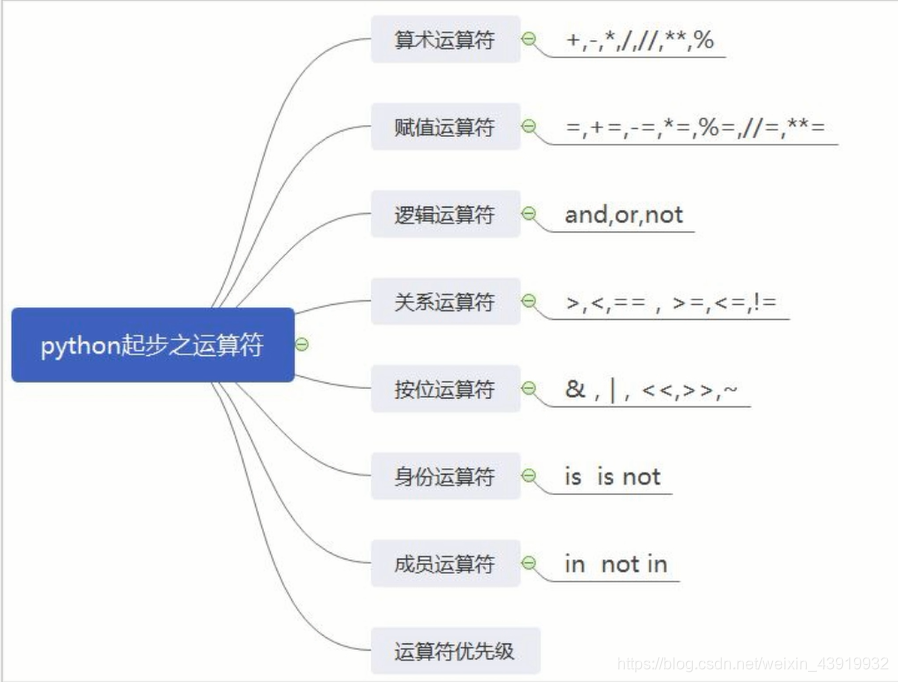
运算符
二、 字符编码
1. 常见的字符编码
- ASCII 码:单字节编码
- MBCS 码:(2字节编码类),规定如果第一个字节是 \x80 以下,则任然使用ASCII码;反之,则使用两个字节表示一个字符。如windows的ANSI码格式
- Unicode 码:所有字符的字符集(UCS-2 两个字节表示一个字符、UCS-4四个字节表示一个字符,常用USC-2),UCS(Unicode Character Set)仅仅是字符对应码位的一张表,具体如何传输和存储有UTF(UCS Transformation Format)负责。
直接使用UCS的码位来保存,这就是UTF-16,由于以前使用ASCII码表示英文字符只需要一个字节,而使用UCS-2需要2个字节,空间消耗过大,于是UTF-8出现了。
- UTF-8 码:一种可变长的编码,它把一个Unicode字符根据不同数字大小编码成1~6个字节。常用的英文字母被编码成1个字节,汉字通常是3个字节,生僻的字符会被编码成4 ~ 6个字节。
另外,在计算机内存中,统一使用Unicode编码,当需要保存到硬盘或者需要传输的时候,就转换为UTF-8编码。浏览网页的时候,服务器会把动态生成的Unicode内容转换为UTF-8再传输到浏览器:所以你看到很多网页的源码上会有类似如下的信息,表示该网页正是用的UTF-8编码。<meta charset="UTF-8"/>
2. 字符编码的声明
由于Python源代码也是一个文本文件,所以,当你的源代码中包含中文的时候,在保存源代码时,就需要务必指定保存为UTF-8编码。当Python解释器读取源代码时,为了让它按UTF-8编码读取,我们通常在文件开头写上这两行:
#!/usr/bin/python

# -*- coding: utf-8 -*-12
- 第一行注释是为了告诉Linux/OS X系统,这是一个Python可执行程序,Windows系统会忽略这个注释;
- 第二行注释是为了告诉Python解释器,按照UTF-8编码读取源代码,否则,你在源代码中写的中文输出可能会有乱码。
实际上,python只检查#、coding和编码字符串,其它字符串使为了美观加上的。其中UTF-8也可以写成u8 。另外需要注意的是,声明的编码需要与文件实际保存的编码一致,否则可能会出现代码解析异常。
bytes 类型
Python bytes 类型(由字节表示字符串)。bytes() 函数返回一个新的 bytes 对象,该对象是一个 0 <= x < 256 区间内的整数不可变序列。
字节串(bytes)和字符串(string)的对比:
- 字符串由若干个字符组成,以字符为单位进行操作;bytes由若干个字节组成,以字节为单位进行操作。
- bytes和字符串除了操作的数据单元不同之外,它们支持的所有方法都基本相同。
- bytes和字符串都是不可变序列,不能随意增加和删除数据。
bytes 只负责以字节序列的形式(二进制形式)来存储数据,至于这些数据到底表示什么内容(字符串、数字、图片、音频等),完全由程序的解析方式决定。如果采用合适的字符编码方式(字符集),bytes可以恢复成字符串;反之亦然,字符串也可以转换成字节串。bytes 只是简单地记录内存中的原始数据。
bytes 类型的数据非常适合在互联网上传输,可以用于网络通信编程,如果字符串想要在网络上传输就必须先转换成bytes类型;bytes 也可以用来存储图片、音频、视频等二进制格式的文件。
字符串和 bytes 存在着千丝万缕的联系,我们可以通过字符串来创建 bytes 对象,或者说将字符串转换成 bytes 对象。有以下三种方法可以达到这个目的:
- 如果字符串的内容都是 ASCII 字符,那么直接在字符串前面添加
b前缀就可以转换成 bytes。 - bytes 是一个类,调用它的构造方法,也就是 bytes(),可以将字符串按照指定的字符集转换成 bytes;如果不指定字符集,那么默认采用 UTF-8。
- 字符串本身有一个 encode() 方法,该方法专门用来将字符串按照指定的字符集转换成对应的字节串;如果不指定字符集,那么默认采用 UTF-8。
以下是 bytes() 的语法:
class bytes([source[, encoding[, errors]]])
参数
- 如果 source 为整数,则返回一个长度为 source 的初始化数组;
- 如果 source 为字符串,则按照指定的 encoding 将字符串转换为字节序列;
- 如果 source 为可迭代类型,则元素必须为[0 ,255] 中的整数;
- 如果 source 为与 buffer 接口一致的对象,则此对象也可以被用于初始化 bytearray。
- 如果没有输入任何参数,默认就是初始化数组为0个元素。
bytes 类型实例
# 以下模拟交互界面

# 使用 b 前缀

>>> btr=b"abc"

>>> type(btr)		#查看btr类型

<class 'bytes'>

>>> btr

b'abc'

# 使用 bytes()函数

>>> a = bytes([1,2,3,4])

>>> a

b'\x01\x02\x03\x04'

>>> type(a)

<class 'bytes'>

# class bytes([source[, encoding[, errors]]])

>>> b = bytes('hello','ascii')

>>> b

b'hello'

>>> type(b)

<class 'bytes'>

# 使用 encode()转码 decode()解码

>>> "我爱学习".encode("utf-8")

b'\xe6\x88\x91\xe7\x88\xb1\xe5\xad\xa6\xe4\xb9\xa0'

>>>b'\xe6\x88\x91\xe7\x88\xb1\xe5\xad\xa6\xe4\xb9\xa0'.decode("UTF-8")

'我爱学习'

# gbk双字节编码,包含全部中文字符

>>> str = "我爱学习".encode("gbk")

>>> str

b'\xce\xd2\xb0\xae\xd1\xa7\xcf\xb0'

>>> str.decode("gbk")

'我爱学习'
查看字符对应的Unicode码(Ascii码)
# 以下模拟交互界面

# 使用 ord() 查看字符编码(Ascii或Unicode)

# chr()用一个范围在 range(256)内的(就是0~255)整数作参数,返回一个对应的字符

# unichr(),与chr()函数功能基本一样, 只不过是返回 unicode 的字符

>>> ord("我")

25105

>>> chr(25105)

'我'

# 查看当前所采用的编码标椎

>>> import sys

>>> sys.getdefaultencoding()

'utf-8'
与编码相关的方法:
import sys

import locale

def p(f):

    print('%s.%s(): %s' % (f.__module__, f.__name__, f()) )

# 返回当前系统所使用的默认字符编码

p(sys.getdefaultencoding)

# 返回用于转换Unicode文件名至系统文件名所使用的编码

p(sys.getfilesystemencoding)

# 获取默认的区域设置并返回元祖(语言, 编码)

p(locale.getdefaultlocale)

# 返回用户设定的文本数据编码

# 文档提到this function only returns a guess

p(locale.getpreferredencoding)

# \xba\xba是'汉'的GBK编码

# mbcs是不推荐使用的编码,这里仅作测试表明为什么不应该用

print(r"'\xba\xba'.decode('mbcs'):", repr('\xba\xba'.decode('mbcs')) )

#Windows上的结果(区域设置为中文(简体, 中国))

sys.getdefaultencoding(): utf-8

sys.getfilesystemencoding(): utf-8

locale.getdefaultlocale(): ('zh_CN', 'cp936')

locale.getpreferredencoding(): cp936'
编码部分参考博客:Python字符编码详解
python学习笔记(一)——Python基础的更多相关文章
- 【Python学习笔记一】基础环境安装:idea+python
IDEA 安装 1.下载IDEA 官网下载地址: https://www.jetbrains.com/idea/ 2.安装的时候配置基本选择默认配置就行 参考链接:https://blog.csd ...
- python 学习笔记 9 -- Python强大的自省简析
1. 什么是自省? 自省就是自我评价.自我反省.自我批评.自我调控和自我教育,是孔子提出的一种自我道德修养的方法.他说:“见贤思齐焉,见不贤而内自省也.”(<论语·里仁>)当然,我们今天不 ...
- Python学习笔记 - day12 - Python操作NoSQL
NoSQL(非关系型数据库) NoSQL,指的是非关系型的数据库.NoSQL有时也称作Not Only SQL的缩写,是对不同于传统的关系型数据库的数据库管理系统的统称.用于超大规模数据的存储.(例如 ...
- python 学习笔记一——Python安装和IDLE使用
好吧,一直准备学点啥,前些日子也下好了一些python电子书,但之后又没影了.年龄大了,就是不爱学习了.那就现在开始吧. 安装python 3 Mac OS X会预装python 2,Linux的大多 ...
- python学习笔记(一):python简介和入门
最近重新开始学习python,之前也自学过一段时间python,对python还算有点了解,本次重新认识python,也算当写一个小小的教程.一.什么是python?python是一种面向对象.解释型 ...
- python学习笔记(python简史)
一.python介绍 python的创始人为吉多·范罗苏姆(Guido van Rossum) 目前python主要应用领域: ·云计算 ·WEB开发 ·科学运算.人工智能 ·系统运维 ·金融:量化交 ...
- python学习笔记(1)--python特点
python诞生于复杂的信息系统时代,是计算机时代演进的一种选择. python的特点,通用语言,脚本语言,跨平台语言.这门语言可以用于普适的计算,不局限于某一类应用,通用性是它的最大特点.pytho ...
- python学习笔记之——python模块
1.python模块 Python 模块(Module),是一个 Python 文件,以 .py 结尾,包含了 Python 对象定义和Python语句. 模块让你能够有逻辑地组织你的 Python ...
- [Python学习笔记1]Python语言基础 数学运算符 字符串 列表
这个系列是我在学习Python语言的过程中记录的笔记,主要是一些知识点汇总,而非学习教程,可供有一定编程基础者参考.文中偏见和不足难以避免,仅供参考,欢迎批评指正. 本系列笔记主要参考文献是官网文档: ...
- Python学习笔记一(基础信息)
目录 输入输出 数据类型和变量 整数 浮点数 字符串 布尔值 空值 变量 常量 小结 欢迎关注我的博客我在马路边 说明:此笔记不是从零开始,在学习的过程中感觉需要记录一些比较重要和需要重复浏览的信息, ...
随机推荐
- 三、Java入门
Java入门 Java的特性和优势 特性 简单 面对对象 可移植性 优势 性能高 分布式(跨平台:Write Once .Run Anywhere) 动态性(反射) 多线程 ...
- LeetCode-029-两数相除
两数相除 题目描述:给定两个整数,被除数 dividend 和除数 divisor.将两数相除,要求不使用乘法.除法和 mod 运算符. 返回被除数 dividend 除以除数 divisor 得到的 ...
- 矩池云 | Tony老师解读Kaggle Twitter情感分析案例
今天Tony老师给大家带来的案例是Kaggle上的Twitter的情感分析竞赛.在这个案例中,将使用预训练的模型BERT来完成对整个竞赛的数据分析. 导入需要的库 import numpy as np ...
- 二级py--day5 软件工程基础
二级py--day5软件工程基础 软件工程基础 1.软件工程三要素:方法.工具和过程 2.软件生命周期可以分为:项目可行性研究与规划.软件需求分析.软件设计.软件实现.软件测试.软件运行与维护等阶段 ...
- LGP2490题解
有点儿神秘? 根据他这个题意说的,白子向右的第一个一定是对应的黑子啊. 所以棋子的绝对位置是不重要的,我们只需要考虑白子和黑子的相对位置,然后考虑用 GF 来拼凑状态就好了. 下面的 \(k\) 是题 ...
- 魅族mx3手机 固件升级方法
1.正常手机刷机,升级固件的方法 我今天3.5升4.2.8都提示固件损坏 后来我找客服 一定要用电脑下3.8固件 然后按住开机和音量+ 进入刷机模式 然后连接电脑 电脑会给你一个900mb的磁盘 拉进 ...
- 全面解析UNIX缓冲区溢出 深度防御体系
首先简要回顾一下缓冲区溢出的攻击大系: ◆栈溢出(stack smashing) 未检查输入缓冲区长度,导致数组越界,覆盖栈中局部变量空间之上的栈桢指针%ebp以及函数返回地址retaddr,当函数返 ...
- 一键生成mapper、mapperxml等文件——MybatisX插件的使用
本文首发于西二blogs:一键生成mapper.mapperxml等文件--MybatisX插件的使用 搬运请务必转载出处. MybatisX插件使用--为快速开发而生 前言:其实很久以前我就非常厌恶 ...
- 洛谷 P2375 动物园
题目详情 题目描述 近日,园长发现动物园中好吃懒做的动物越来越多了.例如企鹅,只会卖萌向游客要吃的.为了整治动物园的不良风气,让动物们凭自己的真才实学向游客要吃的,园长决定开设算法班,让动物们学习算法 ...
- 「入门篇」初识JVM
记录于 2022-01-02 17:25:12 GhostFace 1. 什么是JVM? 概念 来自百度百科 JVM是 Java Virtual Machine(Java虚拟机)的缩写,JVM是一 ...