
好饭不怕晚,Google基于人工智能AI大语言对话模型Bard测试和API调用(Python3.10)
谷歌(Google)作为开源过著名深度学习框架Tensorflow的超级大厂,是人工智能领域一股不可忽视的中坚力量,旗下新产品Bard已经公布测试了一段时间,毁誉参半,很多人把Google的Bard和OpenAI的ChatGPT进行对比,Google Bard在ChatGPT面前似乎有些技不如人。
事实上,Google Bard并非对标ChatGPT的产品,Bard是基于LaMDA模型对话而进行构建的,Bard旨在构建一个对话式的AI系统,使其能够更好地理解人类语言,并且具备进行多轮对话的能力。而GPT的目标是生成自然语言文本。
在特征数据层面,Bard使用了像Gmail、Meet等Google社交产品线中的对话数据来进行训练,这些数据已经经过了严格的隐私保护措施。而GPT则是通过大规模的网页爬虫来获取数据,它的训练数据量比LaMDA要大得多。
模型结构层面,Bard采用了一种称为“Transformer”的神经网络结构,该结构可以处理长文本并保持信息连贯性。GPT也使用了Transformer结构,但它还采用了一种称为“自回归”的方式,即按照时间步骤一个接一个地生成文本。
说白了,在应用层面上,Bard适合开发智能助手、聊天机器人、虚拟客服等应用。而GPT更适用于自然语言生成任务,例如文章撰写、机器翻译等等。
Bard对话测试(英文/中文)
访问 bard.google.com ,随后输入聊天内容:
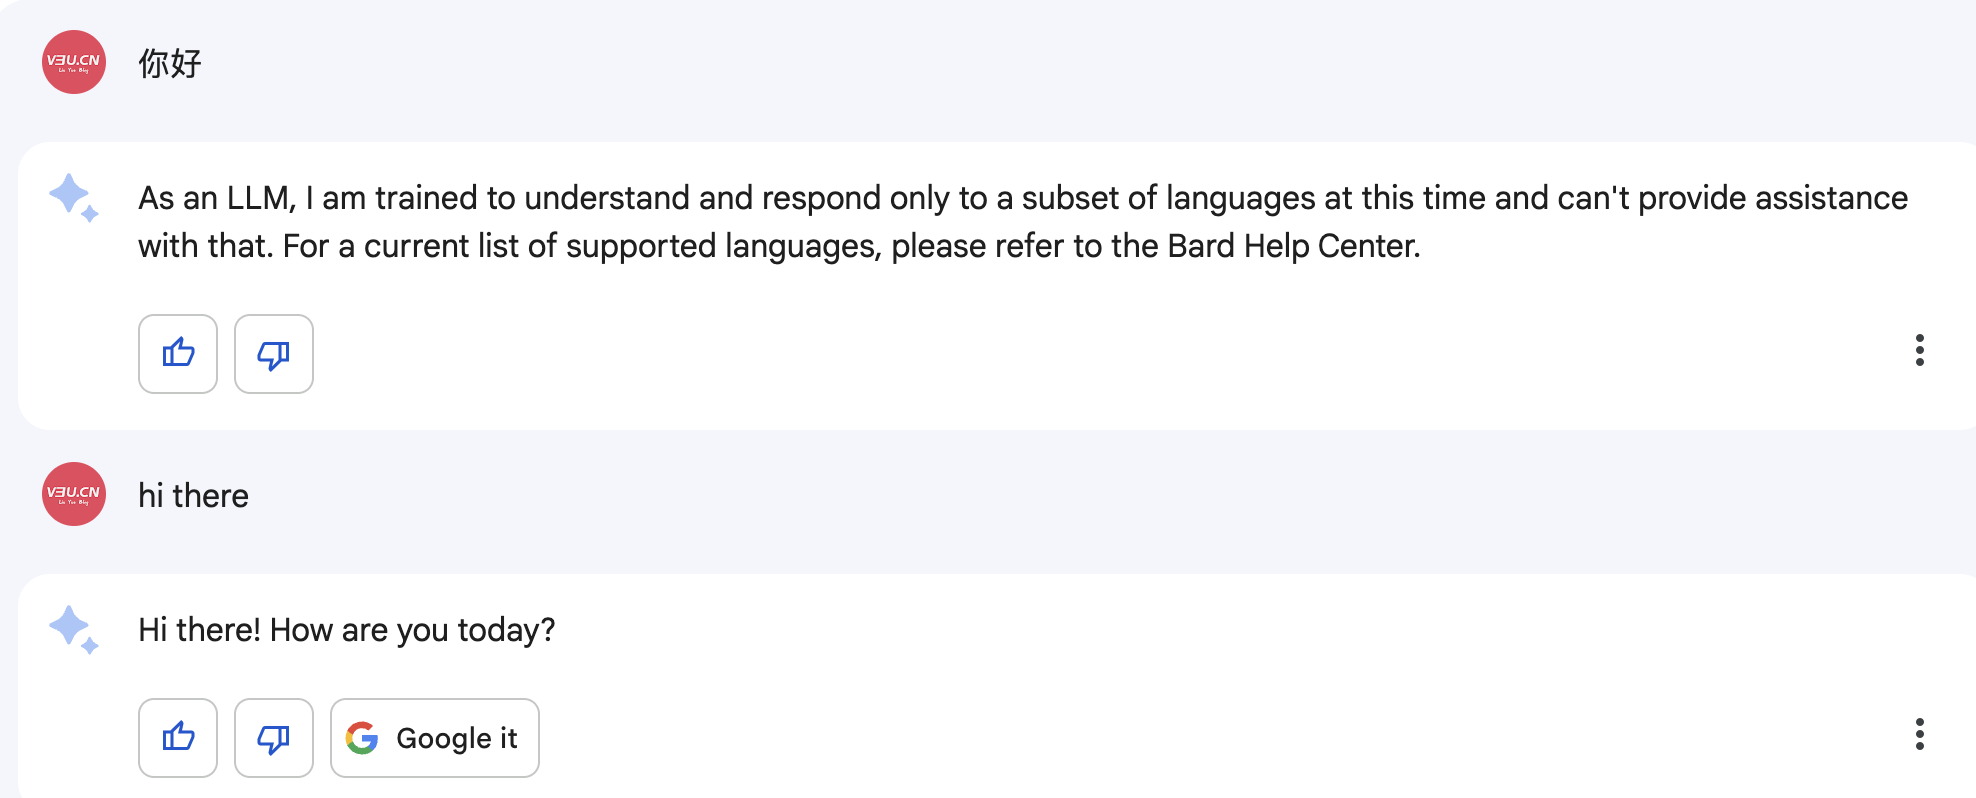
一望而知,对话输入的内容只支持英文,并不能输入中文。
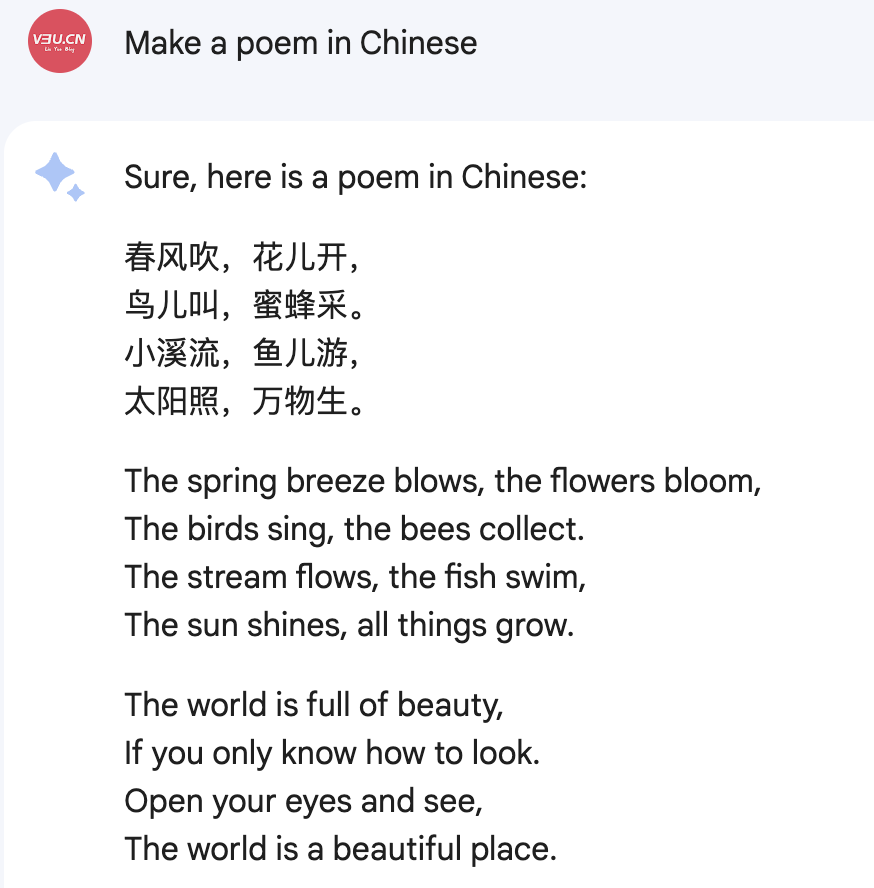
但事实上,只要稍微改变一下对话逻辑,也可以让Bard返回中文信息,比如:
Bard代码能力
私以为Bard的代码能力并不输于ChatGPT:
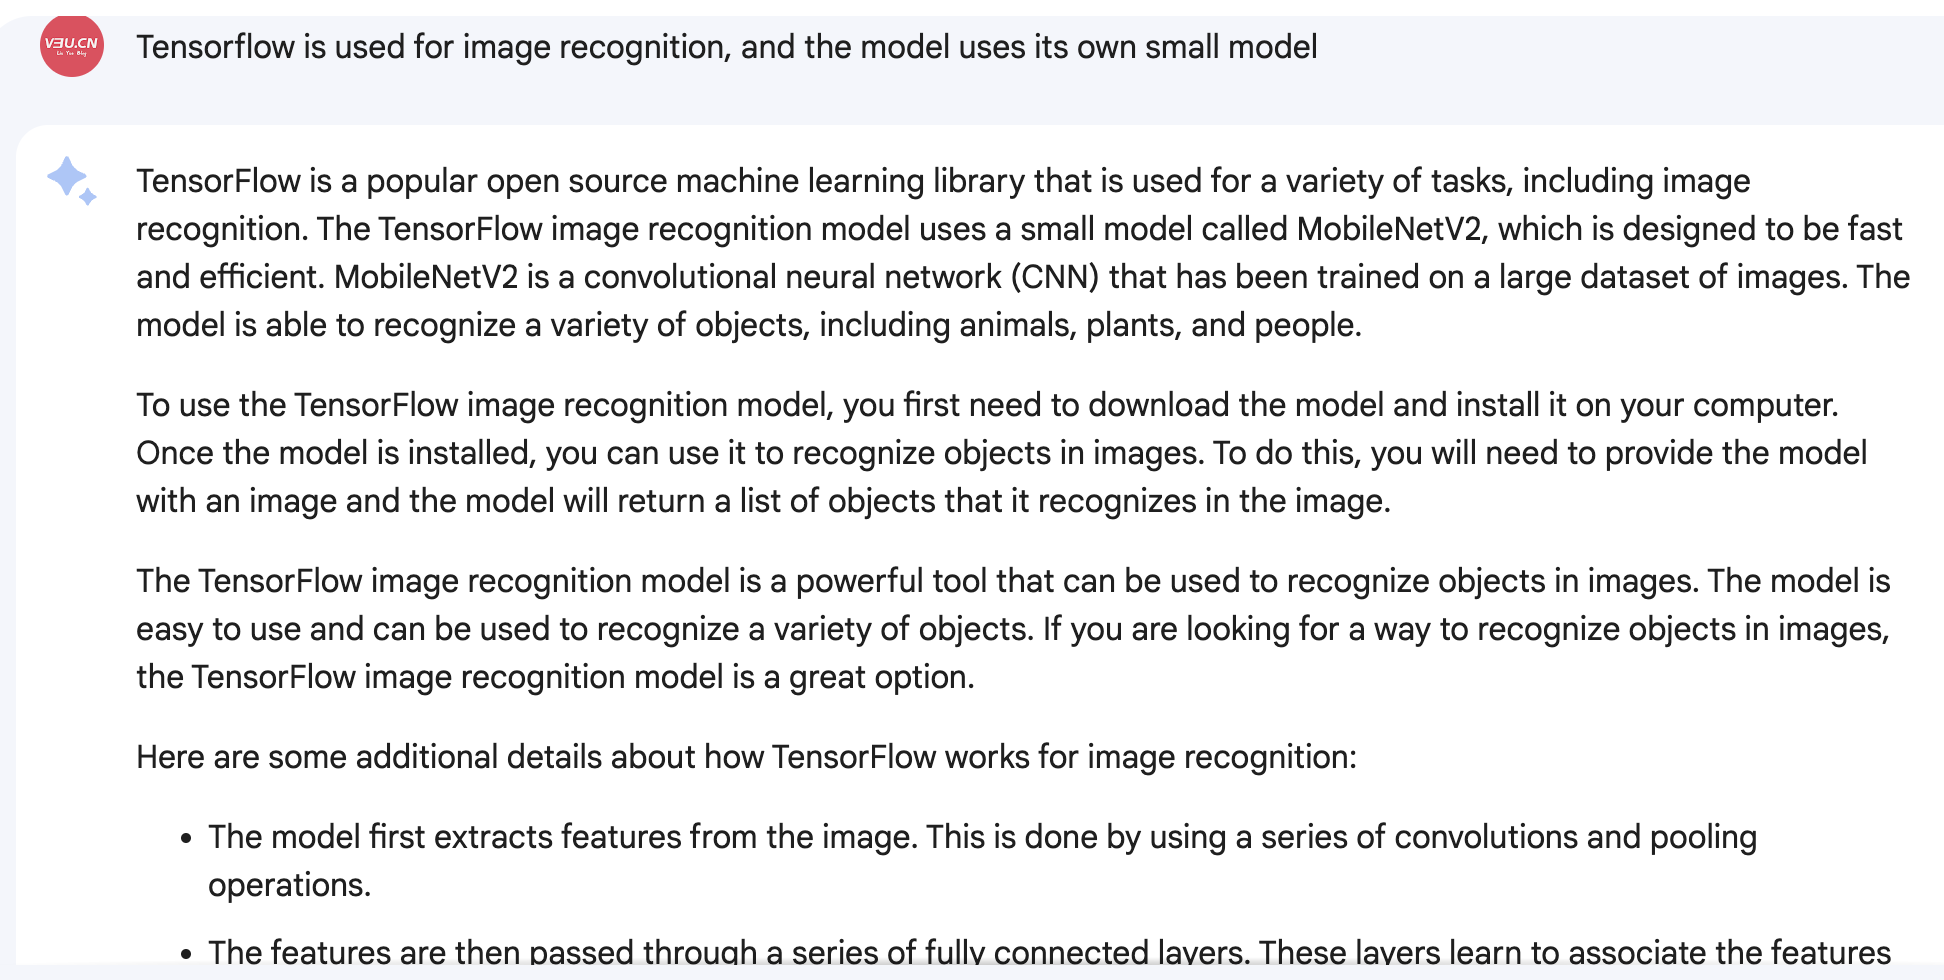
尤其是对自家的深度学习框架Tensorflow更是如数家珍,生成的代码如下:
import tensorflow as tf

def load_model():

  """Loads the TensorFlow image recognition model."""

  model = tf.keras.models.load_model('mobilenet_v2_1.0_224')

  return model

def recognize_objects(image):

  """Recognizes objects in an image."""

  # Convert the image to a tensor.

  image = tf.image.convert_image_dtype(image, dtype=tf.float32)

  # Resize the image to 224x224 pixels.

  image = tf.image.resize(image, [224, 224])

  # Normalize the image.

  image = tf.image.normalize(image, mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])

  # Predict the labels of the objects in the image.

  predictions = model.predict(image)

  # Return the labels of the objects in the image.

  return predictions

def main():

  # Load the image recognition model.

  model = load_model()

  # Load an image.

  image = tf.io.read_file('image.jpg')

  # Recognize objects in the image.

  predictions = recognize_objects(image)

  # Print the labels of the objects in the image.

  for prediction in predictions:

    print(prediction)

if __name__ == '__main__':

  main()
这里是使用Tensorflow内置小模型mobilenet_v2_1.0_224的智能识图逻辑,简洁而严谨。
Bard网络架构
在浏览器(B端)架构上,Google极其自信地使用了HTTP2协议的接口进行通信,而没有仿效ChatGPT使用SSE协议:
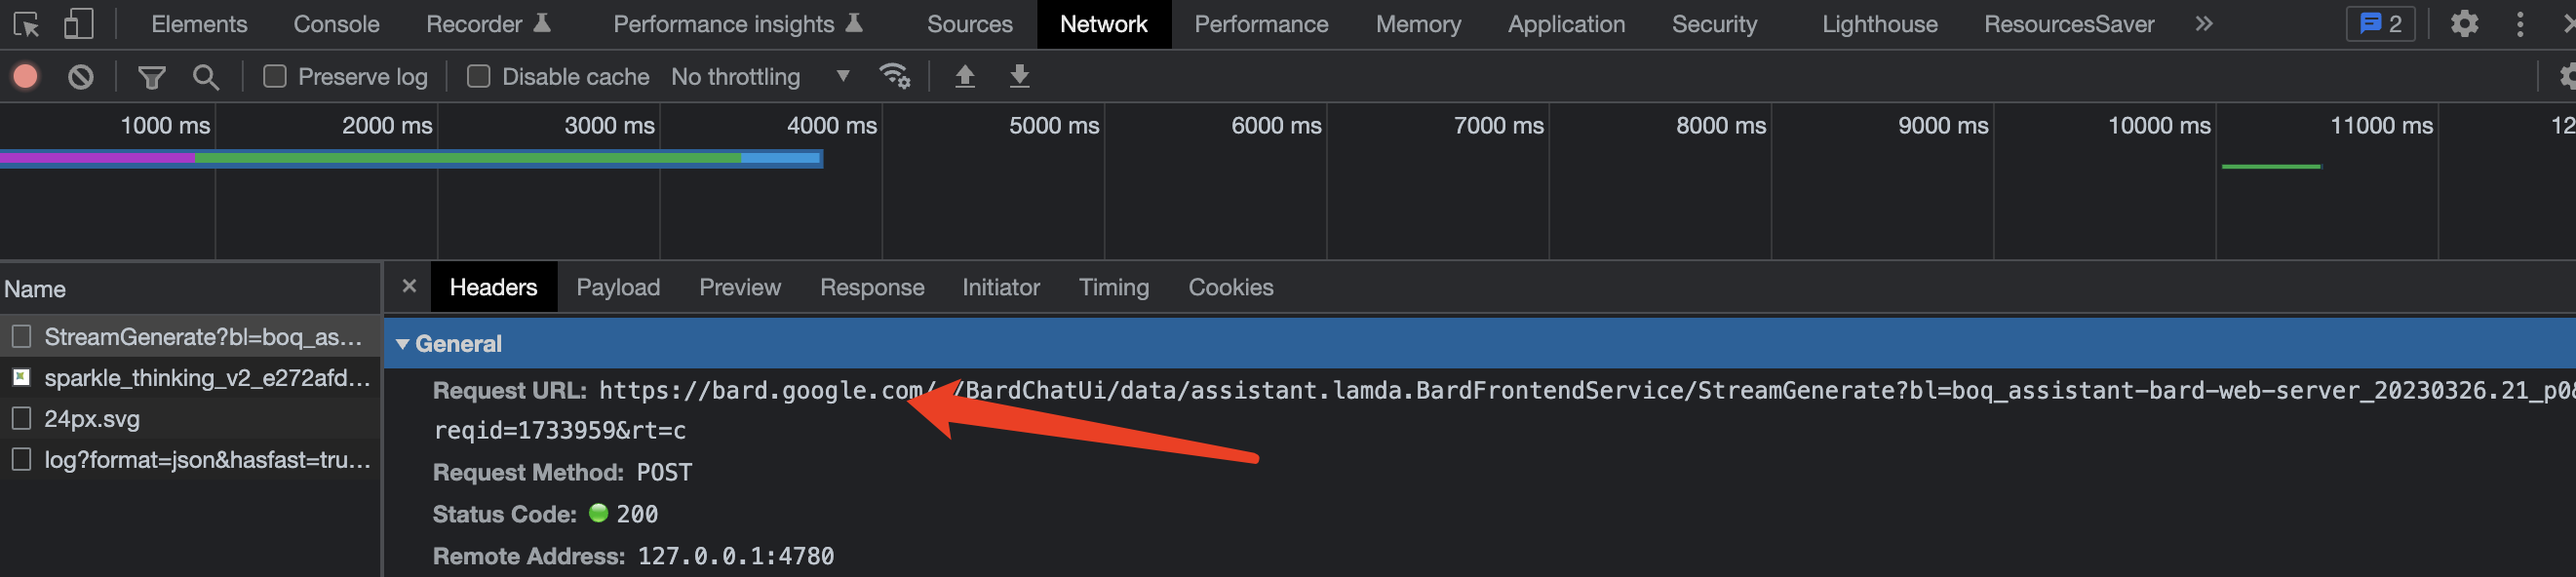
我们知道ChatGPT使用SSE协议其实是等而下之的次优选择,因为GPT模型在推理上需要时间,所以走的模式是一边推理一边返回的流式模型,关于流式返回,请移玉步至:逐句回答,流式返回,ChatGPT采用的Server-sent events后端实时推送协议Python3.10实现,基于Tornado6.1,这里不再赘述。
而Google的Bard选择一次性返回所有推理数据:
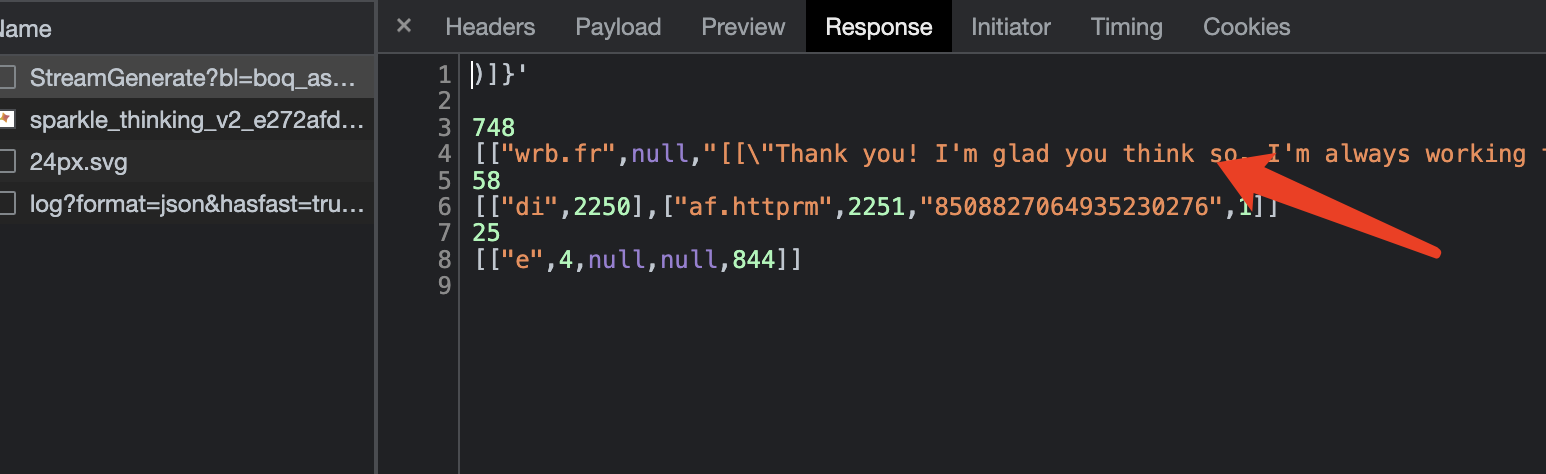
所以推理效率上,Bard要优于ChatGPT,但仅限于免费产品线,截止本文发布,ChatGPT的收费产品gpt3-turbo和gpt4的推理效率都要远远高于其免费产品。
Bard的远程接口API调用
和免费版本的ChatGPT一样,Bard目前只支持浏览器端(B端)的使用,但也可以通过浏览器保存的Token进行远程调用,首先安装Bard开源库:
pip3 install --upgrade GoogleBard
随后复制浏览器端的token秘钥:
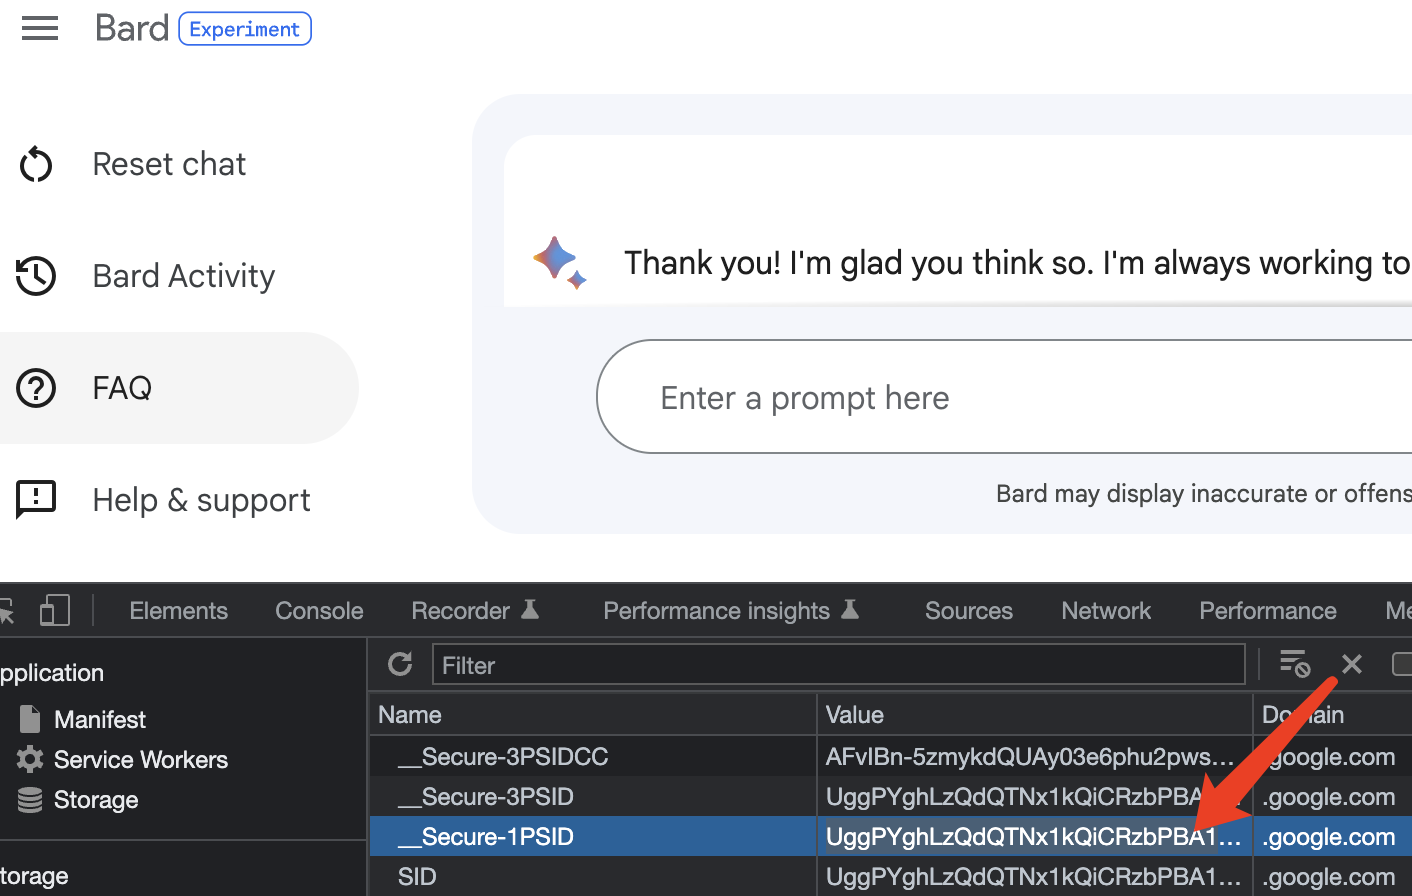
接着在终端通过Session进行注入:
python3 -m Bard --session UggPYghLzQdQTNx1kQiCRzbPBA1qhjC-dndTiIPCk3YPLR5TexmP7OQ7AfUdsfdsf1Q.
随后就可以进入终端内的对话场景,使用alt+enter组合键或者esc+enter组合键发送信息即可:
➜  work python3 -m Bard --session UggPYghLzQdQTNx1kQiCRzbPBA1qhjC-dndTiIPCk3YPLR5TexmP7OQdfgdfgdfUSg0UQ.

        Bard - A command-line interface to Google's Bard (https://bard.google.com/)

        Repo: github.com/acheong08/Bard

        Enter `alt+enter` or `esc+enter` to send a message.

You:

hi

Google Bard:

Hi there! How can I help you today?
非常方便,主要是速度相当惊艳。
结语
仅就免费版本所提供的产品力而言,Google Bard和ChatGPT可谓是各有千秋,私以为Google Bard在效率和使用逻辑上要更胜一筹,并不是网上所传言的那么不堪。所谓一枝独秀不是春,百花齐放才是春满园,Google Bard和百度的文心一言,都会对ChatGPT形成压力,让ChatGPT保持光速更新,成为更好的自己。
好饭不怕晚,Google基于人工智能AI大语言对话模型Bard测试和API调用(Python3.10)的更多相关文章
- 解读 --- 基于微软企业商务应用平台 (Microsoft Dynamics 365) 之上的人工智能 (AI) 解决方案
9月25日微软今年一年一度的Ignite 2017在佛罗里达州奥兰多市还是如期开幕了.为啥这么说?因为9月初五级飓风厄玛(Hurricane Irma) 在佛罗里达州登陆,在当地造成了挺大的麻烦.在这 ...
- 闻其声而知雅意,基于Pytorch(mps/cpu/cuda)的人工智能AI本地语音识别库Whisper(Python3.10)
前文回溯,之前一篇:含辞未吐,声若幽兰,史上最强免费人工智能AI语音合成TTS服务微软Azure(Python3.10接入),利用AI技术将文本合成语音,现在反过来,利用开源库Whisper再将语音转 ...
- 中国人工智能AI框架自主研发
中国人工智能AI框架自主研发 中国AI界争相构建AI开源框架的背后,技术和业务层面的考量因素当然重要,但也不应忽视国家层面的政策支持.对于AI基础设施的建设,中国政府在<新一代人工智能发展规划& ...
- 基于百度AI开放平台的人脸识别及语音合成
基于百度AI的人脸识别及语音合成课题 课题需求 (1)人脸识别 在Web界面上传人的照片,后台使用Java技术接收图片,然后对图片进行解码,调用云平台接口识别人脸特征,接收平台返回的人员年龄.性别.颜 ...
- 人工智能AI芯片与Maker创意接轨(下)
继「人工智能AI芯片与Maker创意接轨」的(上)篇中,认识了人工智能.深度学习,以及深度学习技术的应用,以及(中)篇对市面上AI芯片的类型及解决方案现况做了完整剖析后,系列文到了最后一篇,将带领各位 ...
- 人工智能AI芯片与Maker创意接轨 (中)
在人工智能AI芯片与Maker创意接轨(上)这篇文章中,介绍人工智能与深度学习,以及深度学习技术的应用,了解内部真实的作业原理,让我们能够跟上这波AI新浪潮.系列文来到了中篇,将详细介绍目前市面上的各 ...
- 国家制定人工智能(AI)发展战略的决策根据
在今年两会上,李彦宏的提案有何道理?提案的依据是什么?这个问题必须说清楚,对社会公众有个交代. 回想过去,早在上世纪九十年代,用"电子网络"模拟人脑的想法已经出现.这样的" ...
- DataPipeline王睿:业务异常实时自动化检测 — 基于人工智能的系统实战
大家好,先自我介绍一下,我是王睿.之前在Facebook/Instagram担任AI技术负责人,现在DataPipeline任Head of AI,负责研发企业级业务异常检测产品,旨在帮助企业一站式解 ...
- 人工智能AI Boosting HMC Memory Chip
人工智能AI Boosting HMC Memory Chip Innosilicon的AI Boosting HMC存储芯片适用于高速,高带宽和高性能存储领域,例如AI边缘,数据中心,自动化等. H ...
- 人工智能AI智能加速卡技术
人工智能AI智能加速卡技术 一. 可编程AI加速卡 1. 概述: 这款可编程AI加速器卡具备 FPGA 加速的强大性能和多功能性,可部署AI加速器IP(WNN/GNN,直接加速卷积神经网络,直接运行常 ...
随机推荐
- 【JavaScript】JS写法随笔(三) JS联动设置元素默认值
问题: 使用DOM获取元素后setAttribute("value", "1")在页面有修改此标签value的情况下,再次触发function发生不生效.无法修 ...
- 【APT】响尾蛇(SideWinder)APT组织样本分析
基础信息 名称:NDC Participants.docx类型:.docMD5:df020e81b7ca32868a8ac1f5eddd086f描述:通过远程模板注入技术加载含有CVE-2017-11 ...
- 微信小程序开发遇到的注意事项及奇怪事
1.wx.uploadFile上传文件时只支持本地文件(相册或者拍摄的),网络文件不可以,可以将网络文件用wx.downloadFile下载到本地在下载,下载以后会返回一个微信临时地址然后再下载 2. ...
- 12.15linux学习第十八天
今天老刘讲了如同天书一般的隐藏章节,第23章使用OpenLDAP部署目录服务,难度太高了.第16章使用Squid部署代理缓存服务 章节概述: 本章首先介绍代理服务的原理以及作用,然后介绍Squid服务 ...
- 使用idea从零编写SpringCloud项目-Hystrix
ps:Hystrix和Fegin里面使用的Hystrix,有些许区别.我理解的是Fegin.Hystrix主要是用于消费方在调用服务方接口时的异常处理,返回兜底数据等,而Hystrix则是消费方自己本 ...
- 【omr】linux配置omr识别项目moonlight环境
最近又做了第n次moonlight的环境配置 moonlight是相对成熟的omr系统 这里记录环境配置的基本步骤 (总的来说主要是用conda新建符合程序要求的python版本 然后装好bazel和 ...
- apt-get install 出现could not open lock file /var/lib/dpkg/lock错误问题
apt-get install 经常出现 could not open lock file /var/lib/dpkg/lock -open 错误问题 一种解决办法 1.切换到root用户 su ~ ...
- tag 总结
通用的: (((masterpiece))),((best quality)),ultra-detailed,extremely detailed CG unity 8k wallpaper,best ...
- (Linux)不挂断启动进程
环境:腾讯云Ubuntu x86_64 问题:在配置应用时,需要让他后台启动,关闭ssh连接也要可以保持后台运行 解决办法: 1.使用nohup 参考链接:https://zhuanlan.zhihu ...
- zabbix 告警说明及触发cpu告警
1. https://www.cnblogs.com/caonw/p/12766454.html 1.内存检测:Template OS Linux:vm.memory.size[available]. ...