
Hadoop YARN与MapReduce
YARN架构
ResourceManager
负责整体资源的管理 (Scheduler and ApplicationsManager)
NodeManager
向ResourceManager通过心跳汇报自己的资源情况
container容器
资源申请的基本单位(包含指定cpu, memory, disk, network资源)
NodeManager内有线程监控container资源情况,超额,NM 直接kill掉
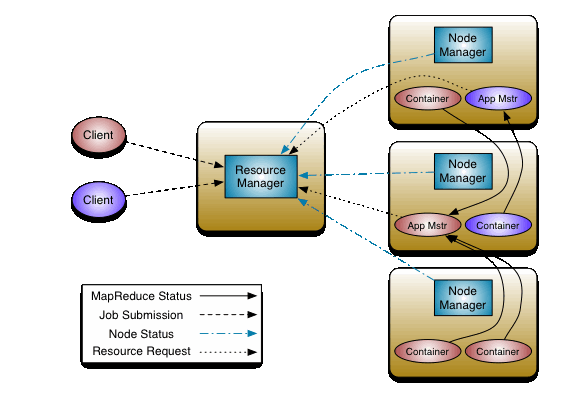
计算向数据移动实现流程:
1,MR-Client将计算的切片清单/配置/jar/上传到HDFS存储, 通知ResourceManager
2,RM收到请求选择一台不忙的节点通知NM启动一个Container,在里面反射产生一个AppMaster
3,启动AppMaster后从hdfs下载切片清单,向RM申请计算所需的资源
4,RM根据自己掌握的资源情况得到一个确定清单,通知NM来启动container
5,container启动后会反向注册到已经启动的AppMaster进程(可供AppMaster使用的资源需要注册)
6,AppMaster(起到任务调度角色)最终将任务Task发送给container(消息)
7,container收到消息,到hdfs下载client上传的jar文件到本地,反射相应的Task类为对象,调用方法执行,其结果就是我们的业务逻辑代码的执行
8,计算框架都有Task失败重试的机制(有最大失败次数限制)
注:1,每个client任务唯一对应一个AppMaster即每个任务有独立任务调度器,互相不影响(减轻单点压力,单点故障问题)
2,如果nodeManager挂掉会导致分布在该节点的任务执行失败,RM心跳会监控到任务失败,重新在其它节点分配资源重新执行
MapReduce (数据批量计算的一种方式)
计算模型:
map阶段
单条记录加工处理,一条数据记录经过map方法映射成key,value,partition 相同的key为一组
reduc阶段
按组,多条记录统计处理,一组数据调用一次reduce方法,在方法内进行迭代计算
注:map和reduce是一种阻塞关系
架构图
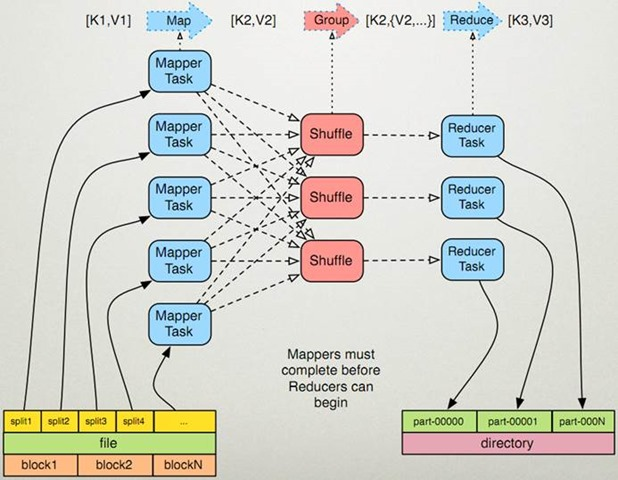
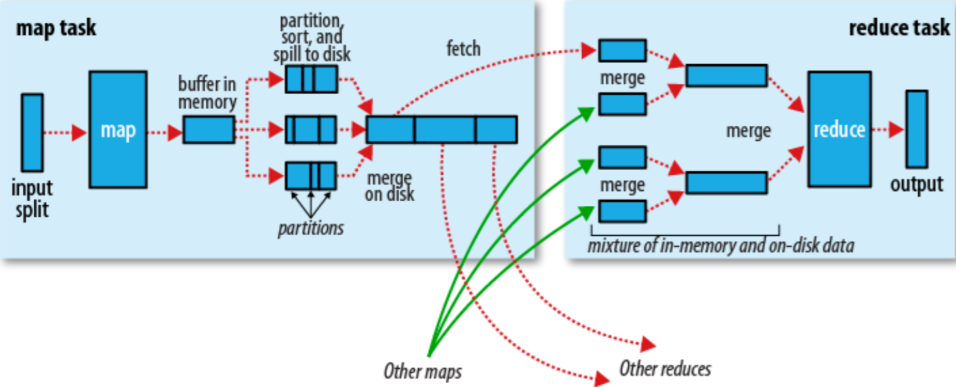
实现流程:
1,split对应map处理读取数据源,控制并行度,split是逻辑的,解耦与原数据源的关联
2,map的输出映射成K,V,K,V会参与分区计算,根据key算出Partition -> K,V,P
3,一个Map对应一个maptask进程,map输出会写入文件,写入时中间会有100M的buffer缓存,缓存区满后,先按partion排序,然后再对key进行排序,二次排序处理后写入临时文件
4,map输出的多个临时文件最终合并为一个大文件
注:进行partition排序和key排序为了同分区的同一组key会排在一起,减少reduce端的IO复杂度
数据读取
通过InputFormat决定读取的数据的类型,然后拆分成一个个InputSplit,每个InputSplit对应一个Map处理,InputSplit是逻辑分片,没有存储数据,提供了数据分片方法(getLength,getLocations)。RecordReader读取InputSplit的内容,拆分成key,value给Map处理
实现类:
TextInputFormat: 输入文件中的每一行就是一个记录,Key是这一行的byte offset,而value是这一行的内容
KeyValueTextInputFormat: 输入文件中每一行就是一个记录,第一个分隔符字符切分每行。在分隔符字符之前的内容为Key,在之后的为Value。
分隔符变量通过key.value.separator.in.input.line变量设置,默认为(\t)字符
map shufer处理
1,当Map程序开始产生结果时,并不是直接写到文件的,而是利用缓存做一些排序方面的预处理操作
每个Map任务都有一个循环内存缓冲区(默认100MB),当缓存的内容达到80%时,后台线程开始将内容写到临时文件,此时Map任务可以继续输出,如果缓冲区满了,Map任务则需要等待
2,在写入文件之前,先将数据按照Reduce进行分区。对于每一个分区,都会在内存中根据key进行排序,如果配置了Combiner,则排序后执行Combiner
Combine:对map数据处理进行聚合减少结果数据量(异写文件1次,和并小文件1次)减少shuffer IO加快reduce处理
注:每次map数据达到缓冲区的阀值时,都会将结果输出到一个文件,在Map结束时,可能会产生大量的文件,因此在Map完成前,会将这些文件进行合并和排序。
如果文件的数量超过3个,则合并后会再次运行Combiner(1、2个文件就没有必要)如果配置了压缩,则最终写入的文件会先进行压缩,这样可以减少写入和传输的数据
3,一旦Map完成,则通知任务管理器,此时Reduce就可以开始拉取对应的结果集数据进行迭代计算,将结果写入文件。
注:reduce数量默认为1 ,如果需要多个需要重写GroupCombaner。当文件数量为2(小于合并参数)则不能保证相同的key只出现一条
数据倾斜问题:
(1)重写分区器
(2)key的拼接 k0_1 k0_2 ,combiner使用。
相关参数
io.sort.mb//使用缓冲区的大小,默认100M
io.sort.spill.percent//缓冲区写文件阈值,默认0.8
min.num.spills.for.combine//combine合并文件最小数
mapred.reduce.copy.backoff//这段时间内reducer失败则会反复尝试,默认300s
参考
http://hadoop.apache.org/docs/stable/hadoop-yarn/hadoop-yarn-site/YARN.html
http://hadoop.apache.org/docs/stable/hadoop-mapreduce-client/hadoop-mapreduce-client-core/MapReduceTutorial.html
Hadoop YARN与MapReduce的更多相关文章
- MapReduce扩展:应用程序如何运行于Hadoop Yarn之上
1. 背景 “应用程序运行于Hadoop Yarn之上”的需求来源于微博运维数据平台中的调度系统,即调度系统中的任务需要运行于Hadoop Yarn之上.这里的应用程序可以简单理解为一个普通的进程 ...
- hadoop YARN配置参数剖析—MapReduce相关参数
MapReduce相关配置参数分为两部分,分别是JobHistory Server和应用程序参数,Job History可运行在一个独立节点上,而应用程序参数则可存放在mapred-site.xml中 ...
- 3.Hadoop测试Yarn和MapReduce
Hadoop测试Yarn和MapReduce 1.配置Yarn (1)配置ResourceManager 生产环境中,一般是重开一台机器作为ResourceManager,这里我们以Master机器代 ...
- Hadoop YARN配置参数剖析(3)—MapReduce相关参数
MapReduce相关配置参数分为两部分,分别是JobHistory Server和应用程序参数,Job History可运行在一个独立节点上,而应用程序参数则可存放在mapred-site.xml中 ...
- Hadoop YARN 100-1知识点
0 YARN中实体 资源管理者(resource manager, RM) 长时间运行的守护进程,负责管理集群上资源的使用 节点管理者(node manager, NM) 长时间运行的守护进程,在集群 ...
- Wordcount on YARN 一个MapReduce示例
Hadoop YARN版本:2.2.0 关于hadoop yarn的环境搭建可以参考这篇博文:Hadoop 2.0安装以及不停集群加datanode hadoop hdfs yarn伪分布式运行,有如 ...
- 怎样通过Java程序提交yarn的mapreduce计算任务
因为项目需求,须要通过Java程序提交Yarn的MapReduce的计算任务.与一般的通过Jar包提交MapReduce任务不同,通过程序提交MapReduce任务须要有点小变动.详见下面代码. 下面 ...
- Hadoop YARN配置参数剖析—RM与NM相关参数
注意,配置这些参数前,应充分理解这几个参数的含义,以防止误配给集群带来的隐患.另外,这些参数均需要在yarn-site.xml中配置. 1. ResourceManager相关配置参数 (1) ...
- Hadoop Yarn内存资源隔离实现原理——基于线程监控的内存隔离方案
注:本文以hadoop-2.5.0-cdh5.3.2为例进行说明. Hadoop Yarn的资源隔离是指为运行着不同任务的“Container”提供可独立使用的计算资源,以避免它们之间相互干扰.目 ...
- hadoop错误org.apache.hadoop.yarn.exceptions.YarnException Unauthorized request to start container
错误: 14/04/29 02:45:07 INFO mapreduce.Job: Job job_1398704073313_0021 failed with state FAILED due to ...
随机推荐
- RocketMQ Connect 构建流式数据处理平台
本文作者:孙晓健,Apache RocketMQ Committer 01 RocketMQ Connect RocketMQ Connect 是一款可扩展的在 RocketMQ 与其他系统之间做流式 ...
- tomcat下找不到运行的程序文件
1.重新部署tomcat(删掉原有的tomcat) 2.更改部署路径
- .NET周报【12月第2期 2022-12-15】
国内文章 九哥聊Kestrel网络编程第一章:开发一个Redis服务器 https://mp.weixin.qq.com/s/HJYnBE-7wbvkAYHxQaq3eQ 我和拥有多个.NET 千星开 ...
- 动态更改Spring定时任务Cron表达式的优雅方案
"Most of you are familiar with the virtues of a programmer. There are three, of course: lazines ...
- UVA 673 Paretheses Balance
原题Vjudge 题目大意 怼给你一堆括号,判断是否合法 有三条规则 (1)空串合法 (2)如果\(A和B\)都合法,则\(AB\)合法(例如:\(()和[]\)都合法,则\(()[]\)合法) (3 ...
- 自研ORM Include拆分查询(递归算法 支持无限层级) 性能优化探讨
最近我在优化 Include 拆分查询,贴出源码供大家交流探讨是否还有优化空间. 测试代码 1 Console.WriteLine($"总记录数:{db.Query<Category& ...
- python之路39 前端开始 各种标签
前端前夕 前端三剑客 HTML 网页的骨架 CSS 网页的样式 JavaScript 网页的动态 1.编写服务端 2.浏览器充当客户端访问服务端 3.浏览器无法正常展示服务端内容(因为服务端得数据没用 ...
- python之路29 网络编程基础2之 两种架构 传输层常见协议 socket模块
软件开发架构 1.C/S架构(Client:客户端和Server:服务端) 服务器-客户机,即Client-Server(C/S)结构.C/S结构通常采取两层结构.服务器负责数据的管理,客户机负责完成 ...
- ResourceQuota与LimitRange区别
ResourceQuota与LimitRange区别 ResourceQuota ResourceQuota 用来限制 namespace 中所有的 Pod 占用的总的资源 request 和 lim ...
- 刷题笔记——3002.买图书 & 2763.计算(a+b)/c的值
题目1 3002.买图书 代码 while True: try: n,m=map(float,input().strip().split()) if(n==10 and m==1): print('{ ...