
Python ArcPy批量拼接长时间序列栅格图像
本文介绍基于Python中ArcPy模块,对大量不同时相的栅格遥感影像按照其成像时间依次执行批量拼接的方法。
在前期的文章Python arcpy创建栅格、批量拼接栅格中,我们介绍了利用Python实现栅格遥感影像批量拼接的方法;但这篇文章实现的操作是将某个保存路径下全部的栅格图像文件加以拼接,换句话说,是对不同空间位置的同一时相的若干图像加以拼接,拼接结果就只有一景大的图像。而在实践中,我们经常还会需要对不同空间位置的不同时相的图像分别加以拼接,拼接结果是很多景不同时相的大的图像。那么,这种需求该怎么实现呢?
首先,我们来明确一下本文的具体需求。现有一个存储有大量.tif格式遥感影像的文件夹,其中每一个遥感影像的文件名中都包含有该图像的成像时间,如下图所示。
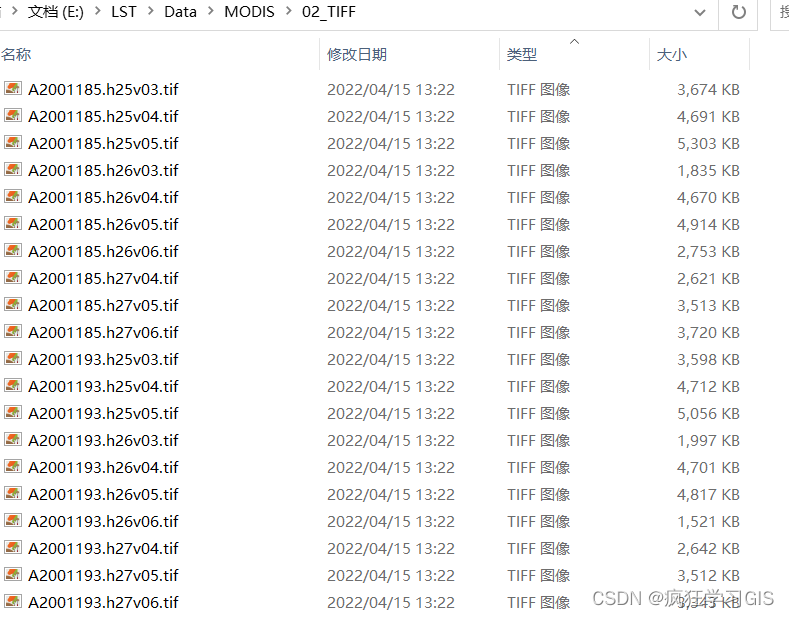
我们希望,对于同一天成像的遥感影像进行拼接——例如,上图中具有2001年第185天成像的遥感影像10幅,每一幅都是这一天在不同空间位置的成像;同时有2001年第193天成像的遥感影像10幅。我们希望首先将第185天成像的10幅遥感影像加以拼接,随后再对第193天成像的10幅遥感影像加以拼接,以此类推。在遥感影像整体数量较少时,我们或许还可以逐一手动拼接;而当图像数量很多时,就需要借助代码来实现了。
明确了需求后,我们就可以开始具体的操作。首先,本文所需用到的代码如下。
# -*- coding: utf-8 -*-

"""

Created on Fri Apr 15 13:21:55 2022

@author: fkxxgis

"""

import os

import arcpy

tif_file_path="E:/LST/Data/NDVI/02_TIFF/"

out_file_path="E:/LST/Data/NDVI/03_Mosaic/"

arcpy.env.workspace=tif_file_path

tif_file_name=arcpy.ListRasters("*","tif")

tif_file_date=tif_file_name[0][1:8]

one_day_tif_list=[]

tif_file_example_path=tif_file_path+tif_file_name[0]

cell_size_x=arcpy.GetRasterProperties_management(tif_file_example_path,"CELLSIZEX")

cell_size=cell_size_x.getOutput(0)

value_type=arcpy.GetRasterProperties_management(tif_file_example_path,"VALUETYPE")

describe=arcpy.Describe(tif_file_example_path)

spatial_reference=describe.spatialReference

for tif_file in tif_file_name:

    if tif_file[1:8]==tif_file_date:

        one_day_tif_list.append(tif_file)

        tif_file_temp=tif_file

        if tif_file==tif_file_name[len(tif_file_name)-1]:

            out_file_name=tif_file[1:8]+".tif"

            arcpy.CreateRasterDataset_management(out_file_path,out_file_name,

                                                 cell_size,"16_BIT_SIGNED",spatial_reference,"1")

            out_file=out_file_path+out_file_name

            for tif_file_new in one_day_tif_list:

                arcpy.Mosaic_management([tif_file_path+tif_file_new],out_file)

    else:

        out_file_name=tif_file_temp[1:8]+".tif"

        arcpy.CreateRasterDataset_management(out_file_path,out_file_name,

                                             cell_size,"16_BIT_SIGNED",spatial_reference,"1")

        out_file=out_file_path+out_file_name

        for tif_file_new in one_day_tif_list:

            arcpy.Mosaic_management([tif_file_path+tif_file_new],out_file)

        one_day_tif_list=[]

        one_day_tif_list.append(tif_file)

        tif_file_date=tif_file[1:8]
其中,tif_file_path是原有拼接前遥感图像的保存路径,out_file_path是我们新生成的拼接后遥感影像的保存路径。
在这里,我们需要首先在资源管理器中,将tif_file_path路径下的各文件以“名称”排序的方式进行排序;随后,利用arcpy.ListRasters()函数,获取路径下原有的全部.tif格式的图像文件,并截取第一个文件的部分文件名,从而获取其成像时间;接下来,做好创建一个新的栅格文件的准备,这一部分代码的含义在本文开头提及的那一篇文章Python arcpy创建栅格、批量拼接栅格中已有提及,这里就不再赘述。
接下来,遍历tif_file_path路径下全部.tif格式图像文件。其中,我们通过一个简单的判断语句,来确定某一成像时间的遥感影像是否已经读取完毕——如果已经读取完毕,例如假如第185天成像的10幅遥感影像都已经遍历过了,那么就对这十景遥感影像加以拼接;如果还没有读取完毕,例如假如第185天成像的10幅遥感影像目前仅遍历到了第8幅,那么就不拼接,继续往下遍历。
这里相信大家也看到了为什么我们要在前期先将文件夹中的文件按照“名称”排序——是为了保证同一成像时间的所有遥感影像都排列在一起,遍历时只要遇到一个新的成像时间,程序就知道上一个成像时间的所有图像都已经遍历完毕了,就可以将上一个成像时间的所有栅格图像加以拼接。
最后,通过tif_file==tif_file_name[len(tif_file_name)-1]这个判断,来确认是否目前已经遍历到文件夹中的最后一个图像文件。如果是的话,就需要将当前成像时间的所有图像进行拼接,并完成代码的运行。
在 IDLE (Python GUI) 中运行代码。代码运行完毕后,我们开看一下结果文件夹。可以看到,其中的图像已经是按照成像时间,分别完成拼接后的结果了。

至此,大功告成。
Python ArcPy批量拼接长时间序列栅格图像的更多相关文章
- < python PIL - 批量图像处理 - 生成自定义大小图像 >
< python PIL - 批量图像处理 - 生成自定义大小图像 > 直接用python自带的PIL图像库,对一个文件夹下所有jpg/png的图像进行自定义像素变换 from PIL i ...
- < python PIL - 批量图像处理 - RGB图像生成灰度图像 >
< python PIL - 批量图像处理 - RGB图像生成灰度图像 > 直接用python自带的PIL图像库,将一个文件夹下所有jpg/png的RGB图像转换成灰度/黑白图像 from ...
- ArcGis Python脚本——批量添加字段
先看如何增加一个字段 函数:arcpy.AddField_management 语法:AddFields_management (in_table, field_description) 参数 说明 ...
- python脚本批量生成数据
在平时的工作中,经常会遇到造数据,特别是性能测试的时候更是需要大量的数据.如果一条条的插入数据库或者一条条的创建数据,效率未免有点低.如何快速的造大量的测试数据呢?在不熟悉存储过程的情况下,今天给大家 ...
- PIE SDK打开长时间序列数据
1. 功能简介 时间序列数据(time series data)是在不同时间上收集到的数据,这类数据是按时间顺序收集到的,用于所描述现象随时间变化的情况.当前随着遥感卫星技术日新月异的发展,遥感卫星的 ...
- Python 图像处理 OpenCV (4):图像算数运算以及修改颜色空间
前文传送门: 「Python 图像处理 OpenCV (1):入门」 「Python 图像处理 OpenCV (2):像素处理与 Numpy 操作以及 Matplotlib 显示图像」 「Python ...
- Python 图像处理 OpenCV (16):图像直方图
前文传送门: 「Python 图像处理 OpenCV (1):入门」 「Python 图像处理 OpenCV (2):像素处理与 Numpy 操作以及 Matplotlib 显示图像」 「Python ...
- Python用Pillow(PIL)进行简单的图像操作
Python用Pillow(PIL)进行简单的图像操作 颜色与RGBA值 计算机通常将图像表示为RGB值,或者再加上alpha值(通透度,透明度),称为RGBA值.在Pillow中,RGBA的值表示为 ...
- Python 实现批量从不同的Linux服务器下载文件
基于Python实现批量从不同的Linux服务器下载文件 by:授客 QQ:1033553122 实现功能 1 测试环境 1 使用方法 1 1. 编辑配置文件conf/file_for_downl ...
- Python基于Python实现批量上传文件或目录到不同的Linux服务器
基于Python实现批量上传文件或目录到不同的Linux服务器 by:授客 QQ:1033553122 实现功能 1 测试环境 1 使用方法 1 1. 编辑配置文件conf/rootpath_fo ...
随机推荐
- 循环2-if与case语法
一.if语法结构 1. 单分支结构 if < 条件表达式 > then 指令 fi 或者 if < 条件表达式 >:then 指令 fi 2. 双分支结构 if < 条件 ...
- 第二章:用Python对不同的商品销售数据进行预测分析
文章目录 项目背景 获取数据 线性数据预测 非线性数据预测 源码地址 本文分享知识: os 模块获取上一级目录的绝对地址 pands 读取 sqlite3 数据库中的数据 用sklearn中的线性回归 ...
- Flink 中 DataStream 和 DataSet区别
DataSet与DataStream的区别.使用 DataSet同DataStream从其接口封装.真实计算Operator有很大的差别,Dataset的实现在flink-javamodule中,而D ...
- 项目实训 DAY8
功能页面开发完毕,实现了两种工具(d3.js/echarts.js)的可视化效果,并与前端整合完毕. 项目实训步入尾声,最后的几(一)天大概就是完善最后的工作,准备答辩.
- jmeter dubbo测试
一.环境准备 1.安装jmeter 2.安装dubbo插件,下载地址jmeter-plugins-dubbo, 将jar包放入${JMETER_HOME}\lib\ext路径下,重启即可 二.添加一个 ...
- COLMAP论文阅读笔记——sfm算法、不定期更新
文章目录 structure from motion revisited 第一步 对应点搜索 特征提取feature extraction 匹配matching 几何验证geometric verif ...
- 尝试改善科研V2
参考链接: https://fulequn.github.io/2022/09/26/Article202209261/ https://www.xljsci.com/ https://apps.an ...
- ReactHooks_useState
import { useState } from "react"; import './App.css'; function App() { const [redBorder, ...
- Linux命令 之 contrab
crontab 命令是用来在linux平台上执行 定时任务的命令: 默认是在安装完操作系统之后,便会启动此任务的调度 crontab 会在每分钟检查是否有要执行的任务,如果有便会执行该任务:新建的cr ...
- Glass Beads
UVA719 将循环串SSS展开成两倍大小:S+SS+SS+S,这样线性处理就可以处理所有循环的情况了.对S+SS+SS+S建立一个后缀自动机,让后从初始状态开始走,每次选择字典序最小的道路,走NNN ...