
11.Java SDK源码分析系列笔记-Hashtable
1. 是什么
线程安全的hashmap
2. 如何使用
public class HashtableTest

{

    public static void main(String[] args) throws InterruptedException

    {

        Hashtable<Integer, Integer> map = new Hashtable<>();

        Thread thread1 = new Thread(()->{

            for (int i = 0; i < 100000; i++)

            {

                map.put(i, i);

            }

        });

        Thread thread2 = new Thread(()->{

            for (int i = 100000; i < 200000; i++)

            {

                map.put(i, i);

            }

        });

        thread1.start();

        thread2.start();

        thread1.join();

        thread2.join();

        System.out.println(map);

        System.out.println(map.size());

        for (int i = 0; i < 200000; i++)

        {

            if (!map.contains(i))

            {

                throw new RuntimeException("并发put有问题");//不会抛出异常说明并发put没问题

            }

            System.out.println(map.remove(i));

        }

    }

}
3. 原理分析
3.1. uml
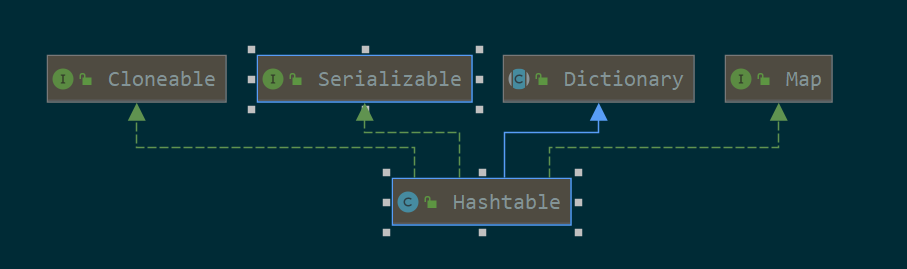
可克隆,可序列化,实现了Map接口
3.2. 构造方法
使用链地址法(单链表)解决Hash冲突
初始化容量为11,默认的加载因子为0.75
public class Hashtable<K,V>

    extends Dictionary<K,V>

    implements Map<K,V>, Cloneable, java.io.Serializable {

    //使用Entry数组实现

    private transient Entry<?,?>[] table;

    //map中实际元素的个数

    private transient int count;

    //以下两个决定了什么时候扩容

    private int threshold;

    private float loadFactor;

    private transient int modCount = 0;

    public Hashtable() {

    	//初始化容量为11,加载因子为0.75

        this(11, 0.75f);

    }

    public Hashtable(int initialCapacity, float loadFactor) {

        //检查参数合法

        if (initialCapacity < 0)

            throw new IllegalArgumentException("Illegal Capacity: "+

                                               initialCapacity);

        if (loadFactor <= 0 || Float.isNaN(loadFactor))

            throw new IllegalArgumentException("Illegal Load: "+loadFactor);

        if (initialCapacity==0)

            initialCapacity = 1;

        this.loadFactor = loadFactor;

        //创建table数组

        table = new Entry<?,?>[initialCapacity];

        //threshold取int MAX_ARRAY_SIZE = Integer.MAX_VALUE  8和initialCapacity * loadFactor中的小者

        threshold = (int)Math.min(initialCapacity * loadFactor, MAX_ARRAY_SIZE + 1);

    }

}
3.3. put方法
//加了synchronized

public synchronized V put(K key, V value) {

    // Make sure the value is not null

    //与HashMap不同,这里value不能为null

    if (value == null) {

        throw new NullPointerException();

    }

    // Makes sure the key is not already in the hashtable.

    Entry<?,?> tab[] = table;

    int hash = key.hashCode();

    //计算下标

    int index = (hash & 0x7FFFFFFF) % tab.length;

    @SuppressWarnings("unchecked")

    Entry<K,V> entry = (Entry<K,V>)tab[index];

    //遍历链表直到找到相等的节点或者到末尾

    for(; entry != null ; entry = entry.next) {

    	//找到了,替换value

        if ((entry.hash == hash) && entry.key.equals(key)) {

            V old = entry.value;

            entry.value = value;

            return old;

        }

    }

	//没有找到,新建节点加入链表

    addEntry(hash, key, value, index);

    return null;

}
3.3.1. 使用synchronized加锁
public synchronized V put(K key, V value) {

//...

}
3.3.2. 计算key落在entry数组中的哪个位置【或者说哪个链表】
Entry<?,?> tab[] = table;

int hash = key.hashCode();

//计算下标

//计算index是通过对数组长度取模而不是使用与操作

int index = (hash & 0x7FFFFFFF) % tab.length;

@SuppressWarnings("unchecked")

Entry<K,V> entry = (Entry<K,V>)tab[index];
3.3.3. 遍历链表直到找到相等的节点或者到末尾
//遍历链表直到找到相等的节点或者到末尾

for(; entry != null ; entry = entry.next) {

	//找到了,替换value

    if ((entry.hash == hash) && entry.key.equals(key)) {

        V old = entry.value;

        entry.value = value;

        return old;

    }

}
3.3.4. 没有找到,新建节点加入链表头部
- addEntry方法
private void addEntry(int hash, K key, V value, int index) {

    modCount++;

    Entry<?,?> tab[] = table;

    //判断是否需要扩容

    if (count >= threshold) {

        // Rehash the table if the threshold is exceeded

        rehash();

        tab = table;

        hash = key.hashCode();

        index = (hash & 0x7FFFFFFF) % tab.length;

    }

    // Creates the new entry.

    @SuppressWarnings("unchecked")

    Entry<K,V> e = (Entry<K,V>) tab[index];

    //新建节点并且直接放入数组相应位置

    tab[index] = new Entry<>(hash, key, value, e);

    count++;

}
3.3.4.1. 扩容
- rehash方法
@SuppressWarnings("unchecked")

protected void rehash() {

    int oldCapacity = table.length;

    Entry<?,?>[] oldMap = table;

    // overflowconscious code

    //新capacity=旧capacity*2+1

    int newCapacity = (oldCapacity << 1) + 1;

    //如果容量超过了MAX_ARRAY_SIZE(int MAX_ARRAY_SIZE = Integer.MAX_VALUE  8),那么以MAX_ARRAY_SIZE为准

    if (newCapacity  MAX_ARRAY_SIZE > 0) {

        if (oldCapacity == MAX_ARRAY_SIZE)

            // Keep running with MAX_ARRAY_SIZE buckets

            return;

        newCapacity = MAX_ARRAY_SIZE;

    }

    //以新capacity创建新数组

    Entry<?,?>[] newMap = new Entry<?,?>[newCapacity];

    modCount++;

    threshold = (int)Math.min(newCapacity * loadFactor, MAX_ARRAY_SIZE + 1);

    table = newMap;

	//由后往前遍历entry数组

    for (int i = oldCapacity ; i > 0 ;) {

    	//从头到尾遍历链表

        for (Entry<K,V> old = (Entry<K,V>)oldMap[i] ; old != null ; ) {

        	//e表示此次要迁移的节点,old表示下一个要迁移的节点

            Entry<K,V> e = old;

            old = old.next;

			//计算e在新entry数组中的位置

            int index = (e.hash & 0x7FFFFFFF) % newCapacity;

            //把e的next指向新entry数组中的位置(链表的头节点)

            e.next = (Entry<K,V>)newMap[index];

            //再把新entry数组中的位置赋值为e

            //等于就是头插法

            newMap[index] = e;

        }

    }

}
3.4. get方法
//加了synchronized

public synchronized V get(Object key) {

    Entry<?,?> tab[] = table;

    int hash = key.hashCode();

    //计算在那个链表中

    int index = (hash & 0x7FFFFFFF) % tab.length;

    //遍历链表找到相等的节点

    for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) {

        if ((e.hash == hash) && e.key.equals(key)) {

            return (V)e.value;

        }

    }

    return null;

}
3.4.1. 使用synchronized加锁
public synchronized V get(Object key) {

}
3.4.2. 计算key落在entry数组中的哪个位置【或者说哪个链表】
Entry<?,?> tab[] = table;

int hash = key.hashCode();

//计算在那个链表中

int index = (hash & 0x7FFFFFFF) % tab.length;
3.4.3. 遍历链表直到找到相等的节点或者到末尾
//遍历链表找到相等的节点

for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) {

    if ((e.hash == hash) && e.key.equals(key)) {

        return (V)e.value;

    }

}
3.5. remove方法
使用synchronized修饰
同get方法找到节点,删除的操作就是链表节点的删除操作
public synchronized V remove(Object key) {

	Entry<?,?> tab[] = table;

	int hash = key.hashCode();

	int index = (hash & 0x7FFFFFFF) % tab.length;

	@SuppressWarnings("unchecked")

	Entry<K,V> e = (Entry<K,V>)tab[index];

	for(Entry<K,V> prev = null ; e != null ; prev = e, e = e.next) {

		if ((e.hash == hash) && e.key.equals(key)) {

		    modCount++;

		    if (prev != null) {

		    	//不是头节点

		        prev.next = e.next;

		    } else {

		    	//头节点

		        tab[index] = e.next;

		    }

		    count;

		    //help GC

		    V oldValue = e.value;

		    e.value = null;

		    return oldValue;

		}

	}

	return null;

}
3.5.1. 使用synchronized加锁
public synchronized V remove(Object key) {

}
3.5.2. 计算key落在entry数组中的哪个位置【或者说哪个链表】
Entry<?,?> tab[] = table;

int hash = key.hashCode();

int index = (hash & 0x7FFFFFFF) % tab.length;

@SuppressWarnings("unchecked")

Entry<K,V> e = (Entry<K,V>)tab[index];
3.5.3. 遍历链表直到找到相等的节点或者到末尾,把value置为null
@SuppressWarnings("unchecked")

Entry<K,V> e = (Entry<K,V>)tab[index];

for(Entry<K,V> prev = null ; e != null ; prev = e, e = e.next) {

	if ((e.hash == hash) && e.key.equals(key)) {

	    modCount++;

	    if (prev != null) {

	    	//不是头节点

	        prev.next = e.next;

	    } else {

	    	//头节点

	        tab[index] = e.next;

	    }

	    count;

	    //help GC

	    V oldValue = e.value;

	    e.value = null;

	    return oldValue;

	}

}
3.6. containsKey方法
//加了synchronized

public synchronized boolean containsKey(Object key) {

	//以下逻辑同get方法

    Entry<?,?> tab[] = table;

    int hash = key.hashCode();

    int index = (hash & 0x7FFFFFFF) % tab.length;

    for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) {

        if ((e.hash == hash) && e.key.equals(key)) {

            return true;

        }

    }

    return false;

}
3.6.1. 使用synchronized加锁
public synchronized boolean containsKey(Object key) {

}
3.6.2. 计算key落在entry数组中的哪个位置【或者说哪个链表】
Entry<?,?> tab[] = table;

int hash = key.hashCode();

int index = (hash & 0x7FFFFFFF) % tab.length;
3.6.3. 遍历链表直到找到相等的节点或者到末尾
for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) {

    if ((e.hash == hash) && e.key.equals(key)) {

        return true;

    }

}

return false;
11.Java SDK源码分析系列笔记-Hashtable的更多相关文章
- spring源码分析系列 (8) FactoryBean工厂类机制
更多文章点击--spring源码分析系列 1.FactoryBean设计目的以及使用 2.FactoryBean工厂类机制运行机制分析 1.FactoryBean设计目的以及使用 FactoryBea ...
- Spring mvc源码分析系列--Servlet的前世今生
Spring mvc源码分析系列--Servlet的前世今生 概述 上一篇文章Spring mvc源码分析系列--前言挖了坑,但是由于最近需求繁忙,一直没有时间填坑.今天暂且来填一个小坑,这篇文章我们 ...
- jQuery源码分析系列
声明:本文为原创文章,如需转载,请注明来源并保留原文链接Aaron,谢谢! 版本截止到2013.8.24 jQuery官方发布最新的的2.0.3为准 附上每一章的源码注释分析 :https://git ...
- MyCat源码分析系列之——结果合并
更多MyCat源码分析,请戳MyCat源码分析系列 结果合并 在SQL下发流程和前后端验证流程中介绍过,通过用户验证的后端连接绑定的NIOHandler是MySQLConnectionHandler实 ...
- MyCat源码分析系列之——BufferPool与缓存机制
更多MyCat源码分析,请戳MyCat源码分析系列 BufferPool MyCat的缓冲区采用的是java.nio.ByteBuffer,由BufferPool类统一管理,相关的设置在SystemC ...
- jquery2源码分析系列
学习jquery的源码对于提高前端的能力很有帮助,下面的系列是我在网上看到的对jquery2的源码的分析.等有时间了好好研究下.我们知道jquery2开始就不支持IE6-8了,从jquery2的源码中 ...
- [Tomcat 源码分析系列] (二) : Tomcat 启动脚本-catalina.bat
概述 Tomcat 的三个最重要的启动脚本: startup.bat catalina.bat setclasspath.bat 上一篇咱们分析了 startup.bat 脚本 这一篇咱们来分析 ca ...
- [转]jQuery源码分析系列
文章转自:jQuery源码分析系列-Aaron 版本截止到2013.8.24 jQuery官方发布最新的的2.0.3为准 附上每一章的源码注释分析 :https://github.com/JsAaro ...
- MyBatis 源码分析系列文章导读
1.本文速览 本篇文章是我为接下来的 MyBatis 源码分析系列文章写的一个导读文章.本篇文章从 MyBatis 是什么(what),为什么要使用(why),以及如何使用(how)等三个角度进行了说 ...
- spring源码分析系列
spring源码分析系列 (1) spring拓展接口BeanFactoryPostProcessor.BeanDefinitionRegistryPostProcessor spring源码分析系列 ...
随机推荐
- 【长知识】BIOS
设置最新UEFI BIOS 本章导读 BIOS是电脑启动和操作的基础,若电脑系统中没有BIOS,则所有硬件设备都不能正常使用.UEFI是目前最新的BIOS类型,以后会逐渐取代传统的BIOS.本章将认识 ...
- map标签是什么
<map>标签用于在HTML中定义一个 图像映射(image map),它允许你将图像划分为多个可点击的区域(称为"热点"),每个区域可以链接到不同的URL或执行不同的 ...
- Git 覆盖刚刚 commit 的 message
场景重现 通常噼里啪啦键盘一段猛搓后(写代码啊),然后会 git add . git commit -m "modify semo" # 注意上面 semo 应该是 some,发现 ...
- python 入门专辑资料整理学习
Python 是一门开源免费.通用型的脚本编程语言,它上手简单,功能强大,坚持极简主义. Python 类库(模块)极其丰富,这使得 Python 几乎无所不能,不管是传统的 Web 开发.PC 软件 ...
- ChirpStack 设备连通性测试极简工具
一.工具简介 你是否为调试 ChirpStack 设备数据连通性而烦恼?是否希望快速验证数据解析逻辑而无需复杂部署?这个 ChirpStack 数据连通性测试工具,算是一个极简解决方案! 无论是 Ch ...
- Goland搭建Go开发环境
1.下载和安装Golang 下载链接: 谷歌链接:https://golang.google.cn/dl/ 国内链接:https://studygolang.com/dl 安装示意图: 安装完成后配置 ...
- 2024dsfz集训Day1:贪心算法
DAY1:贪心算法 \[Designed\ By\ FrankWkd\ -\ Luogu@Lwj54joy,uid=845400 \] 特别感谢 此次课的主讲 - Kwling 经典模型: 硬币问题: ...
- GC垃圾收集时,居然还有用户线程在奔跑
之前面试被问到过"当GC垃圾收集时,是所有的用户线程都停止了吗?",这一篇我们来探究一下这个问题. 其实执行本地代码的线程仍然可以运行,那么这些线程一旦改变了对象中的引用关系或创建 ...
- VUE环境搭建(一)——NPM安装
VUE环境搭建--NPM安装 npm: Nodejs下的包管理器. webpack: 它主要的用途是通过CommonJS的语法把所有浏览器端需要发布的静态资源做相应的准备,比如资源的合并和打包. vu ...
- Java线程控制: sleep、yield、join深度解析
结论先行 sleep:主动让出CPU但保持锁,适合控制执行节奏和优化CPU占用 yield:建议让出CPU但无强制力,适用场景有限且效果不稳定 join:通过等待机制实现线程顺序控制,底层基于wait ...