
如何利用1%的数据优化特定领域LLM预训练? | EMNLP'24
来源:晓飞的算法工程笔记 公众号,转载请注明出处
论文: Target-Aware Language Modeling via Granular Data Sampling
创新点
- 提出了一种将预先训练好的标记符与多粒度标记符合并的算法,生成高效的
n-gram特征,而且与下游任务的性能有很高的相关性。 - 利用上述研究成果,改进了基于重要性的数据采样技术,将通用词汇集调整为目标词汇集。这样就能更好地代表数据,提高模型在目标任务中的性能,同时在非目标任务中保持良好的性能。
内容概述
语言模型的预训练通常针对广泛的使用场景,并结合来自多种来源的数据。然而,有时模型需要在特定领域中表现良好,同时又不影响其他领域的性能。这就需要使用数据选择方法来确定潜在核心数据,以及如何有效地对这些选定数据进行抽样训练。
论文使用由多粒度标记组成的n-gram特征进行重要性抽样,这在句子压缩和表征能力之间取得了良好的平衡。抽样得到的数据与目标下游任务性能之间有很高的相关性,同时保留了其在其他任务上的有效性,使得语言模型可以在选定文档上更高效地进行预训练。
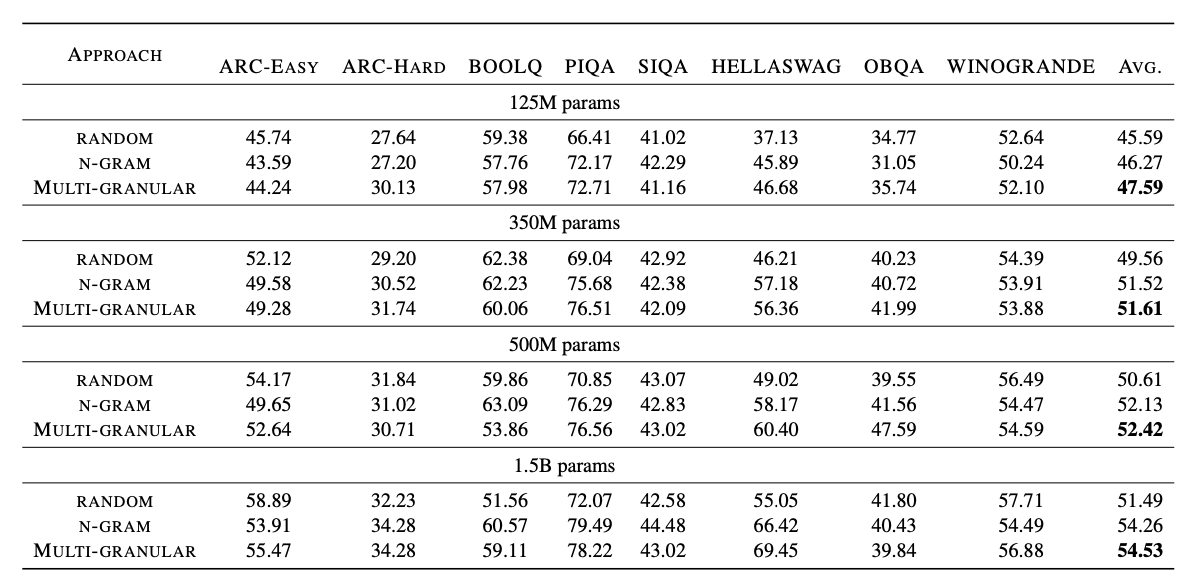
在八个基准测试中,在使用约1%的数据时,预训练模型的表现与完整的RefinedWeb数据相当,并且在模型规模范围为125M到1.5B时,超越了随机选择的样本。
方法
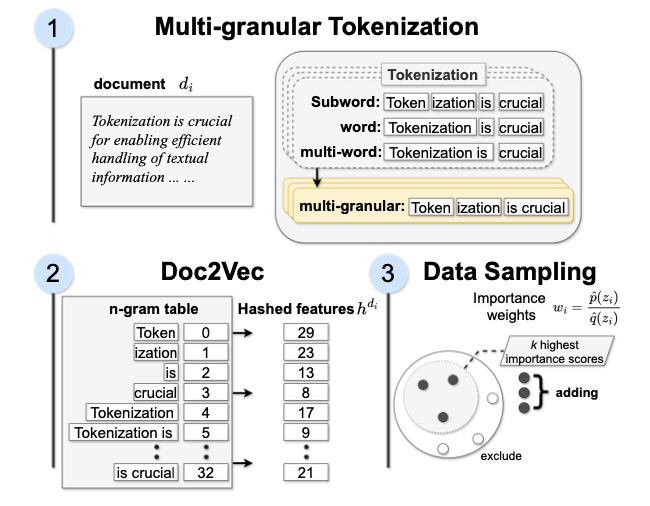
从大规模数据集(如RefinedWeb)中选择样本是缓慢且昂贵的,一个可行的解决方案是使用容易计算的n-gram特征将每个文档编码为向量。
假设从目标分布 \(p\) 中获取了一小部分目标文本示例 \(D_{task}\) ,以及从分布 \(q\) 中获取的大量原始数据集 \(D_{raw}\) ,其中包含 \(N\) 个示例,目标是从原始数据集中选择 \(k\) 个示例( \(k \ll N\) ),这些示例与目标相似。
重要性采样
重要性采样技术选择与目标分布对齐的示例,为每个文本提供可处理的重要性估计,并在提供必要结构的特征空间 \({\mathbb{Z}}\) 上应用重要性采样。
特征提取器 \(h: {\mathbb{X}} \rightarrow {\mathbb{Z}}\) 用于转换输入为特征,得到的原始特征分布 \(q_{\text{feat}}\) 和目标特征分布 \(p_{\text{feat}}\) ,目标是选择特征与目标特征分布 \(p_{\text{feat}}\) 对齐的数据。
为了提取特征 \(q_{\text{feat}}\) 和 \(p_{\text{feat}}\),从每个分词文档中提取n-grams。每个n-gram被映射到哈希表中的一个键,每个键映射到n-gram计数。将从 \(N\) 个原始示例中获得的每个特征 \(z_i = h(x_i)\) 计算重要性权重,权重为 \(w_i = \frac{\hat{p}_{\text{feat}}(z_i)}{\hat{q}_{\text{feat}}(z_i)}\) 。
最后进行采样,从一个分布中选择 \(k\) 个示例,且不进行替换,其概率由 \(\frac{w_i}{\sum_{i=1}^N w_i}\) 给出。
分词器适配
为了推导目标词汇 \(V(t)\) ,使用Llama-3分词器的词汇 \(V_{start}\) 作为起点,并将 \(V_{start}\) 与从任务数据 \(D_{task}\) 中学习到的 \(V_{task}\) 合并。在构建 \(V_{task}\) 时,确保包含多粒度的标记(即单词和多词组合),然后将 \(V_{task}\) 与 \(V_{start}\) 合并形成 \(v(t - 1)\) 。
接下来,逐步从 \(v(t - 1)\) 中移除标记,以获得 \(v(t)\) ,在此过程中,最小化与原始词汇集的距离,以便提取更少偏倚的文档特征作为n-gram向量。
首先定义一个度量来衡量语料库中词汇集的质量,然后通过最大化词汇效用度量 ( \(\mathcal{H}_{v}\) ) 来学习最佳词汇,该度量的计算公式为:
\mathcal{H}_{v} = - \frac{1}{l_{v}}\sum_{j \in v } P(j)\log P(j),
\end{equation}
\]
其中, \(P(j)\) 是来自目标数据的标记 \(j\) 的相对频率,而 \(l_{v}\) 是词汇 \(v\) 中标记的平均长度。对于任何词汇,其熵得分 \(\mathcal{H}_{v}\) 基于其前一步的词汇进行计算,优化问题可以表述为:
\text{arg\ min}_{v(t-1), v(t)} \big [ \mathcal{H}{v(t)} - \mathcal{H}{v(t-1)} \big ]
\end{equation}
\]
其中, \(v(t)\) 和 \(v(t - 1)\) 是包含所有词汇的两个集合,大小的上限分别为 \(|v(t)|\) 和 \(|v(t - 1)|\) 。设置 \(|v(t)| = 10k\) ,其中 \(t=10\) ,而 \(|v(0)|\) 是默认的Llama-3 tokenizer的词汇大小。
主要实验
如果本文对你有帮助,麻烦点个赞或在看呗~
更多内容请关注 微信公众号【晓飞的算法工程笔记】

如何利用1%的数据优化特定领域LLM预训练? | EMNLP'24的更多相关文章
- [2017-08-25]100行CSharp代码利用dynamic写个DSL(特定领域语言)
最近看<CLR via C#(第4版)> 读到第五章末尾dynamic基元类型时,看了下作者的一个利用dynamic动态调用string类型的Contains方法(静态方法)的实现,突然发 ...
- oracle12c中新能优化新特性之热度图和自动数据优化
1. Oracle12c热度图和自动数据优化 信息生命周期管理(ILM)是指在数据生命周期内管理它们的策略.依赖于数据的年龄和对应用的业务相关性,数据能被压缩,能被归档或移到低成本的存储上.简言之,I ...
- 机器学习实战 - 读书笔记(14) - 利用SVD简化数据
前言 最近在看Peter Harrington写的"机器学习实战",这是我的学习心得,这次是第14章 - 利用SVD简化数据. 这里介绍,机器学习中的降维技术,可简化样品数据. 基 ...
- 基于特定领域国土GIS应用框架设计及应用
基于特定领域国土GIS应用框架 设计及应用 何仕国 2012年8月16日 摘要: 本文首先讲述了什么是框架和特定领域框架,以及与国土GIS 这个特定领 ...
- 【机器学习实战】第14章 利用SVD简化数据
第14章 利用SVD简化数据 SVD 概述 奇异值分解(SVD, Singular Value Decomposition): 提取信息的一种方法,可以把 SVD 看成是从噪声数据中抽取相关特征.从生 ...
- mysql查询优化之四:优化特定类型的查询
本文将介绍如何优化特定类型的查询. 1.优化count()查询count()聚合函数,以及如何优化使用了该函数的查询,很可能是mysql中最容易被误解的前10个话题之一 count() 是一个特殊的函 ...
- Android开发之利用SQLite进行数据存储
Android开发之利用SQLite进行数据存储 Android开发之利用SQLite进行数据存储 SQLite数据库简单介绍 Android中怎样使用SQLite 1 创建SQLiteOpenHel ...
- DSSA特定领域软件体系结构
一.何为DSSA 特定领域软件架构(Domain Specific Software Architecture,DSSA)是一种有效实现特定领域软件重用的手段.简单地说,DSSA就是在一个特定应用领域 ...
- [刘阳Java]_MySQL数据优化总结_查询备忘录
数据库优化是在后端开发中必备技能,今天写一篇MySQL数据优化的总结,供大家看看 一.MySQL数据库优化分类 我们通过一个图片形式来看看数据优化一些策略问题 不难看出,优化有两条路可以选择:硬件与技 ...
- python-数据描述与分析2(利用Pandas处理数据 缺失值的处理 数据库的使用)
2.利用Pandas处理数据2.1 汇总计算当我们知道如何加载数据后,接下来就是如何处理数据,虽然之前的赋值计算也是一种计算,但是如果Pandas的作用就停留在此,那我们也许只是看到了它的冰山一角,它 ...
随机推荐
- Windows 服务管理
创建服务 New-Service -Name NAME -BinaryPathName COMMAND -StartupType Automatic -Description DESCRIPTION ...
- C++ lambda 引用捕获临时对象引发 core 的案例
今天复习前几年在项目过程中积累的各类技术案例,有一个小的 coredump 案例,当时小组里几位较资深的同事都没看出来,后面是我周末查了两三个小时解决掉的,今天再做一次系统的总结,给出一个复现的案例代 ...
- c++学习笔记(一):内存分区模型
目录 内存分区模型 程序运行前 程序运行后 new操作符 内存分区模型 c++在执行时,将内存大方向划分为4个区域 代码区:存放函数体的二进制代码,由操作系统进行管理(编写的所有代码都会存放到该处) ...
- .net7(.net core) 依赖注入:从 AddSingleton 注册的类里面访问 AddScoped 的问题
记录一下以免忘记. 今天从NopCommerce开源项目里面把它的任务调度类拆出来到我的项目用的时候,发现报错,报错信息如下 Some services are not able to be cons ...
- tarjan—算法的神(一)
本篇包含 tarjan 求强连通分量.边双连通分量.割点 部分, tarjan 求点双连通分量.桥(割边)在下一篇. 伟大的 Robert Tarjan 创造了众多被人们所熟知的算法及数据结构,最著名 ...
- .net core8 使用Swagger(附当前源码)
说明 该文章是属于OverallAuth2.0系列文章,每周更新一篇该系列文章(从0到1完成系统开发). 该系统文章,我会尽量说的非常详细,做到不管新手.老手都能看懂. 说明:OverallAuth2 ...
- 学习高校课程-软件设计模式-软件设计原则(lec2)
Feature of Good Design (1) 优秀设计的特点(一) Code reuse 代码复用 – Challenge: tight coupling between components ...
- Angular 17+ 高级教程 – Routing 路由 (功能篇)
前言 这篇只讲功能不讲原理.没有循序渐进,没有由浅入深,一个主题讲到底. Route 目录 上一篇 Angular 17+ 高级教程 – Routing 路由 (原理篇) 下一篇 Angular 17 ...
- JavaScript – 冷知识 (新手)
当 charAt 遇上 Emoji 参考: stackoverflow – How to get first character of string? 我们经常会用 charAt(0) 来获取 fir ...
- SQL Server – 冷知识 (新手)
前言 没有系统化学一本语言或技术, 那便会被一些冷知识坑. 这里做些记入. 变量作用域 SQL 是远古语法, 声明变量在最顶部就是一条上古法则. 如果我看见有了用这个法则写 C# 或 JS 我就会杀了 ...