
SMOTE算法解决样本不平衡
首先,看下Smote算法之前,我们先看下当正负样本不均衡的时候,我们通常用的方法:
- 抽样
常规的包含过抽样、欠抽样、组合抽样
过抽样:将样本较少的一类sample补齐
欠抽样:将样本较多的一类sample压缩
组合抽样:约定一个量级N,同时进行过抽样和欠抽样,使得正负样本量和等于约定量级N
这种方法要么丢失数据信息,要么会导致较少样本共线性,存在明显缺陷
- 权重调整
常规的包括算法中的weight,weight matrix
改变入参的权重比,比如boosting中的全量迭代方式、逻辑回归中的前置的权重设置
这种方式的弊端在于无法控制合适的权重比,需要多次尝试
- 核函数修正
通过核函数的改变,来抵消样本不平衡带来的问题
这种使用场景局限,前置的知识学习代价高,核函数调整代价高,黑盒优化
- 模型修正
通过现有的较少的样本类别的数据,用算法去探查数据之间的特征,判读数据是否满足一定的规律
比如,通过线性拟合,发现少类样本成线性关系,可以新增线性拟合模型下的新点
实际规律比较难发现,难度较高
算法基本原理:
(1)对于少数类中每一个样本x,以欧氏距离为标准计算它到少数类样本集中所有样本的距离,得到其k近邻。
(2)根据样本不平衡比例设置一个采样比例以确定采样倍率N,对于每一个少数类样本x,从其k近邻中随机选择若干个样本,假设选择的近邻为xn。
(3)对于每一个随机选出的近邻xn,分别与原样本按照如下的公式构建新的样本。
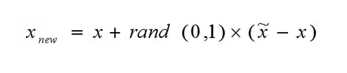
Smote算法的思想其实很简单,先随机选定n个少类的样本,如下图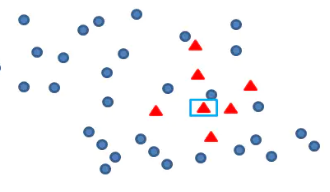
再找出最靠近它的m个少类样本,如下图
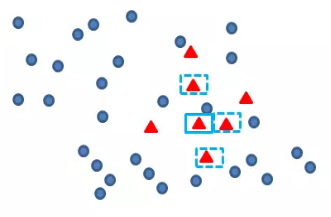
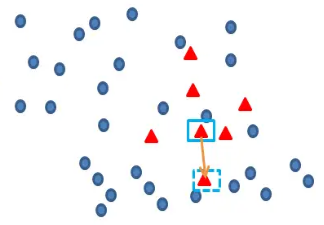
再任选最临近的m个少类样本中的任意一点,
伪代码:
function SMOTE(T, N, k)
Input: T; N; k # T:少数类样本数目
# N:过采样的数目
# K:最近邻的数量
Output: (N/100) * T # 合成的少数类样本
Variables: Sample[][] # 存放原始少数类样本
newindex #控制合成数量
initialized to 0;
Synthetic[][]
if N < 100 then
Randomize the T minority class samples
T = (N/100)*T
N = 100
end if
N = (int)N/100 # 假定SMOTE的数量是100的整数倍
for i = 1 to T do
Compute k nearest neighbors for i, and save the indices in the nnarray
POPULATE(N, i, nnarray)
end for
end function
Algorithm 2 Function to generate synthetic samples
function POPULATE(N, i, nnarray)
Input: N; i; nnarray # N:生成的样本数量
# i:原始样本下标
# nnarray:存放最近邻的数组
Output: N new synthetic samples in Synthetic array
while N != 0 do
nn = random(1,k)
for attr = 1 to numattrs do # numattrs:属性的数量
Compute: dif = Sample[nnarray[nn]][attr] − Sample[i][attr]
Compute: gap = random(0, 1)
Synthetic[newindex][attr] = Sample[i][attr] + gap * dif
end for
newindex + +
N − −
end while
end function
项目经验:
1.采样方法比直接调整阈值的方法要好。
2.使用采样方法可以提高模型的泛化能力,存在过拟合风险,最好联合正则化同时使用。
3.过采样结果比欠采样多数时间稳定,但是还是要具体问题具体分析,主要还是看数据的分布,SMOTE效果还是不错的。
4.和SMOTE算法使用的模型最好是可以防止过拟合的模型,随机森林,L2正则+逻辑回归,XGBoost等模型。
SMOTE算法解决样本不平衡的更多相关文章
- 【深度学习】Focal Loss 与 GHM——解决样本不平衡问题
Focal Loss 与 GHM Focal Loss Focal Loss 的提出主要是为了解决难易样本数量不平衡(注意:这有别于正负样本数量不均衡问题)问题.下面以目标检测应用场景来说明. 一些 ...
- 处理样本不平衡的LOSS—Focal Loss
0 前言 Focal Loss是为了处理样本不平衡问题而提出的,经时间验证,在多种任务上,效果还是不错的.在理解Focal Loss前,需要先深刻理一下交叉熵损失,和带权重的交叉熵损失.然后我们从样本 ...
- 类别不平衡问题之SMOTE算法(Python imblearn极简实现)
类别不平衡问题类别不平衡问题,顾名思义,即数据集中存在某一类样本,其数量远多于或远少于其他类样本,从而导致一些机器学习模型失效的问题.例如逻辑回归即不适合处理类别不平衡问题,例如逻辑回归在欺诈检测问题 ...
- Python:SMOTE算法——样本不均衡时候生成新样本的算法
Python:SMOTE算法 直接用python的库, imbalanced-learn imbalanced-learn is a python package offering a number ...
- 采用boosting思想开发一个解决二分类样本不平衡的多估计器模型
# -*- coding: utf-8 -*- """ Created on Wed Oct 31 20:59:39 2018 脚本描述:采用boosting思想开发一个 ...
- [ML] 解决样本类别分布不均衡的问题
转自:3.4 解决样本类别分布不均衡的问题 | 数据常青藤 (组织排版上稍有修改) 3.4 解决样本类别分布不均衡的问题 说明:本文是<Python数据分析与数据化运营>中的“3.4 解决 ...
- 过采样中用到的SMOTE算法
平时很多分类问题都会面对样本不均衡的问题,很多算法在这种情况下分类效果都不够理想.类不平衡(class-imbalance)是指在训练分类器中所使用的训练集的类别分布不均.比如说一个二分类问题,100 ...
- k 近邻算法解决字体反爬手段|效果非常好
字体反爬,是一种利用 CSS 特性和浏览器渲染规则实现的反爬虫手段.其高明之处在于,就算借助(Selenium 套件.Puppeteer 和 Splash)等渲染工具也无法拿到真实的文字内容. 这种反 ...
- 题目1437:To Fill or Not to Fill:贪心算法解决加油站选择问题(未解决)
//贪心算法解决加油站选择问题 //# include<iostream> # include<stdio.h> using namespace std; # include& ...
- xsank的快餐 » Python simhash算法解决字符串相似问题
xsank的快餐 » Python simhash算法解决字符串相似问题 Python simhash算法解决字符串相似问题
随机推荐
- AspNetCore全局异常处理
在开发ASP.NET Core应用程序时,全局异常处理是一个重要的概念.它允许我们集中处理应用程序中未捕获的异常,确保应用程序的稳定性和用户体验. 1. 为什么需要全局异常处理 全局异常处理的目的是为 ...
- iOS画中画
iOS 14 画中画 打开项目后台模式 创建视频播放源 let url = Bundle.main.url(forResource: "annie", withExtension: ...
- 【Linux】【专项突破】CentOS下软件安装
目录 rpm yum软件仓库 配置文件 缓存处理 清理缓存 重构缓存 查询包的依赖关系 rpm # 普通下载安装 rpm -ivh 包名 # 更新 rpm -Uvh 包全名 # 查询 rpm -q 包 ...
- 部署SkyWalking
SkyWalking部署说明 二进制包部署 1.下载地址 https://dlcdn.apache.org/skywalking/9.4.0/apache-skywalking-apm-9.4.0.t ...
- cs-script:一个非常成熟的C#脚本开源引擎
推荐一个强大C#脚本引擎,方便我们在项目中,动态执行C#脚本. 01 项目简介 CS-Script是非常成熟的C#脚本引擎,自2004年起就发布了,即.NET发布后的两年. 支持托管和独立(CLI)执 ...
- datahub 采集oracle数据 DPI-1047: Cannot locate a 64-bit Oracle Client library: libclntsh.so
datahub 命令行采集oracle 报错如下: datahub ingest -c oracle.yml sqlalchemy.exc.DatabaseError: (cx_Oracle.Data ...
- 在 .NET Core中如何使用 Redis 创建分布式锁
在 .NET Core WebApi 中使用 Redis 创建分布式锁可以通过 StackExchange.Redis 库来实现.分布式锁用于确保在分布式系统中,同一时间只有一个进程可以执行某段代码. ...
- 我的新书《C#上位机开发实战指南》出版了
-Begin- 大家好!我是付工. 2022年的时候,我萌生了编写一本上位机书籍的想法,希望能给更多的上位机学习者提供一些帮助,经历了2年多的时间,今年的8月份,这本书终于出版了. 初衷 十年前,我也 ...
- cpa-会计
会计整体介绍 1.总结 2.会计政策.会计估计及其变更和差错更正 3.存货 4.固定资产 5.无形资产 6.投资性房地产 7.长期股权投资与合营安排 8.资产减值 9.负债 10.职工薪酬 11.借款 ...
- SpringCloud(一) - Dubbo + Zookeeper
Dubbo 和Zookeeper 不是SpringCloud的东西,放在这里只是为了方便复习: 1.下载安装Zookeeper和Dubbo 1.1 下载安装教程 下载安装教程 windows环境下安装 ...