
hadoop 0.20.2伪分布式安装详解
adoop 0.20.2伪分布式安装详解
hadoop有三种运行模式:
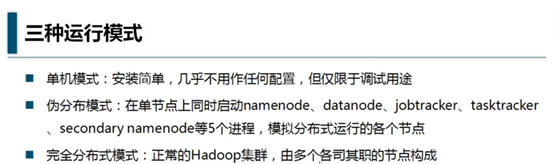
伪分布式不需要安装虚拟机,在同一台机器上同时启动5个进程,模拟分布式。
完全分布式至少有3个节点,其中一个做master,运行名称节点(namenode)、作业跟踪器(jobtracker)等主要进程,另外两个做datanode,运行tasktracker,最好有两个,否则没有冗余,谈不上集群。
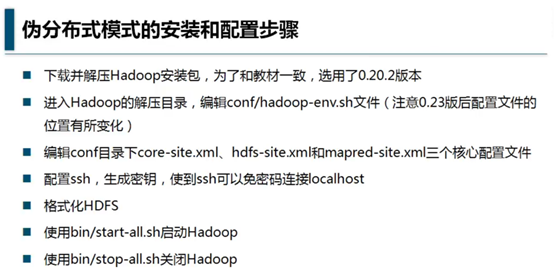
下载hadoop 0.20.2安装包:
http://archive.apache.org/dist/hadoop/core/hadoop-0.20.2/hadoop-0.20.2.tar.gz
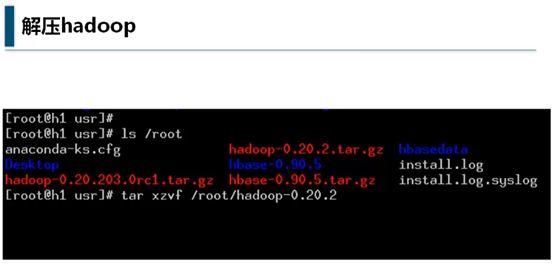
解压后,放置在合适的位置,如/opt/Hadoop-0.20.2,执行以下命令:
tar -zxvf /opt/haddop-0.20.2
x表示展开文件,-x | --extract | --get 从存档展开文件
z表示用gzip对文档进行压缩或解压,-z | --gzip | --ungzip 用gzip对存档压缩或解压
-v | --verbose 详细显示处理的文件
-f | --file [HOSTNAME:]F 指定存档或设备(缺省为 /dev/rmt0)
如果指定解压目录,则最一个字符应当是“/”,否则就是文件了
进入Hadoop-0.20.2目录
vim conf/Hadoop-env.sh
其中的conf目录是config的缩写,通常是用来放置配置文件的目录,很多开源软件习惯于使用这个目录名称。Hadoop版本不同,配置文件可能也不同,要根据实际情况有所调整。
解压后,进入Hadoop-0.20.2目录,进行配置
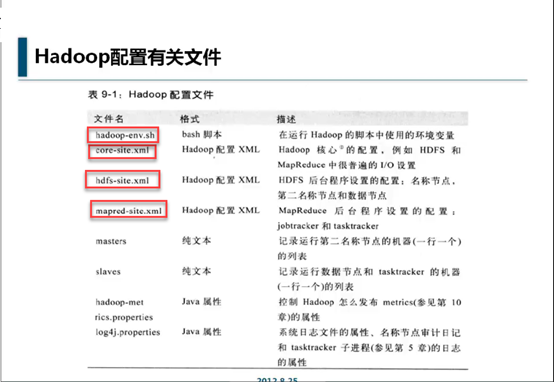
本文配置这四个文件。
修改hadoop-env.sh文件
进入conf目录,找到图中的三个文件
vim hadoop-env.sh
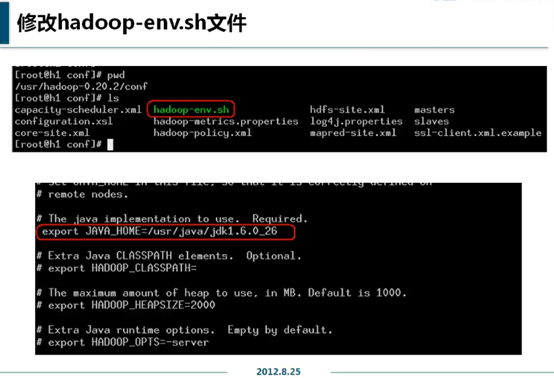
找到JAVA_HOME那一项,或修改,或增加,由你选择,最后使
export JAVA_HOME=你的java目录
这一行生效。
此文件暂时仅配置这一项即可。
修改core-site.xml文件
然后
vim core-site.xml
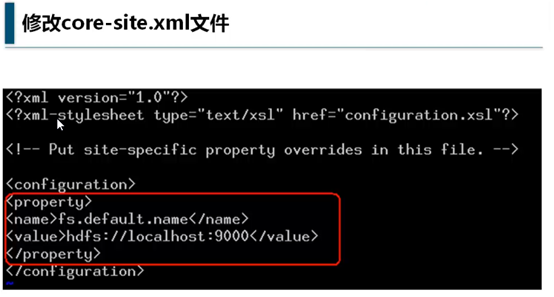
最初的<configuration>项是空的,伪分布式完全按照图中的<property>部分添加即可。
完全分布式要把hdfs:项的主机名部分换成对应的IP或主机名,不管是什么,不会是localhost,此处要注意。
其中的fs.default.name用来指定namenode的IP地址和端口,用于和对应的节点联系。
修改hdfs-site.xml文件
vim hdfs-site.xml
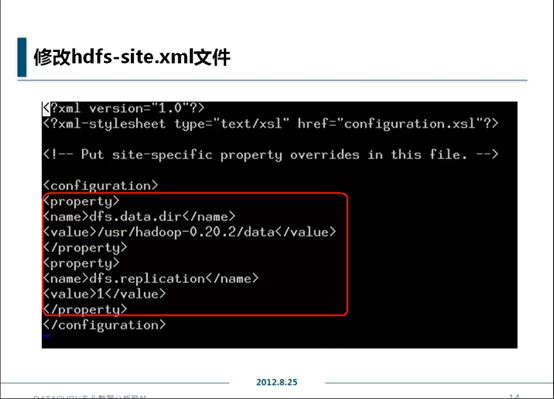
与core-site相同,第一次进入时<configuration>项是空的,伪分布式完全按照红圈部分添加即可。完全分布式要修改dfs.replication部分的value,因为hadoop会往多个节点中复制数据用于备份,此处设置的是最大份数,也就是数据节点的数量,也就是小弟的数量,伪分布式只有一个节点,所以是1,写多了也没用。dfs.data.dir是数据节点的数据的存放位置。

其它参数不多讲。
修改mapred-site.xml
vim mapred-site.xml
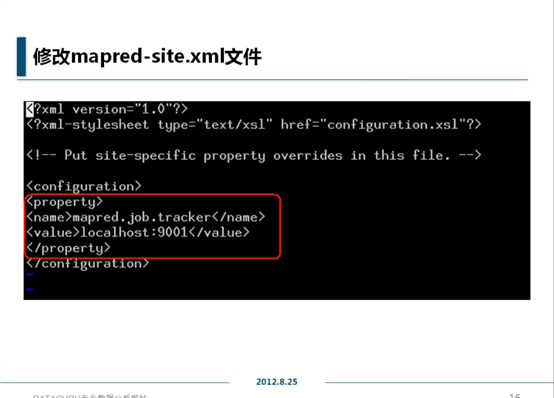
作业跟踪器的位置,端口默认,无须修改。作业跟踪器是整个mapreduce系统调度的核心。
伪分布式照搬上图,完全分布式修改主机名。
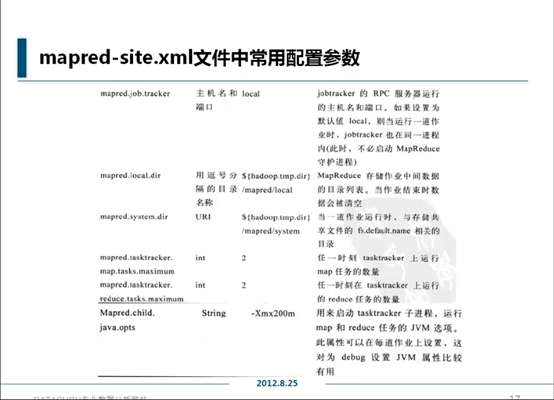
其它参数,暂时不动。
生成SSH密钥对
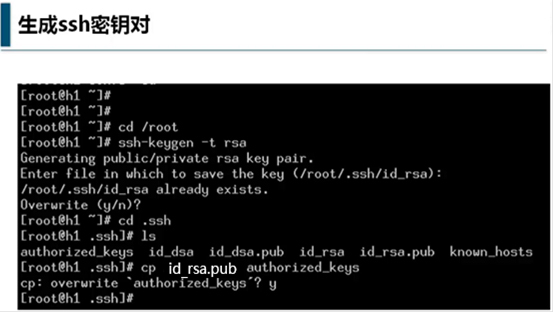
- 输入su,切换到root用户
- cd /root,进入root目录
- 运行ssh-kengen -t rsa
给root用户创建一对密钥,公钥和私钥,不对称(不一样),公钥可公开,别人拿到公钥后,可对文件需要加密的内容进行加密,然后传给服务器,服务器可用私钥解密。公钥加密的,只有私钥才能解密。反之亦然,可以用私钥加密,用公钥可以解密,私钥本身无法解密,但这样做没有意义。
拿到公钥,反推私钥,基本上不可能,以目前的计算能力,需要几百年。
RSA算法,产生密钥过程时间很短,但反推消耗时间非常长。例如,两个上千位的素数相乘,所得到的结果,如果反推,可能性太多,只能逐一尝试,这样就会消耗非常长的时间。
Enter file in which to save the key,这一句是问把生成的公钥和私钥存放在哪个文件,如果输入a,则生成a.pub和a两个文件。如果不输入,直接回车,则生成默认文件名id_rsa.pub和id_rsa。
可以使用任何编辑工具查看它们的内容,比如cat id_rsa.pub,里面是人类无法理解的字符串。
然后执行命令:
cp id_isa.pub authorized_keys
authorized_keys中存在id_rsa.pub公钥,就可以免密码连入
至此,hadoop0.20.2的伪分布式就配完了。
格式化分布式文件系统
hadoop目录下执行bin/hadoop namenode -format
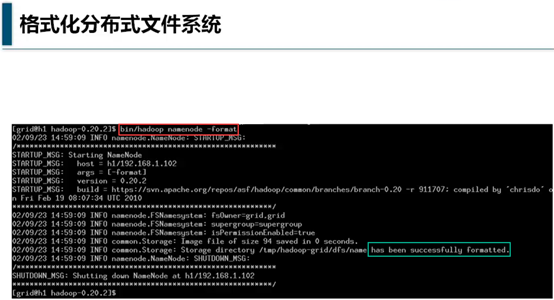
此操作的目的在于,在“名称节点”上建立一系列结构,用来存放整个HDFS的元数据,
出现绿圈的提示has been successfully formatted即是配置成功。
下面在hadoop目录下执行以下命令:
bin/start-all.sh
(如果进入bin目录,然后执行start-all.sh,会报“未找到命令”)
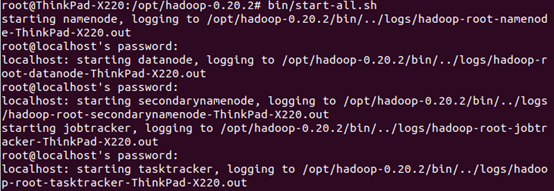
如果没有看到denied之类的提示,就是启动成功了。
检测守护进程启动情况
在root用户下,使用java的jps,会看到类似以下的提示:
一样的规则,不能进入到java的bin目录下执行jps,而是java目录下执行bin/jps
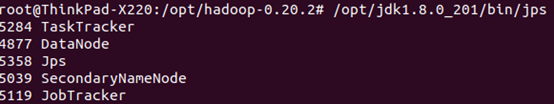
表示伪分布式hadoop0.20.2配置成功。
hadoop 0.20.2伪分布式安装详解的更多相关文章
- Hadoop生态圈-hbase介绍-伪分布式安装
Hadoop生态圈-hbase介绍-伪分布式安装 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HBase简介 HBase是一个分布式的,持久的,强一致性的存储系统,具有近似最 ...
- centos 7下Hadoop 2.7.2 伪分布式安装
centos 7 下Hadoop 2.7.2 伪分布式安装,安装jdk,免密匙登录,配置mapreduce,配置YARN.详细步骤如下: 1.0 安装JDK 1.1 查看是否安装了openjdk [l ...
- hadoop 2.7.3伪分布式安装
hadoop 2.7.3伪分布式安装 hadoop集群的伪分布式部署由于只需要一台服务器,在测试,开发过程中还是很方便实用的,有必要将搭建伪分布式的过程记录下来,好记性不如烂笔头. hadoop 2. ...
- hadoop-0.20.2伪分布式安装简记
1.准备环境 虚拟机(redhat enterprise linux 6.5) jdk-8u92-linux-x64.tar.gz hadoop-0.20.2.tar.gz 2.关闭虚拟机的防火墙,s ...
- Hadoop新生报到(一) hadoop2.6.0伪分布式配置详解
首先先不看理论,搭建起环境之后再看: 搭建伪分布式是为了模拟环境,调试方便. 电脑是win10,用的虚拟机VMware Workstation 12 Pro,跑的Linux系统是centos6.5 , ...
- Hadoop伪分布安装详解(五)
目录: 1.修改主机名和用户名 2.配置静态IP地址 3.配置SSH无密码连接 4.安装JDK1.7 5.配置Hadoop 6.安装Mysql 7.安装Hive 8.安装Hbase 9.安装Sqoop ...
- Hadoop + Hive + HBase + Kylin伪分布式安装
问题导读 1. Centos7如何安装配置? 2. linux网络配置如何进行? 3. linux环境下java 如何安装? 4. linux环境下SSH免密码登录如何配置? 5. linux环境下H ...
- Hadoop伪分布安装详解(三)
目录: 1.修改主机名和用户名 2.配置静态IP地址 3.配置SSH无密码连接 4.安装JDK1.7 5.配置Hadoop 6.安装Mysql 7.安装Hive 8.安装Hbase 9.安装Sqoop ...
- Hadoop伪分布安装详解(二)
目录: 1.修改主机名和用户名 2.配置静态IP地址 3.配置SSH无密码连接 4.安装JDK1.7 5.配置Hadoop 6.安装Mysql 7.安装Hive 8.安装Hbase 9.安装Sqoop ...
随机推荐
- 【SqlServer】SqlServer的常规操作
创建一张新表,不负责任何数据(该表不会有原来表的主键.索引等等) select * into NewTable from OldTable where 1<>1; 创建一张新表,并且复制旧 ...
- 【转载】Springboot整合 一 集成 redis
原文:http://www.ityouknow.com/springboot/2016/03/06/spring-boot-redis.html https://blog.csdn.net/plei_ ...
- DataTable转成List集合
项目开发中,经常会获取到DataTable对象,如何把它转化成一个List对象呢?前几天就碰到这个问题,网上搜索整理了一个万能类,用了泛型和反射的知识.共享如下: public class Model ...
- Atitit 数据库view视图使用推荐规范与最佳实践与方法
Atitit 数据库view视图使用推荐规范与最佳实践与方法 1. 视图的优点:1 1.1. **提升可读性 定制用户数据,聚焦特定的数据1 1.2. 使用视图,可以简化数据操作. 1 ...
- leetcode笔记:3Sum Closest
一.题目描写叙述 二.解题技巧 该题与3Sum的要求类似.不同的是要求选出的组合的和与目标值target最接近而不一定相等.但实际上,与3Sum的算法流程思路类似,先是进行排序.然后顺序选择数组A中的 ...
- 【Spark 深入学习 01】 Spark是什么鬼?
经过一段时间的学习和测试,是时候给spark的学习经历做一个总结了,对于spark的了解相对晚了写.春节期间(预计是无大事),本博准备推出20篇左右spark系列原创文章(先把牛吹出去再说) ,尽量将 ...
- RSA加密和解密工具类
import org.apache.commons.codec.binary.Base64; import javax.crypto.Cipher; import java.security.*; i ...
- 【网络】TCP和UDP的区别以及TCP的三次握手四次释放
一.两者区别 1.TCP面向连接的运输层协议,UDP无连接 2.TCP是可靠交付,UDP是尽最大努力交付 3.TCP面向字节流,UDP面向报文 4.TCP是点对点连接的,UDP一对一,一对多,多对多都 ...
- 大津法---OTSU算法
简介: 大津法(OTSU)是一种确定图像二值化分割阈值的算法,由日本学者大津于1979年提出.从大津法的原理上来讲,该方法又称作最大类间方差法,因为按照大津法求得的阈值进行图像二值化分割后,前景与背景 ...
- Android ShareUserId 使用总结
今天讲一下Android里面经常看到却不太留意的知识点——ShareUserId,在Android里面每个app都有一个唯一的linux user ID,则这样权限就被设置成该应用程序的文件只对该用户 ...