
DFS和BFS
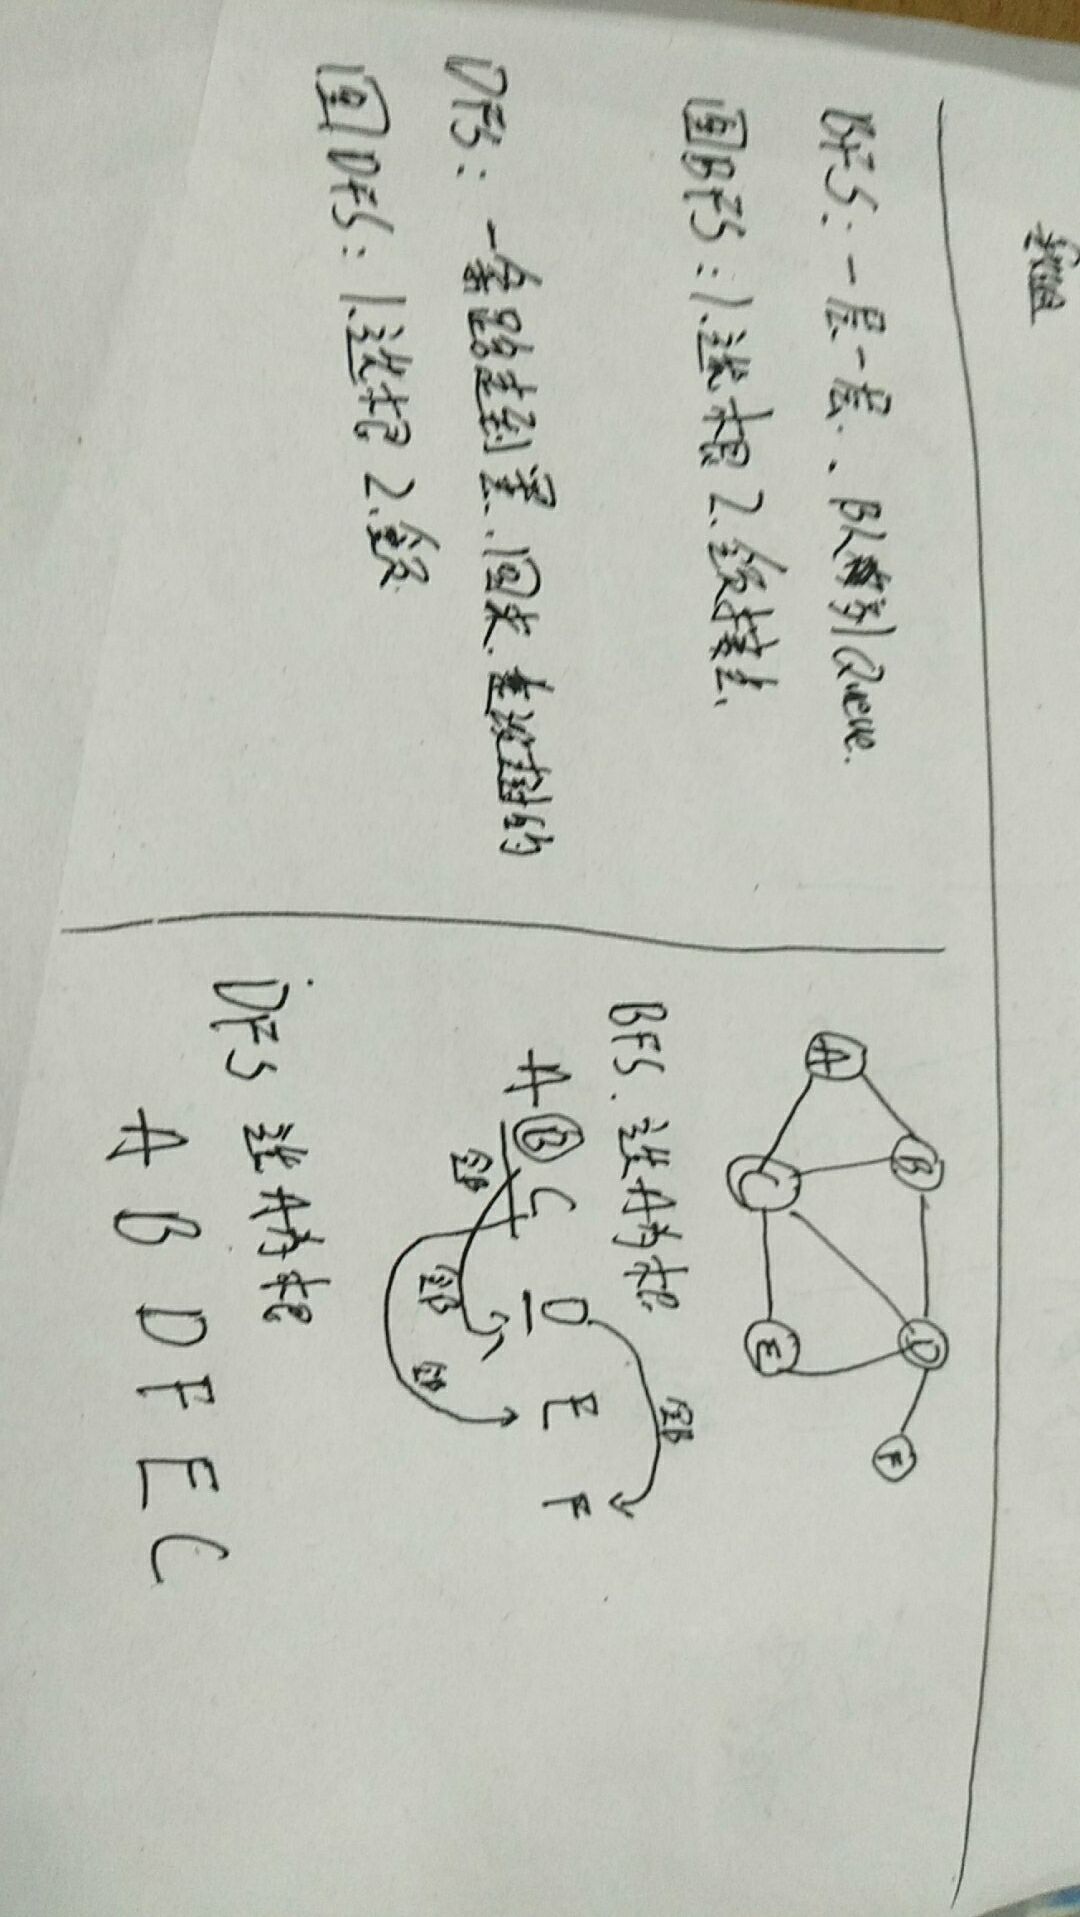
BFS
代码步骤:
1、写出每个点和每个点的邻接点的对应关系
2、方法参数:传一个对应关系和起始点
3、创建一个队列,然后每次都移除第一个,然后把移除的邻接点添加进去,打印取出的第一个,然后循环,一直到队列没有元素
import java.util.ArrayList;

import java.util.HashMap;

import java.util.HashSet;

import java.util.List;

import java.util.Map;

import java.util.Set;

public class BFS {

    public static void main(String[] args) {

        List list = new ArrayList();//A的邻接点

        list.add("B");

        list.add("C");

        List list2 = new ArrayList();//B的邻接点

        list2.add("A");

        list2.add("C");

        list2.add("D");

        List list3 = new ArrayList();//C的邻接点

        list3.add("A");

        list3.add("B");

        list3.add("D");

        list3.add("E");

        List list4 = new ArrayList();//D的邻接点

        list4.add("B");

        list4.add("C");

        list4.add("E");

        list4.add("F");

        List list5 = new ArrayList();//E的邻接点

        list5.add("C");

        list5.add("D");

        List list6 = new ArrayList();//F的邻接点

        list6.add("D");

        Map<String,List> map = new HashMap<>();//使得邻接点和该值对应上

        map.put("A", list);

        map.put("B", list2);

        map.put("C", list3);

        map.put("D", list4);

        map.put("E", list5);

        map.put("F", list6);

        BFS(map,"E");

    }

    /**

     * 利用对列的方式

     * @param map 字典

     * @param s    根节点

     */

    public static void BFS(Map map,String s){

        List<String> queue = new ArrayList();//队列

        queue.add(s);

        ArrayList seen = new ArrayList();//用来放已经访问过的元素

        seen.add(s);

        while(queue.size()>0) {//队列没有元素位置

            String vertex = (String) queue.remove(0);//每次取队列第一个元素

            List<String> nodes = (List) map.get(vertex);//把vertex所有临近点

            for(String w:nodes) {//遍历所有邻接点,没有包含的进入队列

                if(!seen.contains(w)) {

                    queue.add(w);

                    seen.add(w);

                }

            }

            System.out.println(vertex);

        }

    }

}
BFS的最短路径
就是添加一个键值对,键就是该字母,值就是他的前一个字母
import java.util.ArrayList;

import java.util.HashMap;

import java.util.HashSet;

import java.util.List;

import java.util.Map;

import java.util.Set;

public class BFS最短路径 {

    public static void main(String[] args) {

        List list = new ArrayList();

        list.add("B");

        list.add("C");

        List list2 = new ArrayList();

        list2.add("A");

        list2.add("C");

        list2.add("D");

        List list3 = new ArrayList();

        list3.add("A");

        list3.add("B");

        list3.add("D");

        list3.add("E");

        List list4 = new ArrayList();

        list4.add("B");

        list4.add("C");

        list4.add("E");

        list4.add("F");

        List list5 = new ArrayList();

        list5.add("C");

        list5.add("D");

        List list6 = new ArrayList();

        list6.add("D");

        Map<String,List> map = new HashMap<>();

        map.put("A", list);

        map.put("B", list2);

        map.put("C", list3);

        map.put("D", list4);

        map.put("E", list5);

        map.put("F", list6);

        BFS(map,"A");

    }

    /**

     * 利用对列的方式

     * @param map

     * @param s

     */

    public static void BFS(Map map,String s){

        List<String> queue = new ArrayList();//队列

        queue.add(s);

        ArrayList seen = new ArrayList();//用来放已经访问过的元素

        seen.add(s);

        Map parent = new HashMap();

        parent.put(s, null);

        while(queue.size()>0) {

            String vertex = (String) queue.remove(0);//那队列第一个元素

            List<String> nodes = (List) map.get(vertex);//把vertex所有临近点

            for(String w:nodes) {//遍历所有邻接点,没有包含的进入队列

                if(!seen.contains(w)) {

                    queue.add(w);

                    seen.add(w);

                    parent.put(w, vertex);//添加字符前一个字符

                }

            }

            //System.out.println(vertex);

        }

        //输出最短路径

        String end = "E";

        while(end!=null) {

            System.out.println(end);

            end = (String) parent.get(end);

        }

    }

}
DFS
就是把BFS的队列换成栈,根本区别就是变成移除最后一个了
import java.util.ArrayList;

import java.util.HashMap;

import java.util.HashSet;

import java.util.List;

import java.util.Map;

import java.util.Set;

public class DFS {

    public static void main(String[] args) {

        List list = new ArrayList();

        list.add("B");

        list.add("C");

        List list2 = new ArrayList();

        list2.add("A");

        list2.add("C");

        list2.add("D");

        List list3 = new ArrayList();

        list3.add("A");

        list3.add("B");

        list3.add("D");

        list3.add("E");

        List list4 = new ArrayList();

        list4.add("B");

        list4.add("C");

        list4.add("E");

        list4.add("F");

        List list5 = new ArrayList();

        list5.add("C");

        list5.add("D");

        List list6 = new ArrayList();

        list6.add("D");

        Map<String,List> map = new HashMap<>();

        map.put("A", list);

        map.put("B", list2);

        map.put("C", list3);

        map.put("D", list4);

        map.put("E", list5);

        map.put("F", list6);

        DFS(map,"E");

    }

    /**

     * 利用对列的方式

     * @param map

     * @param s

     */

    public static void DFS(Map map,String s){

        List<String> stack = new ArrayList();//栈

        stack.add(s);

        ArrayList seen = new ArrayList();//用来放已经访问过的元素

        seen.add(s);

        while(stack.size()>0) {

            String vertex = (String) stack.remove(stack.size()-1);//拿队列最后一个元素

            List<String> nodes = (List) map.get(vertex);//把vertex所有临近点

            for(String w:nodes) {//遍历所有邻接点,没有包含的进入队列

                if(!seen.contains(w)) {

                    stack.add(w);

                    seen.add(w);

                }

            }

            System.out.println(vertex);

        }

    }

}
DFS和BFS的更多相关文章
- Clone Graph leetcode java(DFS and BFS 基础)
题目: Clone an undirected graph. Each node in the graph contains a label and a list of its neighbors. ...
- 数据结构(12) -- 图的邻接矩阵的DFS和BFS
//////////////////////////////////////////////////////// //图的邻接矩阵的DFS和BFS ////////////////////////// ...
- 数据结构(11) -- 邻接表存储图的DFS和BFS
/////////////////////////////////////////////////////////////// //图的邻接表表示法以及DFS和BFS //////////////// ...
- 在DFS和BFS中一般情况可以不用vis[][]数组标记
开始学dfs 与bfs 时一直喜欢用vis[][]来标记有没有访问过, 现在我觉得没有必要用vis[][]标记了 看代码 用'#'表示墙,'.'表示道路 if(所有情况都满足){ map[i][j]= ...
- 图论中DFS与BFS的区别、用法、详解…
DFS与BFS的区别.用法.详解? 写在最前的三点: 1.所谓图的遍历就是按照某种次序访问图的每一顶点一次仅且一次. 2.实现bfs和dfs都需要解决的一个问题就是如何存储图.一般有两种方法:邻接矩阵 ...
- 图论中DFS与BFS的区别、用法、详解?
DFS与BFS的区别.用法.详解? 写在最前的三点: 1.所谓图的遍历就是按照某种次序访问图的每一顶点一次仅且一次. 2.实现bfs和dfs都需要解决的一个问题就是如何存储图.一般有两种方法:邻接矩阵 ...
- 数据结构基础(21) --DFS与BFS
DFS 从图中某个顶点V0 出发,访问此顶点,然后依次从V0的各个未被访问的邻接点出发深度优先搜索遍历图,直至图中所有和V0有路径相通的顶点都被访问到(使用堆栈). //使用邻接矩阵存储的无向图的深度 ...
- dfs和bfs的区别
详见转载博客:https://www.cnblogs.com/wzl19981116/p/9397203.html 1.dfs(深度优先搜索)是两个搜索中先理解并使用的,其实就是暴力把所有的路径都搜索 ...
- 邻接矩阵实现图的存储,DFS,BFS遍历
图的遍历一般由两者方式:深度优先搜索(DFS),广度优先搜索(BFS),深度优先就是先访问完最深层次的数据元素,而BFS其实就是层次遍历,每一层每一层的遍历. 1.深度优先搜索(DFS) 我一贯习惯有 ...
- 判断图连通的三种方法——dfs,bfs,并查集
Description 如果无向图G每对顶点v和w都有从v到w的路径,那么称无向图G是连通的.现在给定一张无向图,判断它是否是连通的. Input 第一行有2个整数n和m(0 < n,m < ...
随机推荐
- toFixed()精度丢失;复选框全选、取消
一.精度丢失和重写toFixed()函数 1.重写toFixed() Number.prototype.toFixed = function(length){ var carry = 0; //存放进 ...
- Python 用下划线作为变量前缀和后缀指定特殊变量
_xxx 不能用’from module import *’导入 __xxx__ 系统定义名字 __xxx 类中的私有变量名 核心风格:避免用下划线作为变量名的开始. 因为下划线对解释器有特殊的意义, ...
- iframe父页面和子页面获取元素和js变量
父页面获取iframe页面元素和变量 获取方法:$("#id")[0].contentWindow.showInfo(): 获取元素: $("#id").co ...
- cowboy源码分析(二)
接 cowboy源码分析(一) 下面我们重点看看cowboy_protocol.erl代码 -module(cowboy_protocol). %% API. -export([start_link/ ...
- 【图论】最短路问题之spfa
写在算法前面: 前向星存图(一个神奇的超越邻接矩阵的存在) 首先讲一下需要定义的一些东西?? 1.head数组:head[点数]:head[i]表示以当前点i为起点的最后一条边(这里的最后指的是编号[ ...
- label标签内含有input元素,点击事件会触发两次
**label标签内含有input元素,点击事件会触发两次** 如果你的结构是label内写input实现点击文字时候input也有相应.并且,把事件设置在了label上,那么就会执行两次了. //h ...
- OLLVM特性、使用原理
一.OLLVM特性 目前ollvm支持的特性有以下几种: 指令替换 -mllvm -sub 虚假控制流 -mllvm -bcf 打平控制流 -mllvm -fla 函数(Funtions)注解 二.指 ...
- 答题卡作文模块的一种方法-VSTO
在开始做之前,首先百度了Word有没有简单的生成方法,果然有--页面布局->稿纸设置->方格式稿纸 效果如下图所示.很规范,但是不是答题卡所需要的,因为这样会把所有页面都设置为这样的稿纸. ...
- 压测过程中出现ops断崖式下跌原因及排解
压测机器: 100台docker redis集群:16个分片 在开始压测的半个小时中,一直很稳定,ops稳定在20w左右.但是接下来突然ops断崖式下跌,ops降到了3w以下.然后持续一段时间,直至变 ...
- JS(JAVASCRIPT)
2018-08-17 * JAVASCRIPT(JavaScript简写js,文件的后缀名也是 demo.js)(*****) * javascript的简介 * js是基于对象和事件驱动的脚本语言, ...