
HashMap源码(一)
本文主要是从学习的角度看HashMap源码
HashMap的数据结构
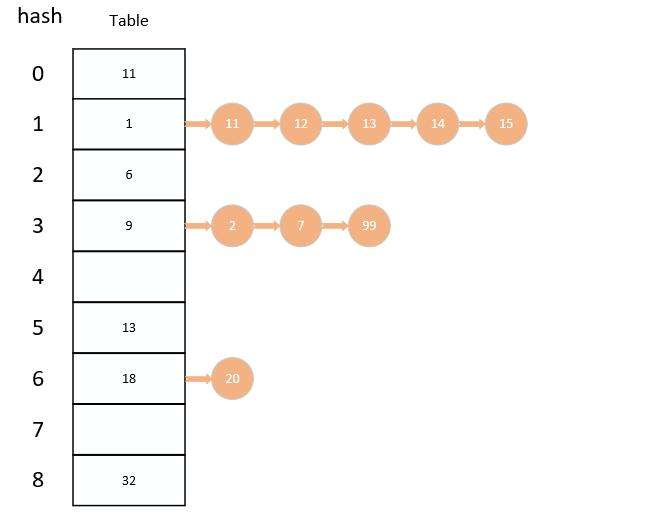
- HashMap是一个数组+链表的结构(链表散列),每个节点在HashMap中以一个Node存在;
HashMap的初始化
    public HashMap(int initialCapacity, float loadFactor) {

        if (initialCapacity < 0)

            throw new IllegalArgumentException("Illegal initial capacity: " +

                                               initialCapacity);

	// 这里的MAXIMUM_CAPACITY=1 << 30(问题一: 为什么是30?)

        if (initialCapacity > MAXIMUM_CAPACITY)

	    // 如果传入初始值大于1<<30 则默认值为最大;

            initialCapacity = MAXIMUM_CAPACITY;

        if (loadFactor <= 0 || Float.isNaN(loadFactor))

            throw new IllegalArgumentException("Illegal load factor: " +

                                               loadFactor);

        this.loadFactor = loadFactor;

        // 这里是根据传入的初始值算得 大于输入参数且最近的2的整数次幂的数

        this.threshold = tableSizeFor(initialCapacity);

    }
HashMap中初始化方法如上。
- initialCapacity参数为初始化大小的值,默认为16,问题二:这里为什么为16?;
- loadFactor参数我理解为扩容权重比,默认值为0.75,问题三:这里为什么是0.75?,就是当HashMap的容量达到HashMap的数组长度*loadFactor时就会进行扩容。也就是HashMap中的 resize 方法
初始化方法代码不多,此处为了效率运用了很多的位运算;
首先: 为什么HashMap的容量永远是2的整数倍?
- 首先我们可以看源码知道HashMap中元素的位置计算是 hash & (n- 1),为啥要这么算我也不知道,反正这样的算法下 如果hashmap的长度刚好是2的倍数那么元素的分布相对来说是比较均匀的。减少元素碰撞的几率; 具体详细的可以看下这篇博文
- 所以这也解释了问题二的初始值为16即2的四次方;至于为啥一定是16,我也不知道,可能我比较杠精;
- 更新(12-11 ): 此处为什么是16在关于这个默认容量的选择,JDK并没有给出官方解释,我也没有在网上找到关于这个任何有价值的资料。(如果哪位有相关的权威资料或者想法,可以留言交流)
- 更新(12-23):详见问题二
问题一:MAXIMUM_CAPACITY = 1 << 30
- 首先这个值符合上面的原则,即大小为2的整数倍;而1<<30这个值我们可以尝试发现:
   System.out.println(1<<30); // 1073741824

   System.out.println(1<<31); // -2147483648

   System.out.println(1<<32); // 1
- 因为int类型是32位整型,1左移31位的为 16进制的0x80000000代表的是-2147483648, 所以最大值只能为1>>30;至于为什么初始值不用Integer.MAX_VALUE,其实在resize方法中有下面这段代码:
        if (oldCap >= MAXIMUM_CAPACITY) {

	//若数组长度大于1>>30,这里则扩容Integer.MAX_VALUE;

            threshold = Integer.MAX_VALUE;

            return oldTab;

        }
问题二:initialCapacity初始值为16
因为在使用是2的幂的数字的时候,Length-1的值是所有二进制位全为1,这种情况下,index的结果等同于HashCode后几位的值。
只要输入的HashCode本身分布均匀,Hash算法的结果就是均匀的。
这是为了实现均匀分布。
问题三: loadFactor默认值0.75
JDK 1.7中:
As a general rule, the default load factor (.75) offers a good tradeoff between time and space costs. Higher values decrease the space overhead but increase the lookup cost (reflected in most of the operations of the HashMap class, including get and put). The expected number of entries in the map and its load factor should be taken into account when setting its initial capacity, so as to minimize the number of rehash operations. If the initial capacity is greater than the maximum number of entries divided by the load factor, no rehash operations will ever occur.
翻译过来就是:
作为一般规则,默认负载因子(0.75)在时间和空间成本上提供了很好的折衷。较高的值会降低空间开销,但提高查找成本(体现在大多数的HashMap类的操作,包括get和put)。设置初始大小时,应该考虑预计的entry数在map及其负载系数,并且尽量减少rehash操作的次数。如果初始容量大于最大条目数除以负载因子,rehash操作将不会发生。理想状态下,在随机哈希值的情况,对于loadfactor = 0.75 ,虽然由于粒度调整会产生较大的方差,桶中的Node的分布频率服从参数为0.5的泊松分布。
接下来我们会具体看下HashMap的resize方法
博文推荐:https://www.hollischuang.com/archives/4320 (掘金看见的,写的很好)
HashMap源码(一)的更多相关文章
- HashMap 源码解析
HashMap简介: HashMap在日常的开发中应用的非常之广泛,它是基于Hash表,实现了Map接口,以键值对(key-value)形式进行数据存储,HashMap在数据结构上使用的是数组+链表. ...
- HashMap源码分析
最近一直特别忙,好不容易闲下来了.准备把HashMap的知识总结一下,很久以前看过HashMap源码.一直想把集合类的知识都总结一下,加深自己的基础.我觉的java的集合类特别重要,能够深刻理解和应用 ...
- JAVA源码分析-HashMap源码分析(一)
一直以来,HashMap就是Java面试过程中的常客,不管是刚毕业的,还是工作了好多年的同学,在Java面试过程中,经常会被问到HashMap相关的一些问题,而且每次面试都被问到一些自己平时没有注意的 ...
- Java集合---HashMap源码剖析
一.HashMap概述二.HashMap的数据结构三.HashMap源码分析 1.关键属性 2.构造方法 3.存储数据 4.调整大小 5.数据读取 ...
- 【转】Java HashMap 源码解析(好文章)
.fluid-width-video-wrapper { width: 100%; position: relative; padding: 0; } .fluid-width-video-wra ...
- 【JAVA集合】HashMap源码分析(转载)
原文出处:http://www.cnblogs.com/chenpi/p/5280304.html 以下内容基于jdk1.7.0_79源码: 什么是HashMap 基于哈希表的一个Map接口实现,存储 ...
- HashMap源码解读(转)
http://www.360doc.com/content/10/1214/22/573136_78188909.shtml 最近朋友推荐的一个很好的工作,又是面了2轮没通过,已经是好几次朋友内推没过 ...
- HashMap源码剖析
HashMap源码剖析 无论是在平时的练习还是项目当中,HashMap用的是非常的广,真可谓无处不在.平时用的时候只知道HashMap是用来存储键值对的,却不知道它的底层是如何实现的. 一.HashM ...
- Java中HashMap源码分析
一.HashMap概述 HashMap基于哈希表的Map接口的实现.此实现提供所有可选的映射操作,并允许使用null值和null键.(除了不同步和允许使用null之外,HashMap类与Hashtab ...
- 转:【Java集合源码剖析】HashMap源码剖析
转载请注明出处:http://blog.csdn.net/ns_code/article/details/36034955 您好,我正在参加CSDN博文大赛,如果您喜欢我的文章,希望您能帮我投一票 ...
随机推荐
- 最新咕咆+鲁班+图灵+享学+蚂蚁+硅谷+源码 Java架构师资料《Java架构师VIP课程》
最新的Java架构师完整资料,完整视频+源码+文档. 每一套都是一百多个G的资料,无密. JAVA架构师全套课程 咕泡学院互联网架构师第一期 咕泡学院互联网架构师第二期 咕泡学院互联网架构师第三期 博 ...
- C#里面低消耗获取当前时间的思路
Linux下有vsyscall来优化一些例如time(NULL), gettimeofday这种调用的消耗; 但是Windows下, 没有类似的东西, 但是思路还是有的 1. 程序启动的时候, 获取一 ...
- Nginx架构分析(20200202)
Nginx模块化 Nginx基于模块化设计,每个模块是一个功能实现,分布式开发,团队协作 核心模块.标准HTTP模块.可选HTTP模块.邮件模块.第三方模块 编译后的源码目录objs/ngx_modu ...
- python基础扩展
一.垃圾回收机制 垃圾回收机制是自动帮助我们管理内存,清理垃圾的一种工具 1.引用计数 当一个对象的引用被创建或者复制时,对象的引用计数加1: 当一个对象的引用被销毁时,对象的引用计数减1: 当对象的 ...
- libmodbus库linux 嵌入式设备中的使用
libmodbus库的交叉编译:1]到libmodbus官网https://libmodbus.org/download/下载安装包,内部自带configure文件,官网推荐v3.1.6稳定版.另外注 ...
- BloodHound可视化之域分析
一.简介 BloodHound是一款将域内信息可视化的单页的web应用程序,是一款在域内进行信息收集的免费工具: bloodhound通过图与线的形式,将域内用户.计算机.组.会话.ACL以及域内所有 ...
- ajax请求携带cookie和自定义请求头header
参考链接:https://blog.csdn.net/menghuanzhiming/article/details/102736312
- docker - apt-get更换国内源解决Dockerfile构建速度过慢
背景 使用ubuntu镜像一般apt-get源地址都是在国外导致在构建时因为源地址问题导致下载速度极其得慢 在构建中应事先修改apt-get源地址来避免因下载速度过慢导致的构建缓慢问题 方案 在Doc ...
- 完成:vue-styled-components
基础 https://es6.ruanyifeng.com/#docs/string#模板字符串 注释:模板字符串返回字符串类型 如果${...}中的值不是字符串,将按照一般的规则转为字符串.比如,大 ...
- Linux教程-修炼
在2020这个特殊的时期,在家就是为国家做贡献!一切都会好起来的,加油中国!! Linux 第1章 Linux 简介 1.1 为什么要学习Linux 1.2 Linux是什么 1.3 Linux 与 ...