
go单任务版爬虫
go单任务版爬虫(爬取珍爱网)
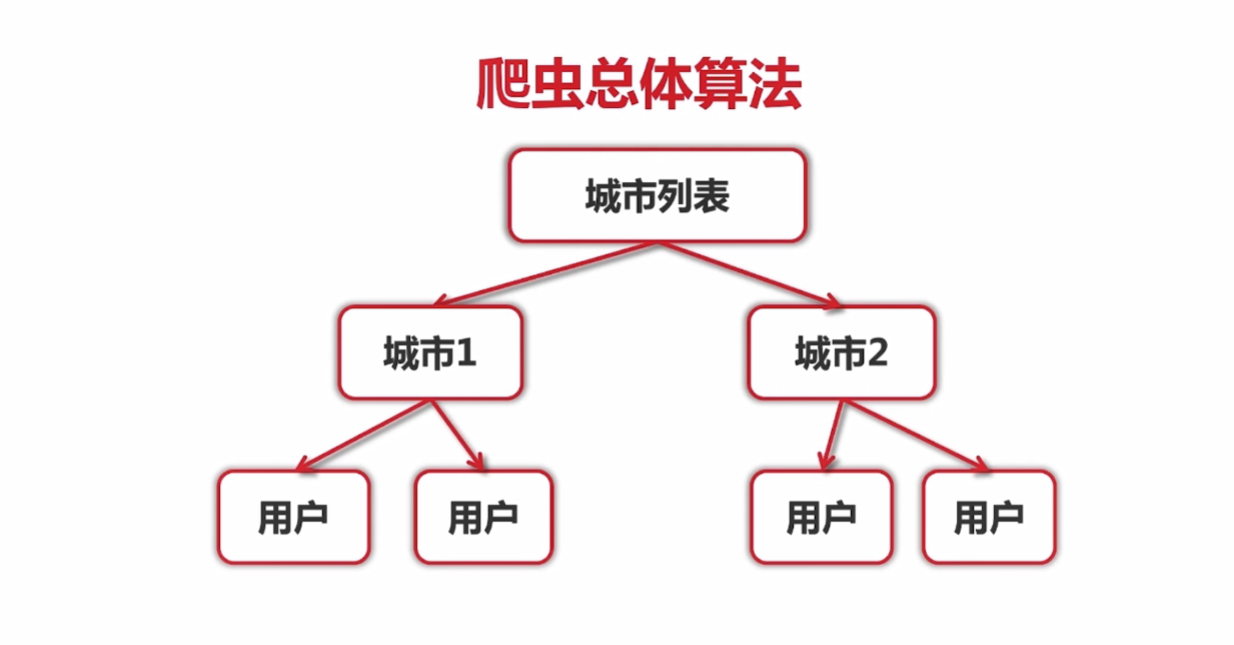
爬虫总体算法
单任务版爬虫架构
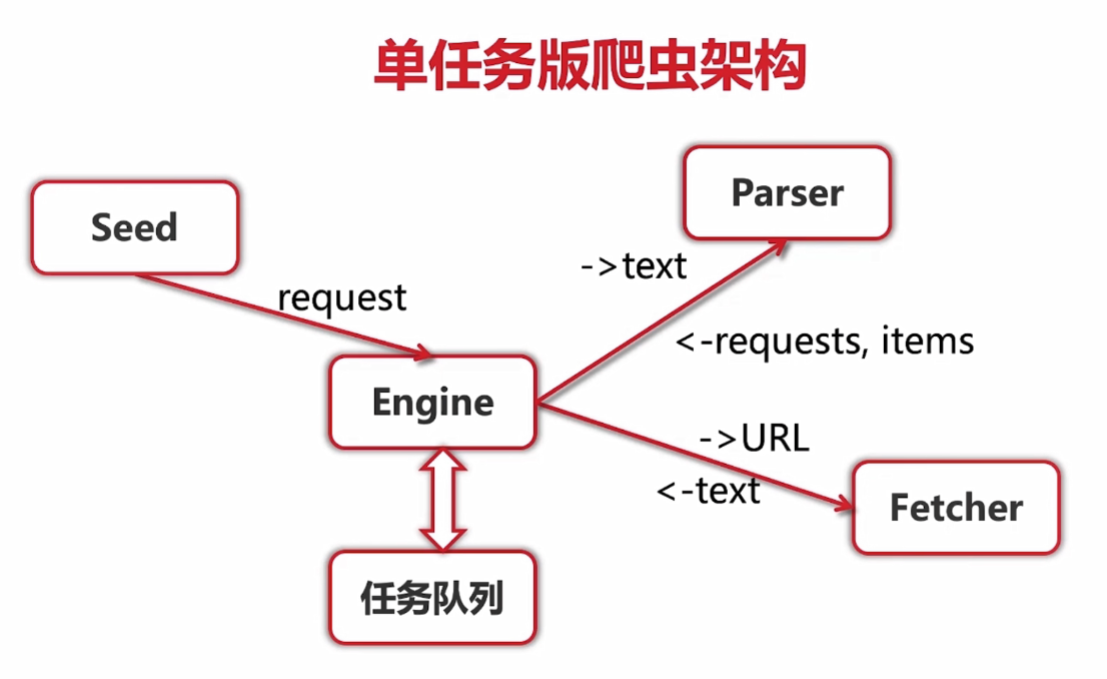
任务
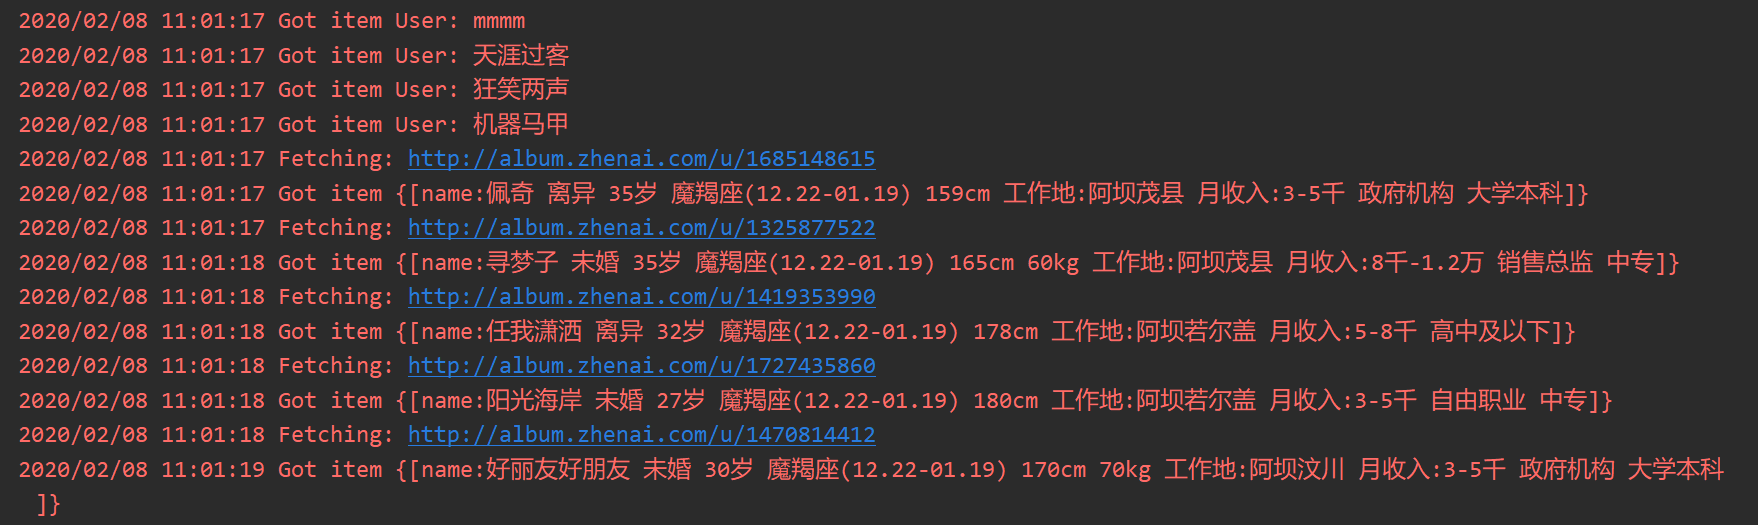
获取并打印所在城市第一页用户的详细信息
代码实现
/crawler/main.go
package main

import (

	"crawler/engine"

	"crawler/zhenai/parser"

)

func main() {

	engine.Run(engine.Request{

		Url:"http://www.zhenai.com/zhenghun",

		ParseFunc: parser.ParseCityList,

	})

}
/crawler/engine/engine.go
package engine

import (

	"crawler/fetcher"

	"log"

)

// seeds:url种子

func Run(seeds ...Request)  {

	var requests []Request

	for _, r := range seeds {

		requests = append(requests, r)

	}

	for len(requests) > 0 {

		r := requests[0]

		requests = requests[1:]

		log.Printf("Fetching: %s", r.Url)

		body, err := fetcher.Fetch(r.Url)

		if err != nil {

			log.Printf("Fetcher: error" + "fetching url %s: %v", r.Url, err)

			continue

		}

		parseResult := r.ParseFunc(body)

		requests = append(requests, parseResult.Requests...)

		for _, item := range parseResult.Items{

			log.Printf("Got item %v", item)

		}

	}

}
/crawler/engine/types.go
package engine

type Request struct {

	Url string

	ParseFunc func([]byte) ParseResult

}

type ParseResult struct {

	Requests []Request

	Items []interface{}

}

func NilParser([]byte) ParseResult{

	return ParseResult{}

}
/crawler/fetcher/fetcher.go
package fetcher

import (

	"bufio"

	"fmt"

	"golang.org/x/net/html/charset"

	"golang.org/x/text/encoding"

	"golang.org/x/text/encoding/unicode"

	"golang.org/x/text/transform"

	"io/ioutil"

	"log"

	"net/http"

)

//获取内容

func Fetch(url string) ([]byte, error)  {

	client := &http.Client{}

	req, err := http.NewRequest("GET", url, nil)

	if err != nil {

		return nil, err

	}

	req.Header.Set("User-Agent", "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36")

	resp, err := client.Do(req)

	if err != nil {

		return nil, err

	}

	defer resp.Body.Close()

	if resp.StatusCode != http.StatusOK {

		return nil, fmt.Errorf("Wrong status code: %d", resp.StatusCode)

	}

	bodyReader := bufio.NewReader(resp.Body)

	e := determineEncoding(bodyReader)

	utf8Reader := transform.NewReader(bodyReader, e.NewDecoder())

	return ioutil.ReadAll(utf8Reader)

}

//转换编码

func determineEncoding(r *bufio.Reader) encoding.Encoding  {

	bytes, err := r.Peek(1024)

	if err != nil {

		log.Printf("Fetcher error: %v", err)

		return unicode.UTF8

	}

	e, _, _ := charset.DetermineEncoding(bytes, "")

	return e

}
/crawler/zhenai/parser/citylist.go
package parser

import (

	"crawler/engine"

	"regexp"

)

//解析UTF8文本,获取城市url列表

const cityListRe  = `<a href="(http://www.zhenai.com/zhenghun/[0-9a-z]+)" [^>]*>([^<]+)</a>`

func ParseCityList(contents []byte) engine.ParseResult {

	re := regexp.MustCompile(cityListRe)

	matches := re.FindAllSubmatch(contents, -1)

	result := engine.ParseResult{}

	limit := 5 //设置限制,便于测试

	for _, m := range matches {

		result.Items = append(result.Items, "City: "+string(m[2]))

		result.Requests = append(result.Requests, engine.Request{

			Url:       string(m[1]),

			ParseFunc: ParseCity,

		})

		limit--

		if limit == 0 {

			break

		}

	}

	return result

}
/crawler/zhenai/parser/city.go
package parser

import (

	"crawler/engine"

	"regexp"

)

//解析单个城市,获取用户

const cityRe = `<a href="(http://album.zhenai.com/u/[0-9]+)" [^>]*>([^<]+)</a>`

func ParseCity(contents []byte) engine.ParseResult {

	re := regexp.MustCompile(cityRe)

	matches := re.FindAllSubmatch(contents, -1)

	result := engine.ParseResult{}

	for _, m := range matches {

		name := string(m[2])

		result.Items = append(result.Items, "User: "+name)

		result.Requests = append(result.Requests, engine.Request{

			Url:       string(m[1]),

			ParseFunc: func(c []byte) engine.ParseResult {

				return ParseProfile(c, "name:"+name)

			},

		})

	}

	return result

}
/crawler/zhenai/parser/profile.go
package parser

import (

	"crawler/engine"

	"crawler/model"

	"regexp"

)

//获取用户信息

const all = `<div class="m-btn purple" data-v-8b1eac0c>([^<]+)</div>`

func ParseProfile(contents []byte, name string) engine.ParseResult {

	profile := model.Profile{}

	profile.User = append(profile.User, name)

	re := regexp.MustCompile(all)

	match := re.FindAllSubmatch(contents,-1)

	if match != nil {

		for _, m := range match {

			profile.User = append(profile.User, string(m[1]))

		}

	}

	result := engine.ParseResult{

		Items: []interface{}{profile},

	}

	return result

}
/crawler/model/profile.go
package model

type Profile struct {

	User []string

}
任务结果
完整代码
https://gitee.com/FenYiYuan/golang-oncrawler.git
go单任务版爬虫的更多相关文章
- go并发版爬虫
并发版爬虫 代码实现 /crawler/main.go package main import ( "learn/crawler/engine" "learn/crawl ...
- golang实现并发爬虫一(单任务版本爬虫功能)
目的是写一个golang并发爬虫版本的演化过程. 那么在演化之前,当然是先跑通一下单任务版本的架构. 正如人走路之前是一定要学会爬走一般. 首先看一下单任务版本的爬虫架构,如下: 这是单任务版本爬虫的 ...
- 区划代码 node 版爬虫尝试
前言 对于区划代码数据,很多人都不会陌生,大多公司数据库都会维护一份区划代码,包含省市区等数据.区划信息跟用户信息息息相关,往往由于历史原因很多数据都是比较老的数据,且不会轻易更改.网上也有很多人提供 ...
- python学习_新闻联播文字版爬虫(V 1.0版)
python3的爬虫练习,爬取的是新闻联播文字版网站 #!/usr/bin/env python # -*- coding: utf-8 -*- ''' __author__ = 'wyf349' _ ...
- {每日一题}:tcp协议实现简单的文件下载器(单任务版)
文件下载器客户端 这个版本的只是为了方便回顾一下TCP客服端,服务端的创建流程,缺点就是 服务器一次只能让一个人访问下载,过两个写个使用面向对象写一个多线程版的强化一下. from socket i ...
- python3版 爬虫了解
摘要:本文将使用Python3.4爬网页.爬图片.自动登录.并对HTTP协议做了一个简单的介绍.在进行爬虫之前,先简单来进行一个HTTP协议的讲解,这样下面再来进行爬虫就是理解更加清楚. 一.HTTP ...
- 从0开始学golang--2.2--如何去爬园子的数据👉进阶篇,面向对象的单任务版
执行页main.go-----------------------------------代码
- python学习_新闻联播文字版爬虫(V 1.0.1版)
更新记录: 1.新增了headers头的随机获取: 2.新增了logging模块添加日志信息(学习用): #!/usr/bin/env python # -*- coding: utf-8 -*- ' ...
- golang实现并发爬虫二(简单调度器)
上篇文章当中实现了单任务版爬虫. 那么这篇文章就大概说下,如何在上一个版本中进行升级改造,使之成为一个多任务版本的爬虫.加快我们爬取的速度. 话不多说,先看图: 其实呢,实现方法就是加了一个sched ...
随机推荐
- IO博客专栏
1. IO概览 2. 字符流与字节流的区别
- Zabbix3.4搭建过程
一.安装之前把firewall 和 selinux关闭. 二.具体的搭建过程可以看zabbix官网的文档,www.zabbix.com(有中文的文档)注意如果复制官网的命令直接使用的话,不会安装mys ...
- innobackupex 恢复脚本
此脚本需要与我前几天写的备份脚本配套才能使用 这里也对innobackupex吐槽下,当使用innobackupex进行恢复的时候,必须要清除所有原数据文件,但是一旦恢复失败,则连实例都将丢失,不成功 ...
- gulp实现自动化打包(二)
引言 在这篇文章中我基于上一篇文章gulp的简单打包示例(一)的代码(重点,不然看的懵逼状态)来介绍gulp的自动化打包,主要是修改gulpfile.js配置文件.当我们执行gulp任务,gulp自动 ...
- tomcat 持久区溢出
知识点:堆内存设置(JVM堆内存)java的堆内存分为两块:permantspace(持久带) 和 heap spaceOOM1.年老代溢出,表现为:java.lang.OutOfMemoryErro ...
- mysql笔记(暂时)
2018-05-28 create table cms_user(id int key auto_increment,username varchar(20),password varchar(20) ...
- css:html-font-size
font-family:"Helvetica Neue",Helvetica,Arial,sans-serif
- 微信小程序—Flex布局
参考教程:http://www.ruanyifeng.com/blog/2015/07/flex-grammar.html https://xluos.github.io/demo/flexb ...
- ARTS Week 3
Nov 11,2019 ~ Nov 17,2019 Algorithm 本周来介绍快速求一个数字n次方的余数. 理论基础 我们先定义运算$ x \bmod p = r \(与\) x \equiv r ...
- 《C语言》—— 数组详解
书籍使我变成了一个幸福的人,使我的生活变成轻松而舒适的诗.--高尔基 本文已经收录至我的GitHub,欢迎大家踊跃star 和 issues. https://github.com/midou-tec ...