volatile的介绍:
  Java代码在编译后会变成Java字节码,字节码被类加载器加载到JVM里,JVM执行字节码,最终需要转化为汇编指令在CPU上执行,Java中所使用的并发机制依赖于JVM的实现和CPU的指令。本章我们将深入底层一起探索下Java并发机制的底层实现原理。 
在多线程并发编程中synchronized和volatile都扮演着重要的角色,volatile是轻量级的synchronized,它在多处理器开发中保证了共享变量的“可见性”。可见性的意思是当一个线程修改一个共享变量时,另外一个线程能读到这个修改的值。如果volatile变量修饰符使用恰当的话,它比synchronized的使用和执行成本更低,因为它不会引起线程上下文的切换和调度。本文将深入分析在硬件层面上Intel处理器是如何实现volatile的,通过深入分析帮助我们正确地使用volatile变量。我们先从了解volatile的定义开始。
1.volatile的定义与实现原理
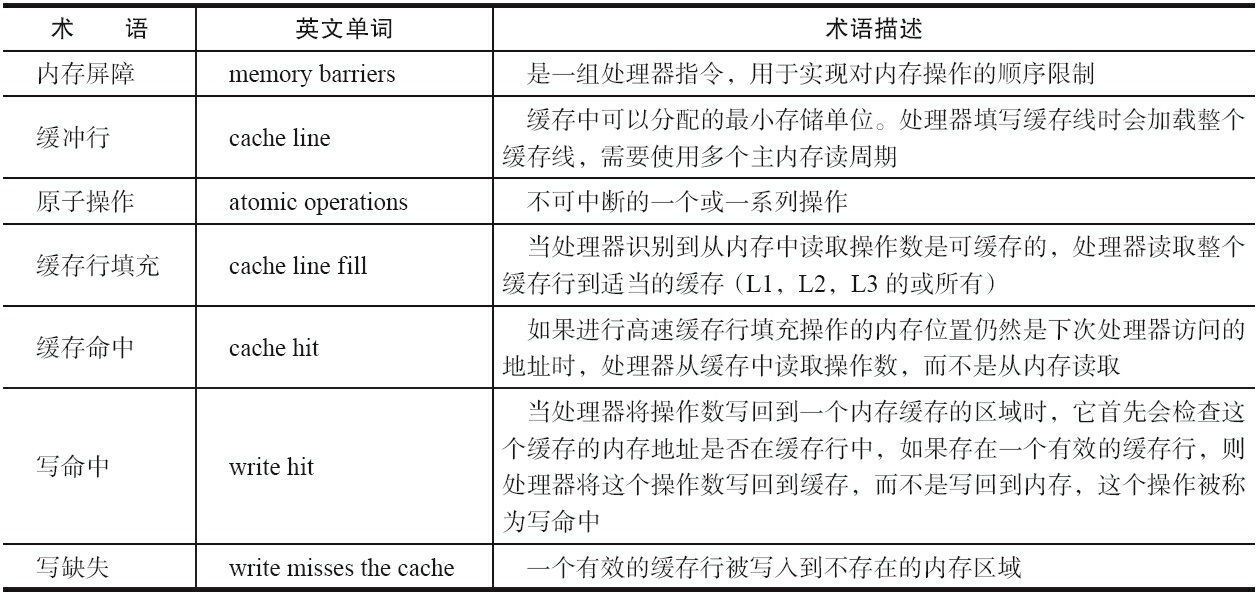
  Java语言规范第3版中对volatile的定义如下:Java编程语言允许线程访问共享变量,为了确保共享变量能被准确和一致地更新,线程应该确保通过排他锁单独获得这个变量。Java语言提供了volatile,在某些情况下比锁要更加方便。如果一个字段被声明成volatile,Java线程内存模型确保所有线程看到这个变量的值是一致的。在了解volatile实现原理之前,我们先来看下与其实现原理相关的CPU术语与说明。表2-1是CPU术语的定义。
表2-1 CPU的术语定义
 
汇编指令来查看对volatile进行写操作时,CPU会做什么事情。
Java代码如下。
——————————————————————————
instance = new Singleton(); // instance是volatile变量
——————————————————————————
转变成汇编代码,如下。
——————————————————————————
0x01a3de1d: movb $0×0,0×1104800(%esi);0x01a3de24: lock addl $0×0,(%esp);
——————————————————————————
 
有volatile变量修饰的共享变量进行写操作的时候会多出第二行汇编代码,通过查IA-32架构软件开发者手册可知,Lock前缀的指令在多核处理器下会引发了两件事情[1]。
1)将当前处理器缓存行的数据写回到系统内存。
2)这个写回内存的操作会使在其他CPU里缓存了该内存地址的数据无效。
  为了提高处理速度,处理器不直接和内存进行通信,而是先将系统内存的数据读到内部缓存(L1,L2或其他)后再进行操作,但操作完不知道何时会写到内存。如果对声明了volatile的变量进行写操作,JVM就会向处理器发送一条Lock前缀的指令,将这个变量所在缓存行的数据写回到系统内存。但是,就算写回到内存,如果其他处理器缓存的值还是旧的,再执行计算操作就会有问题。所以,在多处理器下,为了保证各个处理器的缓存是一致的,就会实现缓存一致性协议,每个处理器通过嗅探在总线上传播的数据来检查自己缓存的值是不是过期了,当处理器发现自己缓存行对应的内存地址被修改,就会将当前处理器的缓存行设置成无效状态,当处理器对这个数据进行修改操作的时候,会重新从系统内存中把数据读到处理器缓存里。
 
下面来具体讲解volatile的两条实现原则。
1)Lock前缀指令会引起处理器缓存回写到内存。Lock前缀指令导致在执行指令期间,声言处理器的LOCK#信号。在多处理器环境中,LOCK#信号确保在声言该信号期间,处理器可以独占任何共享内存[2]。但是,在最近的处理器里,LOCK#信号一般不锁总线,而是锁缓存,毕竟锁总线开销的比较大。在8.1.4节有详细说明锁定操作对处理器缓存的影响,对于Intel486和Pentium处理器,在锁操作时,总是在总线上声言LOCK#信号。但在P6和目前的处理器中,如果访问的内存区域已经缓存在处理器内部,则不会声言LOCK#信号。相反,它会锁定这块内存区域的缓存并回写到内存,并使用缓存一致性机制来确保修改的原子性,此操作被称为“缓存锁定”,缓存一致性机制会阻止同时修改由两个以上处理器缓存的内存区域数据。
 
2)一个处理器的缓存回写到内存会导致其他处理器的缓存无效。IA-32处理器和Intel 64处理器使用MESI(修改、独占、共享、无效)控制协议去维护内部缓存和其他处理器缓存的一致性。在多核处理器系统中进行操作的时候,IA-32和Intel 64处理器能嗅探其他处理器访问系统内存和它们的内部缓存。处理器使用嗅探技术保证它的内部缓存、系统内存和其他处理器的缓存的数据在总线上保持一致。例如,在Pentium和P6 family处理器中,如果通过嗅探一个处理器来检测其他处理器打算写内存地址,而这个地址当前处于共享状态,那么正在嗅探的处理器将使它的缓存行无效,在下次访问相同内存地址时,强制执行缓存行填充。
 
2.volatile的使用优化
  著名的Java并发编程大师Doug lea在JDK 7的并发包里新增一个队列集合类LinkedTransferQueue,它在使用volatile变量时,用一种追加字节的方式来优化队列出队和入队的性能。LinkedTransferQueue的代码如下。
/** 队列中的头部节点 */
private transient f?inal PaddedAtomicReference head;
/** 队列中的尾部节点 */
private transient f?inal PaddedAtomicReference tail;
static f?inal class PaddedAtomicReference extends AtomicReference T> {
// 使用很多4个字节的引用追加到64个字节
Object p0, p1, p2, p3, p4, p5, p6, p7, p8, p9, pa, pb, pc, pd, pe;
  PaddedAtomicReference(T r) {
    super(r);
  }
}
public class AtomicReference implements java.io.Serializable {
private volatile V value;
// 省略其他代码
}
  追加字节能优化性能?这种方式看起来很神奇,但如果深入理解处理器架构就能理解其中的奥秘。让我们先来看看LinkedTransferQueue这个类,它使用一个内部类类型来定义队列的头节点(head)和尾节点(tail),而这个内部类PaddedAtomicReference相对于父类AtomicReference只做了一件事情,就是将共享变量追加到64字节。我们可以来计算下,一个对象的引用占4个字节,它追加了15个变量(共占60个字节),再加上父类的value变量,一共64个字节。
  为什么追加64字节能够提高并发编程的效率呢?因为对于英特尔酷睿i7、酷睿、Atom和NetBurst,以及Core Solo和Pentium M处理器的L1、L2或L3缓存的高速缓存行是64个字节宽,不支持部分填充缓存行,这意味着,如果队列的头节点和尾节点都不足64字节的话,处理器会将它们都读到同一个高速缓存行中,在多处理器下每个处理器都会缓存同样的头、尾节点,当一个处理器试图修改头节点时,会将整个缓存行锁定,那么在缓存一致性机制的作用下,会导致其他处理器不能访问自己高速缓存中的尾节点,而队列的入队和出队操作则需要不停修改头节点和尾节点,所以在多处理器的情况下将会严重影响到队列的入队和出队效率。Doug lea使用追加到64字节的方式来填满高速缓冲区的缓存行,避免头节点和尾节点加载到同一个缓存行,使头、尾节点在修改时不会互相锁定。
   那么是不是在使用volatile变量时都应该追加到64字节呢?不是的。在两种场景下不应该使用这种方式。
  ·缓存行非64字节宽的处理器。如P6系列和奔腾处理器,它们的L1和L2高速缓存行是32个字节宽。·共享变量不会被频繁地写。因为使用追加字节的方式需要处理器读取更多的字节到高速缓冲区,这本身就会带来一定的性能消耗,如果共享变量不被频繁写的话,锁的几率也非常小,就没必要通过追加字节的方式来避免相互锁定。不过这种追加字节的方式在Java 7下可能不生效,因为Java 7变得更加智慧,它会淘汰或重新排列无用字段,需要使用其他追加字节的方式。除了volatile,Java并发编程中应用较多的是synchronized,下面一起来看一下。
1.这两件事情在IA-32软件开发者架构手册的第三册的多处理器管理章节(第8章)中有详细阐述。
2.因为它会锁住总线,导致其他CPU不能访问总线,不能访问总线就意味着不能访问系统内存。


Java并发机制的底层实现原理之volatile应用,初学者误看!的更多相关文章

  1. 《Java并发编程的艺术》Java并发机制的底层实现原理(二)

    Java并发机制的底层实现原理 1.volatile volatile相当于轻量级的synchronized,在并发编程中保证数据的可见性,使用 valotile 修饰的变量,其内存模型会增加一个 L ...

  2. 【java并发编程艺术学习】(三)第二章 java并发机制的底层实现原理 学习记录(一) volatile

    章节介绍 这一章节主要学习java并发机制的底层实现原理.主要学习volatile.synchronized和原子操作的实现原理.Java中的大部分容器和框架都依赖于此. Java代码 ==经过编译= ...

  3. Java 并发系列之二:java 并发机制的底层实现原理

    1. 处理器实现原子操作 2. volatile /** 补充: 主要作用:内存可见性,是变量在多个线程中可见,修饰变量,解决一写多读的问题. 轻量级的synchronized,不会造成阻塞.性能比s ...

  4. 《Java并发编程的艺术》读书笔记:二、Java并发机制的底层实现原理

    二.Java并发机制底层实现原理 这里是我的<Java并发编程的艺术>读书笔记的第二篇,对前文有兴趣的朋友可以去这里看第一篇:一.并发编程的目的与挑战 有兴趣讨论的朋友可以给我留言! 1. ...

  5. (第二章)Java并发机制的底层实现原理

    一.概述 Java代码在编译后会变成Java字节码,字节码被类加载器加载到JVM里,JVM执行字节码,最终需要转化为汇编指令在CPU上执行,Java中所使用的并发机制依赖于JVM的实现和CPU的指令. ...

  6. Java并发机制和底层实现原理

    Java代码在编译后会变成Java字节码,字节码被类加载器加载到JVM里,JVM执行字节码转化为汇编指令在CPU上执行.Java中的并发机制依赖于JVM的实现和CPU的指令. Java语言规范第三版中 ...

  7. 并发艺术--java并发机制的底层实现原理

    前言 Java代码在编译后会变成Java字节码,字节码被类加载器加载到JVM里,JVM执行字节码,最终需要转化为汇编指令在CPU上执行,Java中所使用的并发机制依赖于JVM的实现和CPU的指令. 一 ...

  8. java并发机制的底层实现原理

    volatile是轻量级的synchronized,它在多处理器开发中保证了共享变量的"可见性".可见性是说当一个线程修改一个共享变量时,另外一个线程能读到这个修改的值. vola ...

  9. 【java并发编程艺术学习】(五)第二章 java并发机制的底层实现原理 学习记录(三) 原子操作的实现原理学习

    章节介绍 主要包括 术语定义.处理器如何实现原子操作.Java如何实现原子操作: 原子(atomic)本意是 不能再进一步分割的最小粒子,“原子操作” 意为 不可被中断的一个或一系列操作. 术语定义 ...

随机推荐

  1. LeetCode172 Factorial Trailing Zeroes. LeetCode258 Add Digits. LeetCode268 Missing Number

    数学题 172. Factorial Trailing Zeroes Given an integer n, return the number of trailing zeroes in n!. N ...

  2. Servlet会话跟踪和Cookies及HttpSession会话

    会话只是指一段指定的时间间隔. 会话跟踪是维护用户状态(数据)的一种方式.它也被称为servlet中的会话管理. Http协议是一个无状态的,所以我们需要使用会话跟踪技术来维护用户状态. 每次用户请求 ...

  3. springboot thymeleaf【转】【补】

    thymeleaf模板 https://www.thymeleaf.org/doc/tutorials/3.0/usingthymeleaf.html 1.引入thymeleaf依赖 <!-- ...

  4. 巨蟒python全栈开发-第11阶段 ansible_project2

    一个NB的网站: https://www.toolfk.com/ CDN:将用户的需求送到最近的节点:内容分发网络 有些是专门做CDN的工具 常用的markdown是需要知道的,短信有字数限制. we ...

  5. 前端基础☞CSS

    css的四种引入方式 1.行内式 行内式是在标记的style属性中设定CSS样式.这种方式没有体现出CSS的优势,不推荐使用. <p style="background-color: ...

  6. Python 官方文档:入门教程

    https://pythoncaff.com/docs/tutorial/3.7.0 官方入门教程,从这里开始你的 Python 之旅,将长久维护 基础信息 翻译说明 关于本教程 已完成 正文 1. ...

  7. 详解Python中内置的NotImplemented类型的用法

    它是什么? ? 1 2 >>> type(NotImplemented) <type 'NotImplementedType'> NotImplemented 是Pyth ...

  8. @codechef - TREEPATH@ Decompose the Tree

    目录 @description@ @solution@ @accepted code@ @details@ @description@ 给定一棵无根树,每个节点上都写了一个整数. 你的任务就是统计有多 ...

  9. 用户注册页的布局及js逻辑实现(正则,注册按钮)

    文章地址:https://www.cnblogs.com/sandraryan/ 先写一个简单的静态页面,然后对用户输入的内容进行验证,判断输入的值是否符合规则,符合规则进行注册 先上静态页面 < ...

  10. Python--day30--软件开发架构

    软件开发架构: C/S架构: B/S架构: B/S架构和C/S架构的关系: