
Mahout介绍
3.11简介
Mahout:是一个Apache的一个开源的机器学习库,主要实现了三大类算法Recommender
(collaborative filtering)、Clustering、classification。可扩展,用Java实现,用MapReduce实现了部分数据挖掘算法,解决了并行挖掘的问题。
Mahout为数据分析人员,解决了大数据的门槛;为算法工程师提供了基础算法库;为Hadoop开发人员提供了数据建模的标准。
——张丹(Conan) http://blog.fens.me/hadoop-mahout-roadmap/
3.12Mahout历史演变
Mahout began life in 2008 as a project of Apache`s lucene project .Lucene provides advanced implementations of search ,text mining and information-retrival techniques.In the universe of computer science ,there concepts are adjacent to machine learning techniques like clustering and to an extent ,classification .As a result,some of the work of the Lucene committers that fell more into these machine learning areas was spun off into its own subproject. Soon after ,Mahout absorbed the Taste open source collaborative filtering project.As of April 2010 ,Mahout became a top-level Apache project in its own right, and get a bran-new elephant rider logo to boot.
——Mahout in Action
25 April 2014 - Goodbye MapReduce
The Mahout community decided to move its codebase onto modern data processing systems that offer a richer programming model and more efficient execution than Hadoop MapReduce. Mahout will therefore reject new MapReduce algorithm implementations from now on. We will however keep our widely used MapReduce algorithms in the codebase and maintain them.
We are building our future implementations on top of a DSL for linear algebraic operations which has been developed over the last months. Programs written in this DSL are automatically optimized and executed in parallel on Apache Spark.
——http://mahout.apache.org/
3.13Hadoop家族中Mahout的结构图
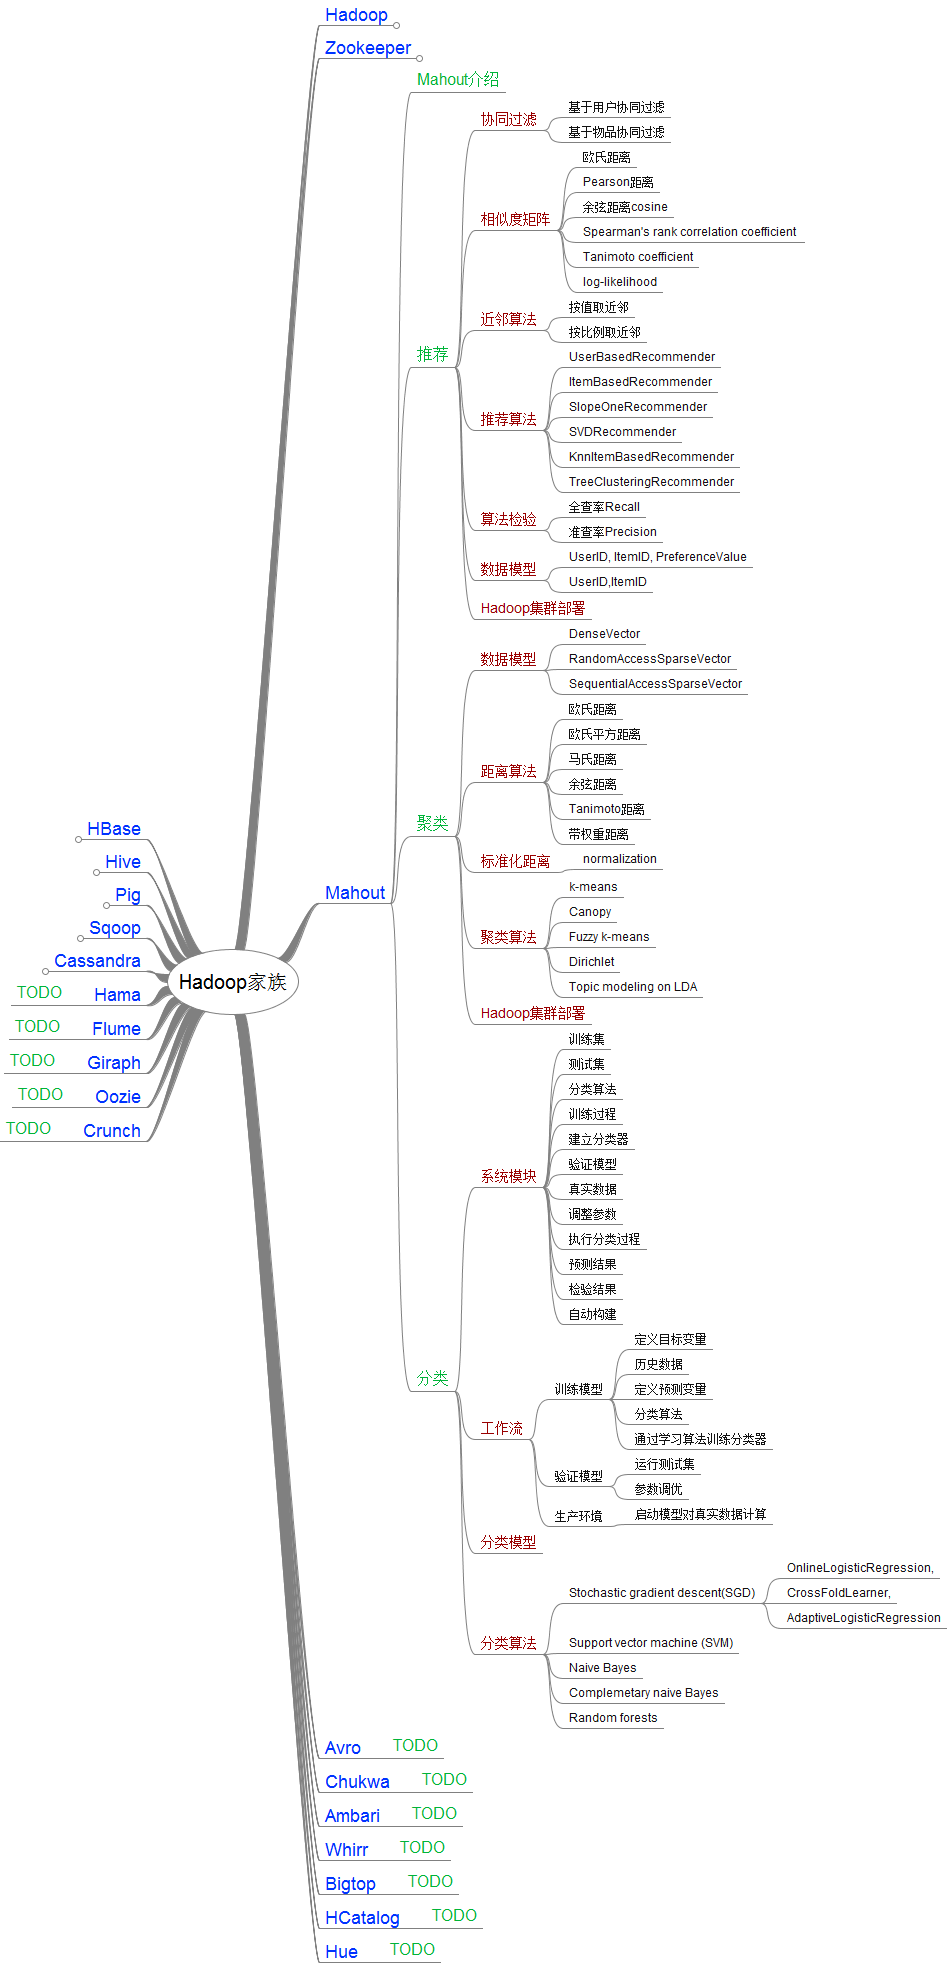
主要算法:
|
算法类 |
算法名 |
中文名 |
|
分类算法 |
Logistic Regression |
逻辑回归 |
|
Bayesian |
贝叶斯 |
|
|
SVM |
支持向量机 |
|
|
Perceptron |
感知器算法 |
|
|
Neural Network |
神经网络 |
|
|
Random Forests |
随机森林 |
|
|
Restricted Boltzmann Machines |
有限波尔兹曼机 |
|
|
聚类算法 |
Canopy Clustering |
Canopy聚类 |
|
K-means Clustering |
K均值算法 |
|
|
Fuzzy K-means |
模糊K均值 |
|
|
Expectation Maximization |
EM聚类(期望最大化聚类) |
|
|
Mean Shift Clustering |
均值漂移聚类 |
|
|
Hierarchical Clustering |
层次聚类 |
|
|
Dirichlet Process Clustering |
狄里克雷过程聚类 |
|
|
Latent Dirichlet Allocation |
LDA聚类 |
|
|
Spectral Clustering |
谱聚类 |
|
|
关联规则挖掘 |
Parallel FP Growth Algorithm |
并行FP Growth算法 |
|
回归 |
Locally Weighted Linear Regression |
局部加权线性回归 |
|
降维/维约简 |
Singular Value Decomposition |
奇异值分解 |
|
Principal Components Analysis |
主成分分析 |
|
|
Independent Component Analysis |
独立成分分析 |
|
|
Gaussian Discriminative Analysis |
高斯判别分析 |
|
|
进化算法 |
并行化了Watchmaker框架 |
|
|
推荐/协同过滤 |
Non-distributed recommenders |
Taste(UserCF, ItemCF, SlopeOne) |
|
Distributed Recommenders |
ItemCF |
|
|
向量相似度计算 |
RowSimilarityJob |
计算列间相似度 |
|
VectorDistanceJob |
计算向量间距离 |
|
|
非Map-Reduce算法 |
Hidden Markov Models |
隐马尔科夫模型 |
|
集合方法扩展 |
Collections |
扩展了java的Collections类 |
3.14Mahout在Hadoop 平台上的安装
1.下载mahout:http://archive.apache.org/dist/mahout/
2.下载Maven 一般ubuntu系统直接 sudo apt-get install maven
3.将mahout 的文件解压成文件夹mahout 并放入/usr文件夹
sudo tar -zxvf mahout-distribution-0.9.tar.gz
sudo mv mahout-distribution-0.9 /usr/mahout
4.创建一个脚本,配置mahout的环境。脚本内容
export JAVA_HOME=/usr/lib/jvm/jdk8/
export MAHOUT_HOME=/usr/mahout9
export MAHOUT_CONF_DIR=/usr/mahout9/conf
export PATH=$MAHOUT_HOME/bin:$MAHOUT_HOME/conf:$PATH
export HADOOP_HOME=/usr/hadoop
export HADOOP_CONF_DIR=/usr/hadoop/conf
export PATH=$PATH:$HADOOP_HOME/bin
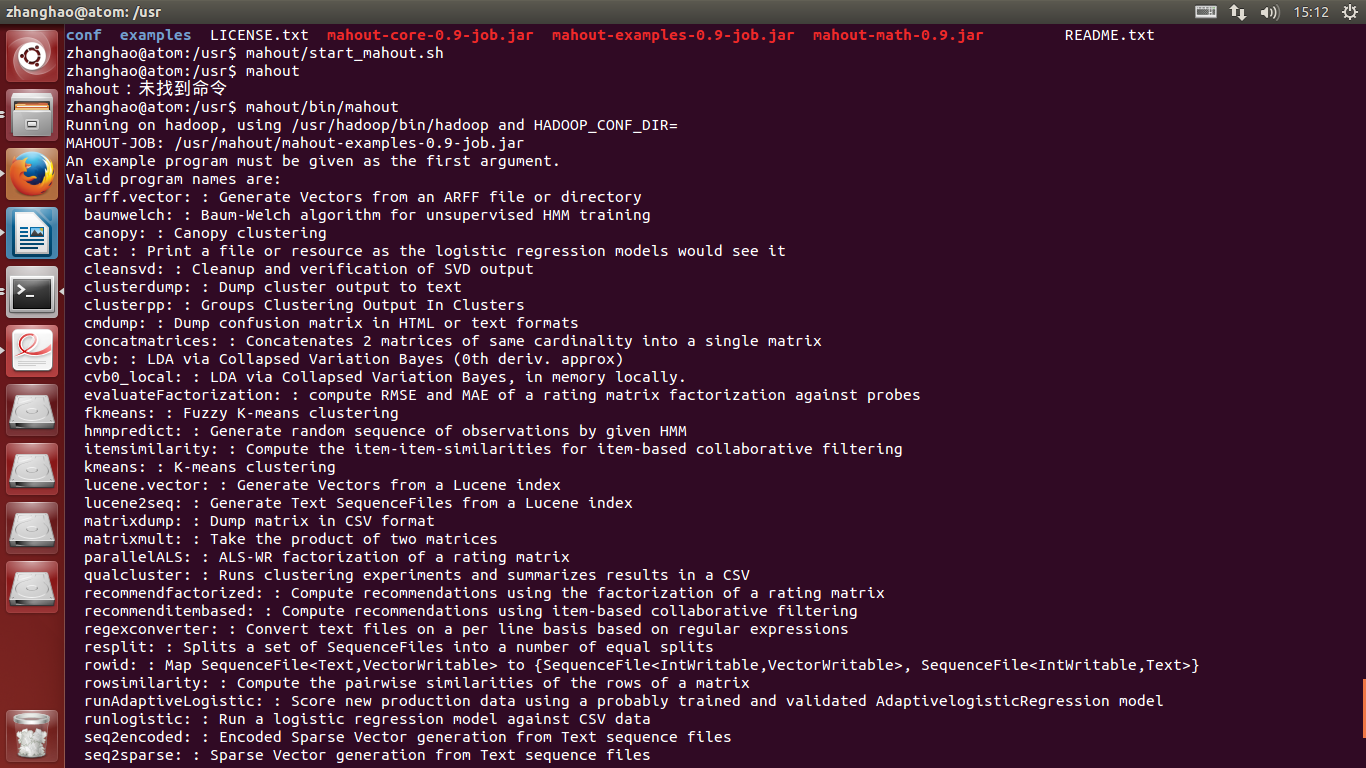
5.运行脚本文件,运行mahout命令
6.到这里就表示安装成功,下面下载一个测书数据,是一下mahout 的Kmeans聚类方法。
Sudo wget http://archive.ics.uci.edu/ml/databases/synthetic_control/synthetic_control.data
7.将数据上传到HDFS 上
hdfs fs -mkdir testdata
hdfs fs -put /usr/synthetic_control.data ./testdata
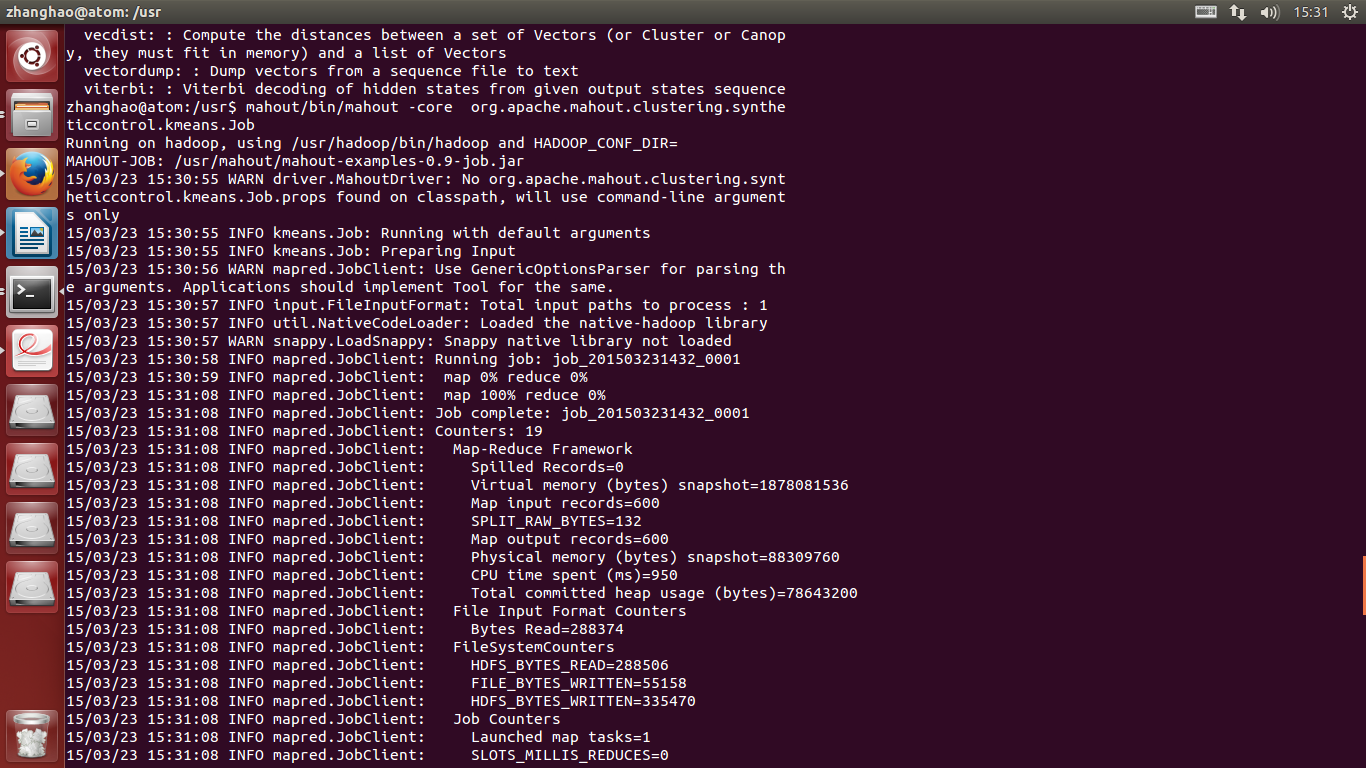
8.运行k-means聚类算法
mahout -core org.apache.clustering.syntheticcontrol.kmeans.Job
Mahout介绍的更多相关文章
- Mahout介绍、安装与应用案例
搭建环境 部署节点操作系统为CentOS,防火墙和SElinux禁用,创建了一个shiyanlou用户并在系统根目录下创建/app目录,用于存放 Hadoop等组件运行包.因为该目录用于安装h ...
- Mahout介绍和简单应用
Mahout学习(主要学习内容是Mahout中推荐部分的ItemCF.UserCF.Hadoop集群部署运行) 1.Mahout是什么? Mahout是一个算法库,集成了很多算法. Apache Ma ...
- Mahout介绍-炼数
Mahout的中文含义:象夫
- Mahout 介绍
1.Hbase+k-means (G级别) 2.k-means+mr (T级别) 1. 2.canopy 2.贝叶斯算法 决策,分类,文档分类 3.推荐系统 4.图书推荐系统 1.需求 付完款的用户 ...
- Hadoop入门进阶课程9--Mahout介绍、安装与应用案例
本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,博主为石山园,博客地址为 http://www.cnblogs.com/shishanyuan ...
- Hadoop第10周练习—Mahout部署及进行20newsgroup数据分析例子
:搭建Mahout环境 :运行20newsgroup 内容 运行环境说明 1.1 硬软件环境 线程,主频2.2G,6G内存 l 虚拟软件:VMware® Workstation 9.0.0 buil ...
- 转】Mahout学习路线图
原博文出自于: http://blog.fens.me/hadoop-mahout-roadmap/ 感谢! Mahout学习路线图 Hadoop家族系列文章,主要介绍Hadoop家族产品,常用的项目 ...
- mahout第一篇-----Mahout学习路线图
Mahout学习路线图 前言 Mahout是Hadoop家族中与众不同的一个成员,是基于一个Hadoop的机器学习和数据挖掘的分布式计算框架.Mahout是一个跨学科产品,同时也是我认为Hadoop家 ...
- Mahout学习路线图
转自:http://blog.fens.me/hadoop-mahout-roadmap/ Mahout学习路线图 Hadoop家族系列文章,主要介绍Hadoop家族产品,常用的项目包括Hadoop, ...
随机推荐
- Linux服务器安装tomcat、JDK、SVN等常用开发软件总结
本来本文发布到首页的,该网站运营人员移除了,说我这篇博文太简单了,如果感觉我这篇博文有用的,大家给个推荐,打一下运营人员的脸 目录 一.Ubuntu 16.04下安装JDK(spring 3.2不支持 ...
- Java集合 之List(ArrayList、LinkedList、Vector、Stack)理解(new)
一. ArrayList底层实现原理 对比 和Vector不同,ArrayList中的操作不是线程安全的!所以,建议在单线程中才使用ArrayList,而在多线程中可以选择Vector或者CopyOn ...
- 统计Redis中各种数据的大小
如果 MySQL 数据库比较大的话,很容易就能查出是哪些表占用的空间: 不过如果 Redis 内存比较大的话, […]
- 02_linux常用指令
[用户管理] 查看当前用户 whoami 新建用户 sudo adduser higginCui 查看新建用户 ls /home 使用新建用户登录 su -l higg ...
- Ta们,用云计算改变着更多普通人的生活,所以,我们1218
维族音乐的传承者:为家园建设生态农业:为50万货运司机谋福利:电视游戏行业复兴的倡导者:......还有很多平凡普通的人,不同的主角.不同的情节,用自己的云上轨迹在点滴改变着我们的周遭世界.所以,我们 ...
- C# Winform窗体和控件自适应大小
1.在项目中创建类AutoSizeForm AutoSizeForm.cs文件代码: using System; using System.Collections.Generic; using Sys ...
- 13.git别名
虽然别名不是很重要,但是你大概应该知道如何使用它们. Git 并不会在你输入部分命令时自动推断出你想要的命令. 如果不想每次都输入完整的 Git 命令,可以通过 git config 文件来轻松地为每 ...
- Postfix的工作原理
传统的Sendmail将所有功能都集中在同一个程序里,这种结构我们称之为“单体式设计”(monolithic).Postfix采用专职负责的策略,不同的功能分别交由不同的专门程序处理,这种结构称为“模 ...
- OutputStream-InputStream-FileOutputStream-FileInputStream-BufferedOutputStream-BufferedInputStream-四种复制方式-单层文件夹复制
字节流两套: java.lang.Object--java.io.OutputStream--java.io.FileOutputStream java.lang.Ob ...
- js 数据格式化
//金额增加千分号formatPrice(123456.78) = 123,456.78 function formatPrice(val) { var parts = val.toString(). ...