
(未完成...)Python3网络爬虫(2):利用urllib.urlopen向有道翻译发送数据并获得翻译结果
环境:
火狐浏览器
pycharm2017.3.3
python3.5
1.url不仅可以是一个字符串,例如:http://www.baidu.com。url也可以是一个Request对象,这就需要我们先定义一个Request对象,然后将这个Request对象作为URLopen的参数使用,方法如下:
 from urllib import request

 req = request.Request("http://fanyi.baidu.com/")
 response = request.urlopen(req)
 html = response.read()
 html = html.decode("utf-8")
 print(html)
这段代码同样可以得到网页信息
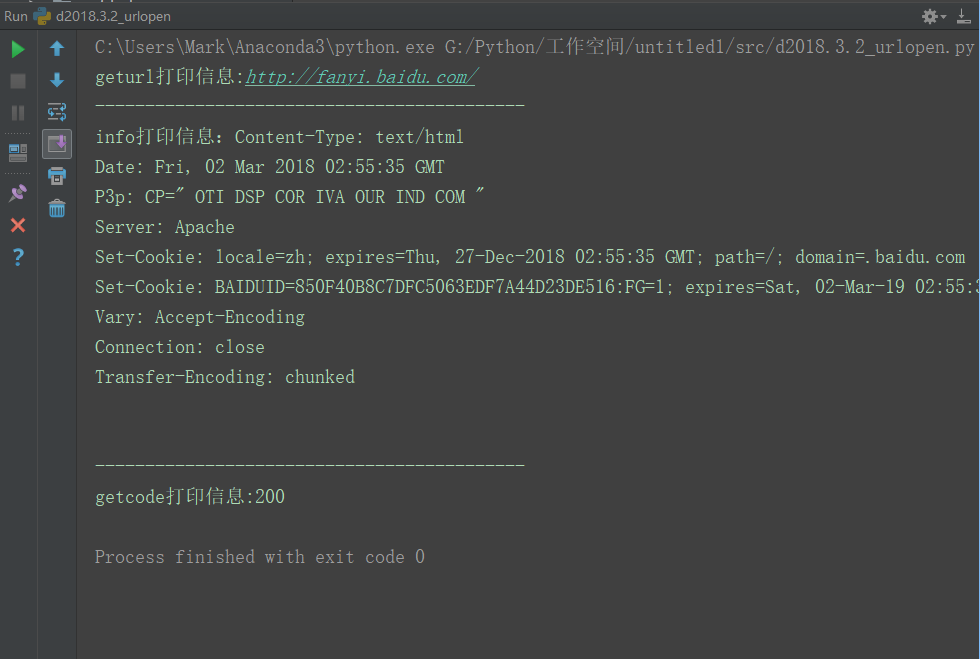
urlopen()返回的对象,可以使用read()进行读取,同样也可以使用geturl(),info()方法,getcode()方法。
geturl()返回的是一个url的字符串;
info()返回的是一些meta标记的元信息,包括一些服务器的信息;
getcode()返回的是HTTP的状态码,如果返回200表示请求成功;
根据这些,编写如下代码
 from urllib import request
 req = request.Request("http://fanyi.baidu.com/")
 response = request.urlopen(req)
 print("geturl打印信息:%s" % (response.geturl()))
 print("-------------------------------------------")
 print("info打印信息:%s" % (response.info()))
 print("-------------------------------------------")
 print("getcode打印信息:%s" % (response.getcode()))
运行结果
2.urlopen的data参数
我们可以使用data参数,向服务器发送数据
从客户端向服务器提交数据使用post
如果没有设置urlopen()函数的data参数,HTTP请求采用get方式也就是从服务器获取数据,如果我们设置data参数,HTTP请求采用post方式,就可以向服务器传送数据
3.发送data实例
向有道翻译发送data,得到翻译结果
(1)打开有道翻译界面,如下图所示
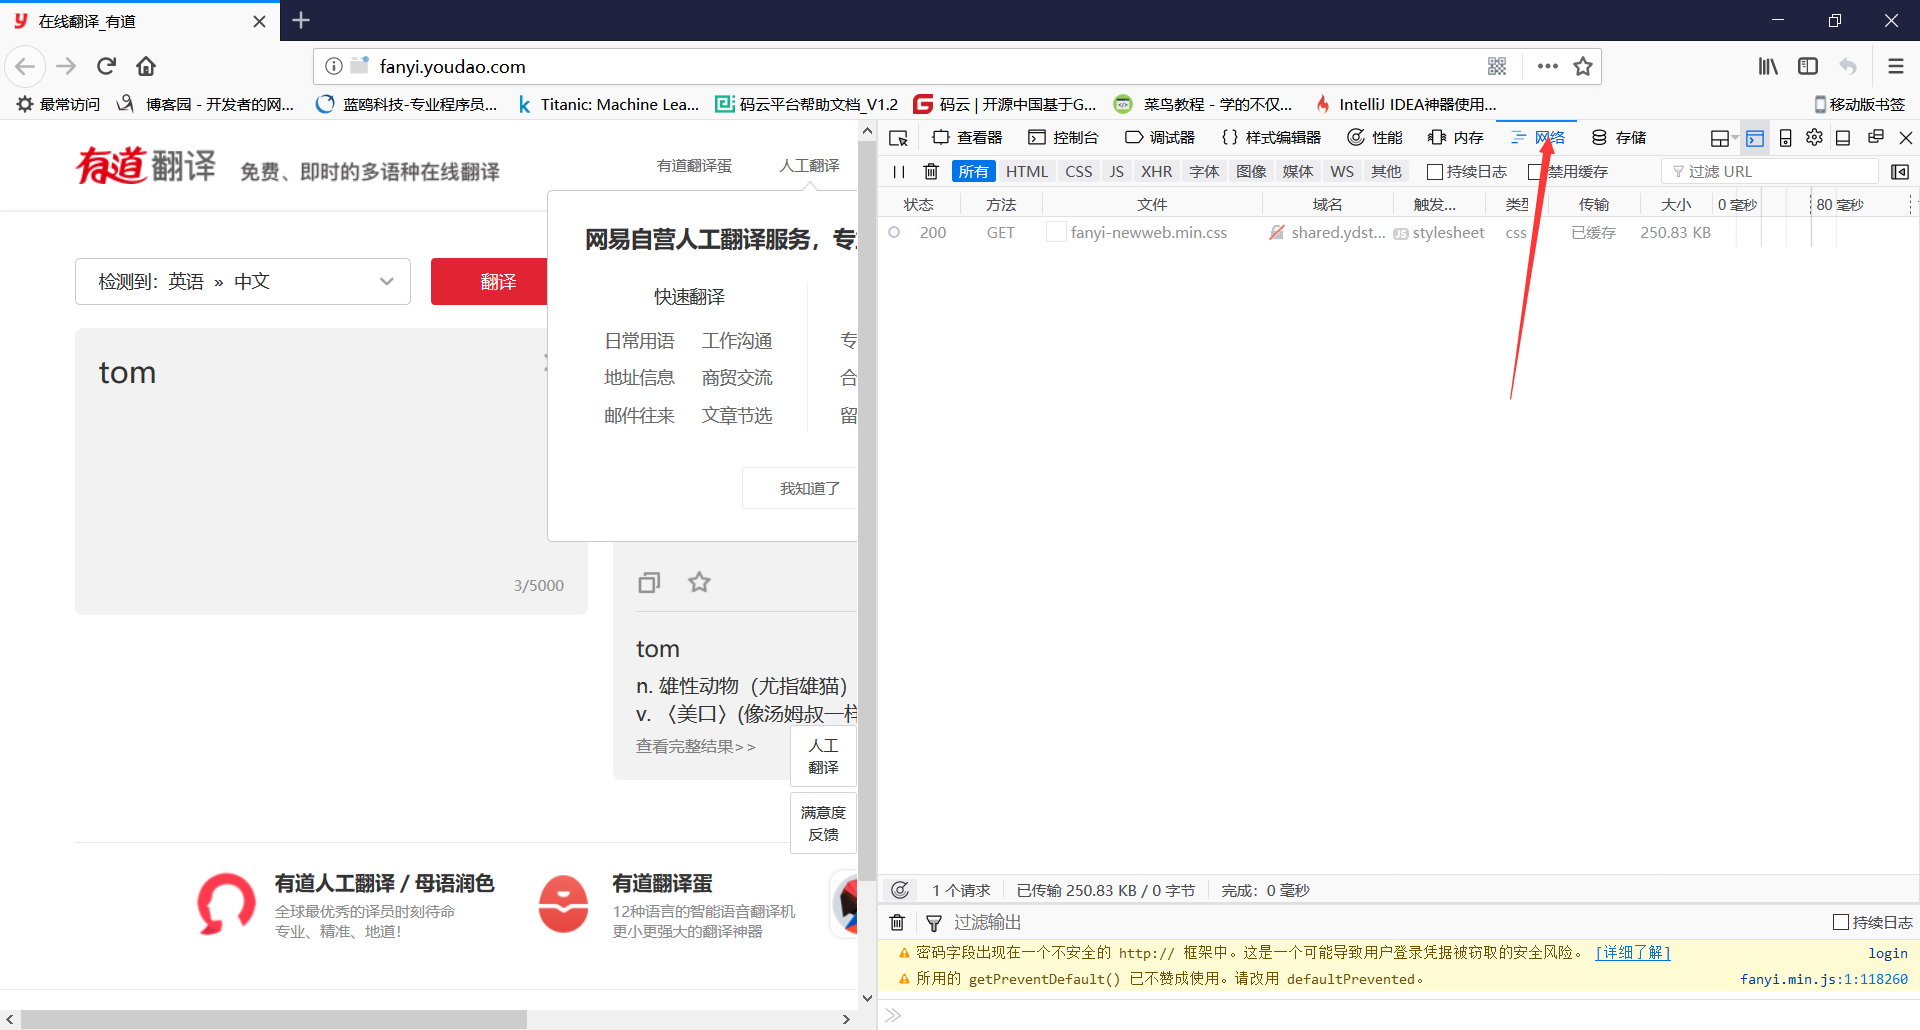
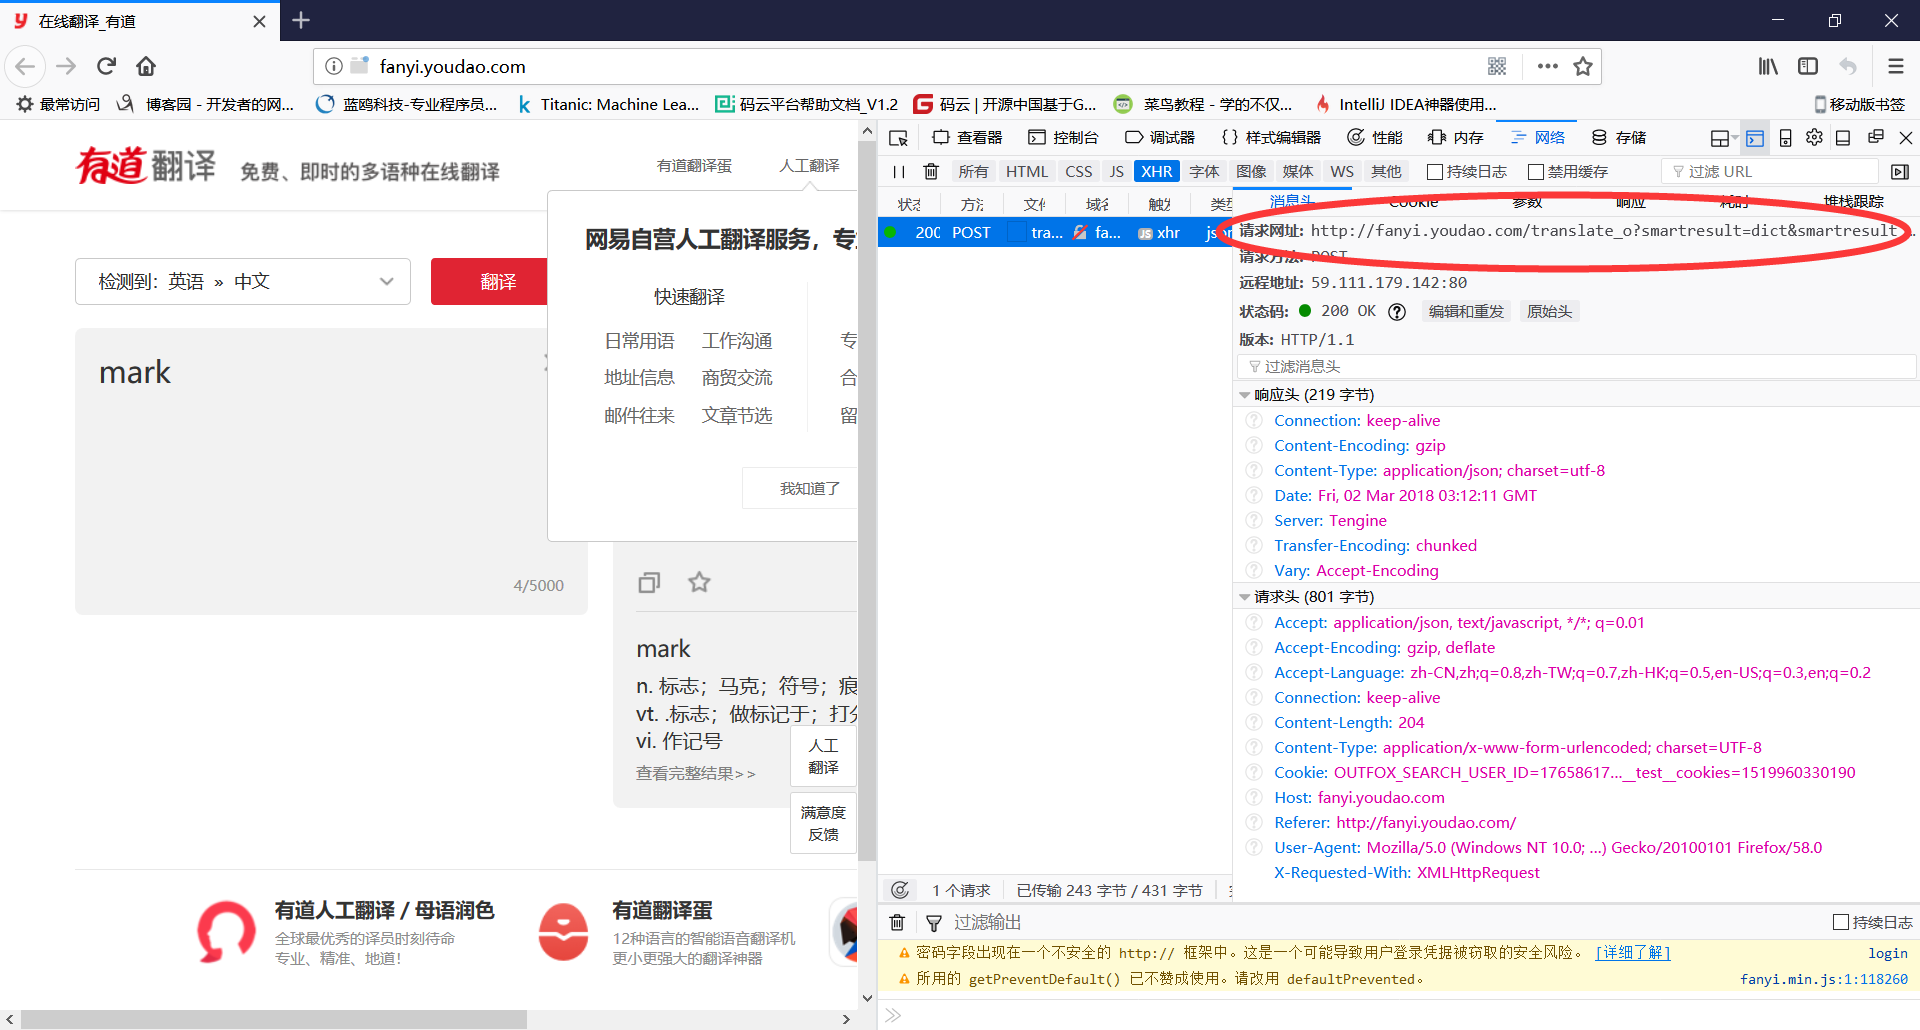
(2)右键查看元素,选择网络
(3)在翻译中输入单词mark,点击翻译,可以看到列表出现了新东西,双击方式为post的这行
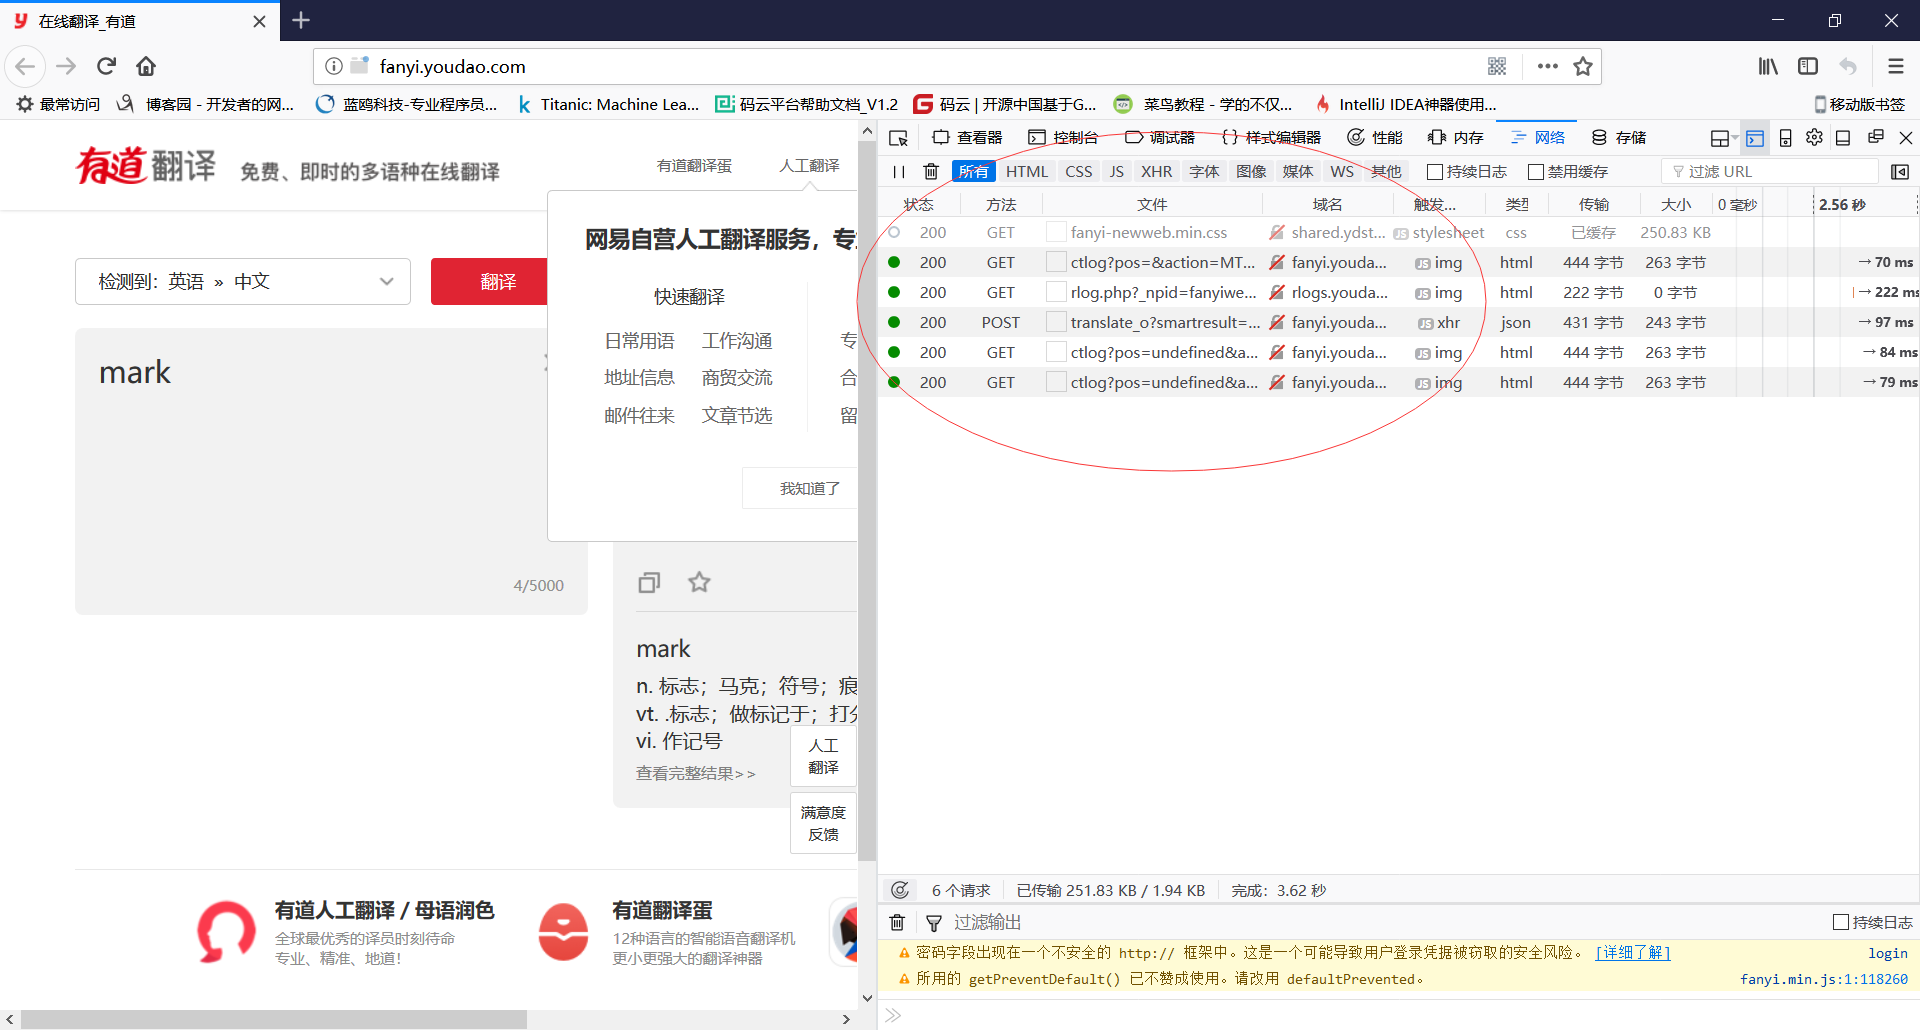
(4)查看消息头中的请求网址,记录下来,一会要用
(5)点击参数,得到表单数据,记录下来,一会要用
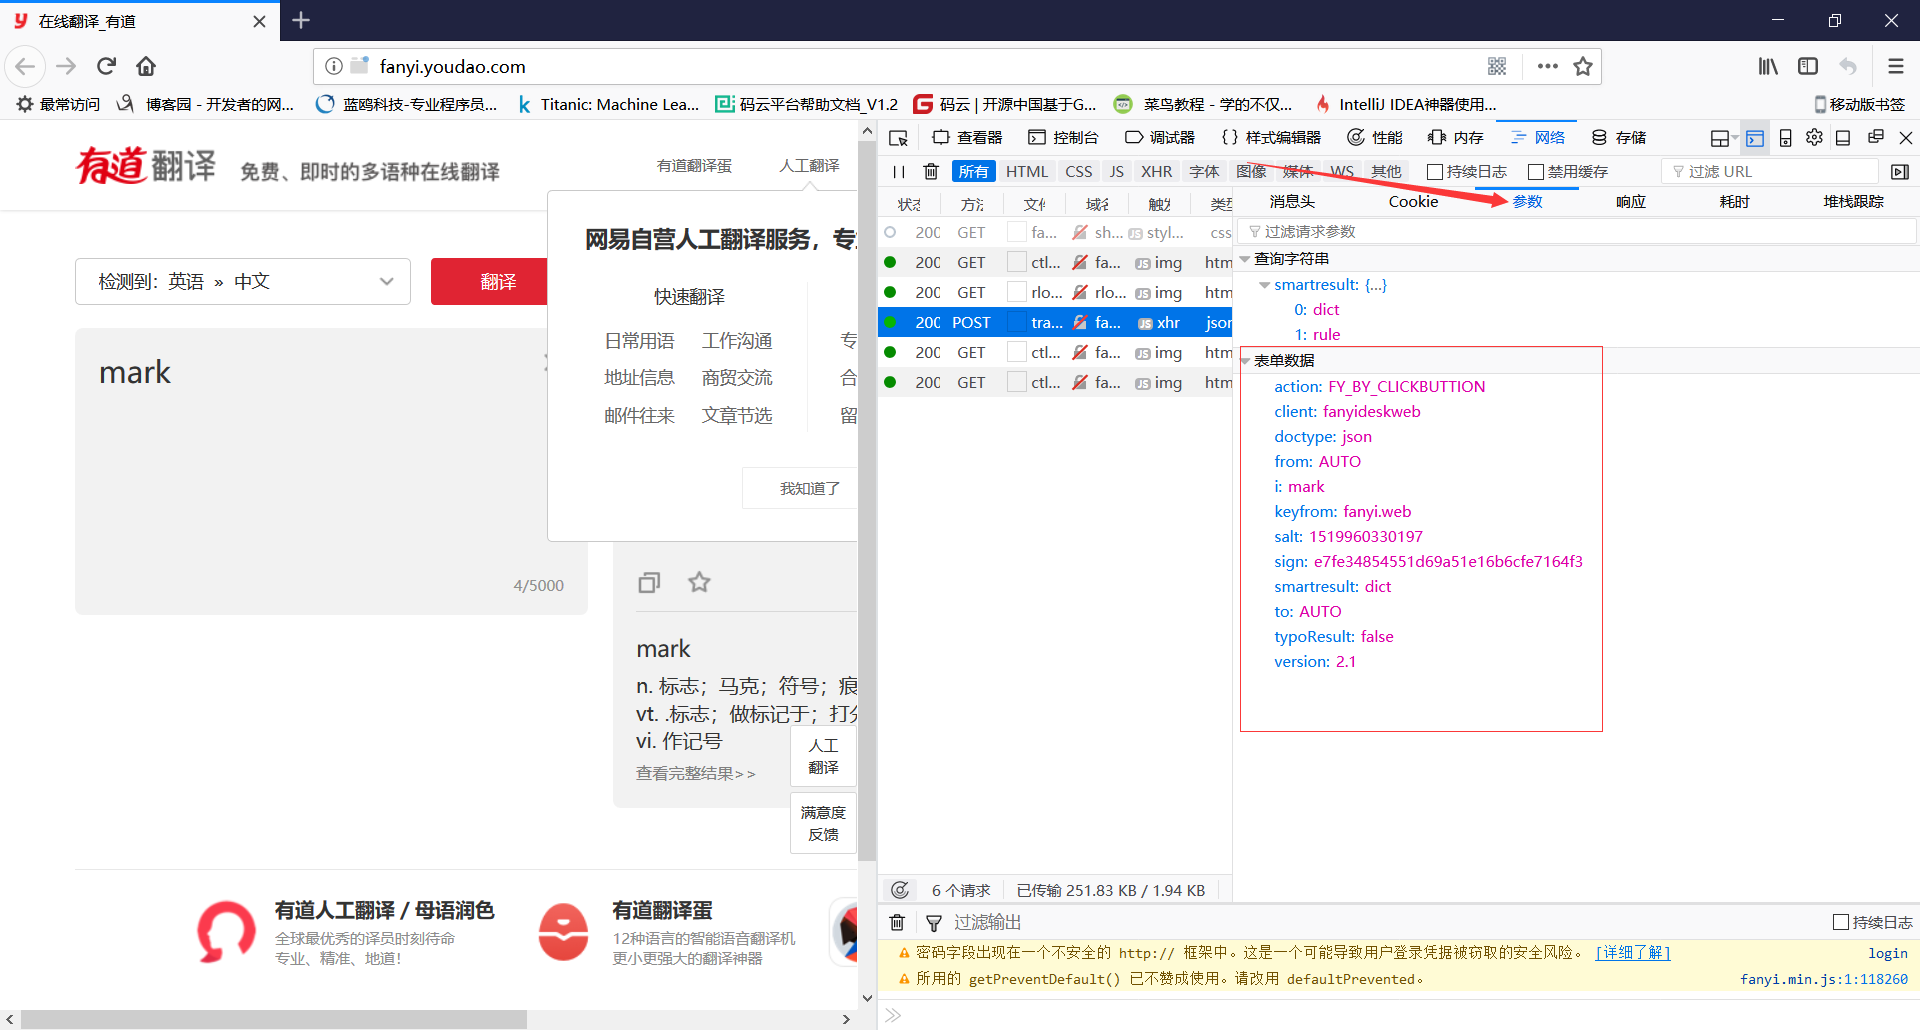
(6)得到以上数据后,写代码如下
这。。。里有点问题了,好像不能通过抓包爬了,还得使用它的api,研究了一会没整明白,写了这么多,不舍得删了,先撂这,以后再弄,我去找一个抓包可以爬的,再写一篇新的
(未完成...)Python3网络爬虫(2):利用urllib.urlopen向有道翻译发送数据并获得翻译结果的更多相关文章
- Python3网络爬虫(三):urllib.error异常
运行平台:Windows Python版本:Python3.x IDE:Sublime text3 转载请注明作者和出处:http://blog.csdn.net/c406495762/article ...
- 利用urllib.urlopen向有道翻译发送数据获得翻译结果
from urllib import request,parseimport requests, sys,ssl,json ssl._create_default_https_context = ss ...
- Python3爬虫(2)_利用urllib.urlopen发送数据获得反馈信息
一.urlopen的url参数 Agent url不仅可以是一个字符串,例如:https://baike.baidu.com/.url也可以是一个Request对象,这就需要我们先定义一个Reques ...
- 转:【Python3网络爬虫开发实战】 requests基本用法
1. 准备工作 在开始之前,请确保已经正确安装好了requests库.如果没有安装,可以参考1.2.1节安装. 2. 实例引入 urllib库中的urlopen()方法实际上是以GET方式请求网页,而 ...
- Python3网络爬虫开发实战PDF高清完整版免费下载|百度云盘
百度云盘:Python3网络爬虫开发实战高清完整版免费下载 提取码:d03u 内容简介 本书介绍了如何利用Python 3开发网络爬虫,书中首先介绍了环境配置和基础知识,然后讨论了urllib.req ...
- Python3 网络爬虫(请求库的安装)
Python3 网络爬虫(请求库的安装) 爬虫可以简单分为几步:抓取页面,分析页面和存储数据 在页面爬取的过程中我们需要模拟浏览器向服务器发送请求,所以需要用到一些python库来实现HTTP的请求操 ...
- 崔庆才Python3网络爬虫开发实战电子版书籍分享
资料下载地址: 链接:https://pan.baidu.com/s/1WV-_XHZvYIedsC1GJ1hOtw 提取码:4o94 <崔庆才Python3网络爬虫开发实战>高清中文版P ...
- 《Python3 网络爬虫开发实战》开发环境配置过程中踩过的坑
<Python3 网络爬虫开发实战>学习资料:https://www.cnblogs.com/waiwai14/p/11698175.html 如何从墙内下载Android Studio: ...
- 《Python3 网络爬虫开发实战》学习资料
<Python3 网络爬虫开发实战> 学习资料 百度网盘:https://pan.baidu.com/s/1PisddjC9e60TXlCFMgVjrQ
随机推荐
- 《MySQL必知必会》[06] 触发器
1.触发器 MySQL中的触发器概念,和Java中的事件监听器有点相似.当你想要某条语句在某个事件发生时自动执行,就要用到触发器了. 触发器能响应如下三类语句: DELETE INSERT UPDAT ...
- 创建一个宽高成比例的弹性div盒子
这里先提供一种,有更好的方法再补充. demo代码如下: <!DOCTYPE html> <html lang="en"> <head> < ...
- NOI Day1线上同步赛梦游记
Preface 第一次体验NOI,虽然不是正式选手,但是打打同步赛还是挺涨姿势的,也算是体验了一把. Day1很爆炸,一方面是NOI题目的难度高于自身的水平,另一方面也出现了比较大的失误,T1一个数组 ...
- 在平衡树的海洋中畅游(二)——Scapegoat Tree
在平衡树的广阔天地中,以Treap,Splay等为代表的通过旋转来维护平衡的文艺平衡树占了觉大部分. 然而,今天我们要讲的Scapegoat Tree(替罪羊树)就是一个特立独行的平衡树,它通过暴力重 ...
- ETL流程介绍及常用实现方法
ETL是英文Extract-Transform-Load 的缩写,用来描述将数据从来源端经过抽取(extract).转换(transform).加载(load)至目的端的过程.常见于数据仓库开发中将数 ...
- React 等框架使用 index 做 key 的问题
React 等框架使用 index 做 key 的问题 假如有两个树,一个是之前,一个是更变之后,我们抽象成两种可能性. 插入内容在最后 插入内容在最前 关于插在中间,原理一样,就不阐述. 使用 ul ...
- Android恶意样本数据集汇总
硕士论文的研究方向为Android恶意应用分类,因此花了一点时间去搜集Android恶意样本.其中一部分来自过去论文的公开数据集,一部分来自社区或平台的样本.现做一个汇总,标明了样本或数据集的采集时间 ...
- 【教你玩转云计算】在阿里云一键安装快速部署Oracle11g
云计算时代提供了更方便可靠的IAAS,PAAS和SAAS平台.将已有或正在研发的项目迁移到云计算平台,和传统的服务器部署还是存在一些异同点. 本文手把手教你在阿里云平台快速的部署Oracle11g ...
- apacheTomcat
Window+R ------>cmd || Window PowerShell apacheTomcat\bin> ./startup.sh
- Kruskal算法-HDU1863畅通工程
链接 [http://acm.hdu.edu.cn/showproblem.php?pid=1863] 题意 Problem Description 省政府"畅通工程"的目标是使全 ...