
mysql优化---订单查询优化(2):异步分页处理
订单分页查询:
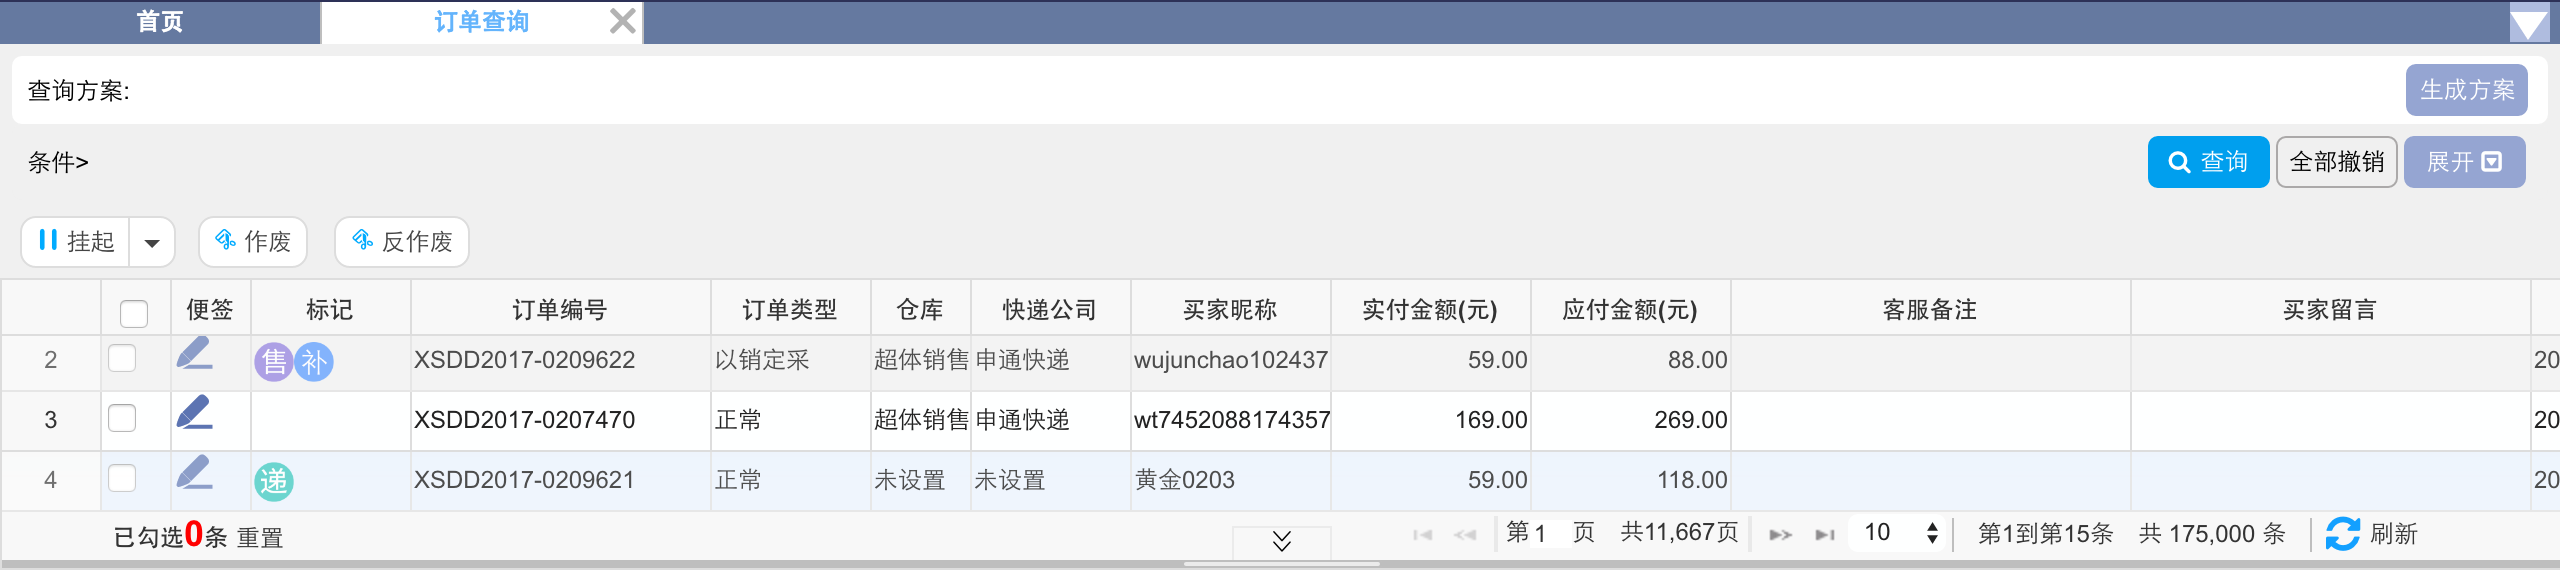
老的代码是顺序执行查询数据和计算总记录数,但是如果条件复杂的话(比如关联子表)查询的时间要超过20s种
    public static PagedList<Map<String, Object>> query(ITemplateService service, Identity tenantId, Identity userId, String entityName,

                                                       Map<String, Object> params, String columns, TCondition cond) {

        int page = WebHelper.getPageNo(params);

        int pageSize = WebHelper.getPageSize(params);

        String orderColumn = (String) params.get(JqgridConstant.ORDER_COLUMN); // 排序字段

        String orderSord = (String) params.get(JqgridConstant.ORDER_METHOD); // 排序方式,desc or asc

        handleOrderByColumn(cond, orderColumn, orderSord);

        int totalCount = service.getBaseService().query4Count(tenantId, entityName, cond);

        List<Map<String, Object>> list = service.query(columns, entityName, cond, tenantId, userId, pageSize, page);

        Translator.prepare(list, tenantId, service); // TODO

        return new PagedList<>(page, pageSize, totalCount, list);

    }
优化方法:
1.通过新启动一个线程来同时做之前需要顺序执行的两个Sql查询,最后等待全部计算完成,统一进行返回
2.对于一些特别复杂的条件的查询,如果内容的条数少于PageSize,那么计算总条数的sql就是不需要执行,可以用返回的list的szie当做总记录数
public static PagedList<Map<String, Object>> queryAsyn(ITemplateService service, Identity tenantId, Identity userId, String entityName,

                                                           Map<String, Object> params, String columns, TCondition cond) {

        int page = WebHelper.getPageNo(params);

        int pageSize = WebHelper.getPageSize(params);

        String orderColumn = (String) params.get(JqgridConstant.ORDER_COLUMN); // 排序字段

        String orderSord = (String) params.get(JqgridConstant.ORDER_METHOD); // 排序方式,desc or asc

        ExecutorService slaver = Executors.newSingleThreadExecutor();

        FutureTask<Integer> totalCountFuture = new FutureTask<>(new TotalCountJob(service, tenantId, entityName, cond));

        slaver.execute(totalCountFuture);

        handleOrderByColumn(cond, orderColumn, orderSord);

        slaver.shutdown();

        //主线程来取数据

        long time1 = System.nanoTime();

        List<Map<String, Object>> list = service.query(columns, entityName, cond, tenantId, userId, pageSize, page);

        long time2 = System.nanoTime();

        long diff = time2 - time1;

        logger.debug("查询方案统计-----查询分页list部分,用时:{}s,条件:{}", translateToSecond(diff), cond);

        Integer totalCount = null;

        int listSize = list.size();

        if (listSize < pageSize) {

            logger.info("本次查询不需要sql进行count操作");

            totalCount = listSize + (page - ) * pageSize;

            slaver.shutdownNow();

        } else {

            try {

                //没做完就等着

                totalCount = totalCountFuture.get();

            } catch (Exception e) {

                totalCountFuture.cancel(true);

                logger.error("totalCount发生异常", e);

            }

        }

        Translator.prepare(list, tenantId, service);

        return new PagedList<>(page, pageSize, totalCount, list);

    }

    private static double translateToSecond(long diff) {

        return diff * 0.000000001;

    }

    static class TotalCountJob implements Callable<Integer> {

        private String tableName;

        private TCondition condition;

        private Identity tenantId;

        private ITemplateService service;

        public TotalCountJob(ITemplateService service, Identity tenantId, String tableName, TCondition condition) {

            this.service = service;

            this.tableName = tableName;

            this.condition = condition;

            this.tenantId = tenantId;

        }

        @Override

        public Integer call() throws Exception {

            long time1 = System.nanoTime();

            Integer totalCount = service.getBaseService().query4Count(tenantId, tableName, condition);

            long time2 = System.nanoTime();

            long diff = time2 - time1;

            logger.debug("查询方案统计-----查询分页count部分,用时:{}s,条件:{}", translateToSecond(diff), condition);

            return totalCount;

        }

    }
这是第一次优化的文章,欢迎访问:
http://www.cnblogs.com/victor2302/p/6073821.html
mysql优化---订单查询优化(2):异步分页处理的更多相关文章
- mysql优化---订单查询优化:异步分页处理
订单分页查询: 老的代码是顺序执行查询数据和计算总记录数,但是如果条件复杂的话(比如关联子表)查询的时间要超过20s种 public static PagedList<Map<String ...
- mysql优化---订单查询优化:视图优化+索引创建
订单的表结构采用了垂直分表的策略,将订单相关的不同模块的字段维护在不同表中 在订单处理这个页面,需要查询各种维度, 因此为了方便查询创建了v_sale_order视图(老版本) drop view v ...
- mysql优化---订单查询优化(1):视图优化+索引创建
订单的表结构采用了垂直分表的策略,将订单相关的不同模块的字段维护在不同表中 在订单处理这个页面,需要查询各种维度, 因此为了方便查询创建了v_sale_order视图(老版本) drop view v ...
- 【mysql优化】大数据量分页优化
limit 翻页原理 limit offset,N, 当offset非常大时, 效率极低, 原因是mysql并不是跳过offset行,然后单取N行, 而是取offset+N行,返回放弃前offset行 ...
- mysql优化之查询优化
Posted by Money Talks on 2012/02/24 | 第一篇 序章第二篇 连接优化第三篇 索引优化第四片 查询优化第五篇 到实战中去 查询优化 查询优化涉及到用户查询数据时使用到 ...
- mysql优化----大数据下的分页,延迟关联,索引与排序的关系,重复索引与冗余索引,索引碎片与维护
理想的索引,高效的索引建立考虑: :查询频繁度(哪几个字段经常查询就加上索引) :区分度要高 :索引长度要小 : 索引尽量能覆盖常用查询字段(如果把所有的列都加上索引,那么索引就会变得很大) : 索引 ...
- MySQL——优化嵌套查询和分页查询
优化嵌套查询 嵌套查询(子查询)可以使用SELECT语句来创建一个单列的查询结果,然后把这个结果作为过滤条件用在另一个查询中.嵌套查询写起来简单,也容易理解.但是,有时候可以被更有效率的连接(JOIN ...
- [MySQL优化案例]系列 — 分页优化
通常,我们会采用ORDER BY LIMIT start, offset 的方式来进行分页查询.例如下面这个SQL: SELECT * FROM `t1` WHERE ftype=1 ORDER BY ...
- MySQL优化 - 性能分析与查询优化(转)
出处: MySQL优化 - 性能分析与查询优化 优化应贯穿整个产品开发周期中,比如编写复杂SQL时查看执行计划,安装MySQL服务器时尽量合理配置(见过太多完全使用默认配置安装的情况),根据应用负载 ...
随机推荐
- Linux环境下虚拟环境virtualenv安装和使用(转)
virtualenv用于创建独立的Python环境,多个Python相互独立,互不影响,它能够: 1. 在没有权限的情况下安装新套件 2. 不同应用可以使用不同的套件版本 3. 套件升级不影响其他应用 ...
- 环形缓存RingBuf的几种实现方式(数组,链表),及Disruptor的分析
先贴个头文件的设计: 首先缓冲区中没有任何数据时,nIdWrite.nIdRead读写下标都为0. 为了判断缓冲区中是否还有数据可读或者可写,我判断的依据是:1)当nIdWrite 等于 nIdRea ...
- 基于lua-nginx-module(openresty)的WEB应用防火墙
独乐乐,不如众乐乐,分享给大家一篇WEB应用防火墙的文章,基于Lua+ Nginx实现.以下是ngx_lua_waf的作者全文输出. Github地址:https://github.com/loves ...
- Java编程思想:内部类基础部分
public class Test { public static void main(String[] args) { // Parcel1.test(); // Parcel2.test(); / ...
- Tomcat CGIServlet enableCmdLineArguments远程代码执行_CVE-2019-0232漏洞复现
Tomcat CGIServlet enableCmdLineArguments远程代码执行_CVE-2019-0232漏洞复现 一.漏洞描述 该漏洞是由于tomcat CGI将命令行参数传递给Win ...
- springBean生命周期----来自spring实战总结
1.Spring对bean进行实例化 2.Spring将值和bean的引用注入到bean对应的属性中(比如说注入到被依赖的bean的方法中或属性里) 3.如果bean实现了BeanNameAware接 ...
- [HDU4135]CO Prime(容斥)
也许更好的阅读体验 \(\mathcal{Description}\) \(t\)组询问,每次询问\(l,r,k\),问\([l,r]\)内有多少数与\(k\)互质 \(0<l<=r< ...
- linux初学者-软件安装与管理篇
linux初学者-软件安装与管理篇 在linux的学习和工作中需要安装许多的软件.在redhat的linux操作系统下,软件一般都是rpm格式的.以下将介绍一些软件安装和管理的内容. 1.软件名称 在 ...
- Dubbo源码学习之-Adaptive自适应扩展
前言 最近三周基本处于9-10-6与9-10-7之间,忙碌的节奏机会丢失了自己.除了之前干施工的那段经历,只看参加软件开发以来,前段时间是最繁忙的了.忙的原因,不是要完成的工作量大,而是各种环境问题, ...
- 第三章 JavaScript操作Dom对象
常用的方法: 1.访问节点: 通过Document.getElementByXXX()获得一个指定节点-->再通过以下属性节点访问节点:第一部分:节点属性a:parentNode 返回节点的父节 ...