
网络爬虫引发的问题及robots协议
一.网络爬虫的尺寸
1.以爬取网页,玩转网页为目的进行小规模,数据量小对爬取速度不敏感的可以使用request库实现功能(占90%)
2.以爬取网站或爬取系列网站为目的,比如说获取一个或多个旅游网站的爬虫,对数据要求规模较大,爬取速度敏感的可以使用Scrapy库
3.以爬取全网为目的,规模很大搜索引擎爬取速度关键,需要定制开发
二.网络爬虫带来的问题
总的来说有:骚扰问题,法律风险,隐私泄露
1.爬虫可利用计算机的快速功能访问服务器,它会比人类的速度快到百倍甚至千倍,受限于编写水平和目的,网络爬虫将会为web服务器带来巨大的资源开销。对网站运行者来讲,爬虫形成了骚扰。
2.网络爬虫会带来法律风险。服务器上的数据有产权归属,比如新浪上的新闻规新浪所有,如果网络爬虫获取数据牟利后将会带来法律风险。
3.网络爬虫会造成隐私泄露。网络爬虫可能具备突破简单访问控制的能力,或得被保护数据从而泄露个人隐私。
三.网络爬虫的限制
来源审查:判断User-Agent进行限制
检查来访HTTP协议头的User-Agent域,只响应浏览器或友好爬虫的访问。
发布公告: Robots协议
告知所有爬虫网站的爬取策略,要求爬虫遵守。
四.Robots协议
作用:网站会告知网络爬虫哪些页面可以抓取,哪些不行
形式:在网站根目录下的robots.txt文件。
下面我自己做了一个实例 打开京东的Robots协议 https://www.jd.com/robots.txt
会出现下面几句话
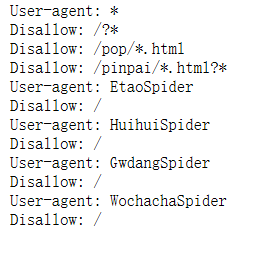
大概的意思是所有爬虫都要遵守以下协定
任何爬虫都不允许访问?* 即?号开头的网页
任何爬虫都不允许访问pop*.html开头的网页
任何爬虫都不允许访问pinpai*.html开头的网页
此外 EtaoSpider HuihuiSpidder GwdangSpider WochachaSpider这四个网络爬虫都不能爬取京东的任何数据
五.Robots协议基本语法
*代表所有 /代表根目录
User-agent: 代表哪些爬虫
Disallow:你不允许访问资源的目录
六.其他注意
1.Robots协议一定放在网站根目录下
2.http://www.news.sina.com.cn/robots.txt和http://www.sina.com.cn/robots.txt它们的Robots协议是不一样的
3.如果一个网站没有Robots协议,是允许所有爬虫无限制爬取
网络爬虫引发的问题及robots协议的更多相关文章
- 网络爬虫与web之间的访问授权协议——Robots
网站的管理者们通常会有这样一种心态:一方面期待百度.Google这样的搜索引擎来抓取网站的内容,另一方面又很厌恶其他来路不明的网络爬虫抓取自己的信息.正是因为这样,才有“好爬虫”.“坏爬虫”这样的说法 ...
- Linux企业级项目实践之网络爬虫(29)——遵守robots.txt
Robots协议(也称为爬虫协议.机器人协议等)的全称是"网络爬虫排除标准"(Robots Exclusion Protocol),网站通过Robots协议告诉搜索引擎哪些页面可以 ...
- Python 网络爬虫 010 (高级功能) 解析 robots.txt 文件
解析 robots.txt 文件 使用的系统:Windows 10 64位 Python 语言版本:Python 2.7.10 V 使用的编程 Python 的集成开发环境:PyCharm 2016 ...
- 02.python网络爬虫第二弹(http和https协议)
一.HTTP协议 1.官方概念: HTTP协议是 Hyper Text Transfer Protocol(超文本传输协议)的缩写,是用于从万维网(www.world wide web) 服务器传输超 ...
- [python爬虫]Requests-BeautifulSoup-Re库方案--robots协议与Requests库实战
[根据北京理工大学嵩天老师“Python网络爬虫与信息提取”慕课课程编写 慕课链接:https://www.icourse163.org/learn/BIT-1001870001?tid=100223 ...
- Robots协议(爬虫协议、机器人协议)
Robots协议(也称为爬虫协议.机器人协议等)的全称是“网络爬虫排除标准”(Robots Exclusion Protocol),网站通过Robots协议告诉搜索引擎哪些页面可以抓取,哪些页面不能抓 ...
- Python网络爬虫与信息提取(一)
学习 北京理工大学 嵩天 课程笔记 课程体系结构: 1.Requests框架:自动爬取HTML页面与自动网络请求提交 2.robots.txt:网络爬虫排除标准 3.BeautifulSoup框架:解 ...
- Python网络爬虫入门篇
1. 预备知识 学习者需要预先掌握Python的数字类型.字符串类型.分支.循环.函数.列表类型.字典类型.文件和第三方库使用等概念和编程方法. 2. Python爬虫基本流程 a. 发送请求 使用 ...
- Python网络爬虫与信息提取笔记
直接复制粘贴笔记发现有问题 文档下载地址//download.csdn.net/download/hide_on_rush/12266493 掌握定向网络数据爬取和网页解析的基本能力常用的 Pytho ...
随机推荐
- Java基础部分(11~20)
11."=="和 equals 方法究竟有什么区别? (单独把一个东西说清楚,然后再说清楚另一个,这样,它们的区别自然就出来了,混在一起说,则很难说清楚) ==操作符专门用来比较两 ...
- Codeforces Round #451 (Div. 2) A B C D E
Codeforces Round #451 (Div. 2) A Rounding 题目链接: http://codeforces.com/contest/898/problem/A 思路: 小于等于 ...
- DateTime格式转换部分介绍
DateTime与字符串转换: DateTime()与转换为字符串主要依靠DateTime().ToString(string format) 函数,以我的理解,参数format大体分为单个字母和多个 ...
- MySql数据库之单表数据查询
查询数据 1.查询所有数据: select * from 表名; 2.根据指定条件查询数据:
- Python超简单的爬取网站中图片
1.首先导入相关库 import requests import bs4 import threading #用于多线程爬虫,爬取速度快,可以完成多页爬取 import os 2.使用bs4获取htm ...
- 商品类目和商品大广告的Redis缓存
(dubbo)主要的实现类: 商品类目的Redis缓存 com.bjsxt.ego.portal.service.impl.PortalItemCatServiceImpl package com.b ...
- Python爬虫根据关键词爬取知网论文摘要并保存到数据库中【入门必学】
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:崩坏的芝麻 由于实验室需要一些语料做研究,语料要求是知网上的论文摘要 ...
- 【ZooKeeper系列】1.ZooKeeper单机版、伪集群和集群环境搭建
ZooKeeper安装模式主要有3种: 单机版(Standalone模式)模式:仅有一个ZooKeeper服务 伪集群模式:单机多个ZooKeeper服务 集群模式:多机多ZooKeeper服务 1 ...
- InputStream 读取中文乱码 扩展
对于InputStream读取中文乱码,下面这段话给出了很好的解释,以及后续编码上的扩展. BufferedInputStream和BufferedOutputStream是过滤流,需要使用已存在的节 ...
- NIO Buffer 内部机理使用姿势
关于NIO Buffer中4个重要状态属性 position.limit.capacity 与 mark Buffer本身是一个容器,称作缓冲区,里面包装了特定的一种原生类型,其子类包括ByteBuf ...