
二叉查找树的实现与讲解(C++)
注:这篇文章源于:https://mp.csdn.net/postedit/99710904, 无需怀疑抄袭,同一个作者,这是我在博客园的账号。
在二叉树中,有两种非常重要的条件,分别是两类数据结构的基础性质。 其一是“堆性质”,二叉堆以及高级数据结构中的所有可合并堆都满足“堆 性质”。 其二是 “BST性质”,它是二叉查找树(Binary Search Tree)以及所有平衡树的基础。
二叉查找树的定义
给定一棵二叉树,树上的每个节点都带有一个数值,成为节点的 “关键码” 。所谓BST性质是指,对于树中的任意一个节点:
·该节点的关键码不小于它的左子树(如果非空)中任意节点的关键码
·该节点的关键码不大于它的右子树(如果非空)中任意节点的关键码 满足上述性质的二叉树就是一棵“二叉查找树”(BST)。 二叉查找树的中序遍历是一个关键码单调递增的节点序列。
二叉查找树的存储
用数组模拟二叉树
 struct node {

     int l, r;//左右子节点在数组中的下标

     int val;//节点关键码

 }tree[Size];//数组模拟链表

 int tot;//使用过和正在使用的节点总数量

 int root;//当前根节点编号,即数组下标

优点:编程复杂度低。不需要考虑分配内存和回收内存
缺点:内存利用率低
用指针表示二叉树
 struct node {

     node *l, *r; //指向左右儿子

     int val;//节点关键码

 }root;
优点:内存利用率高
缺点:编程复杂度高
二叉查找树的操作
BST支持的操作:
• 树的建立
• 插入关键码为x的节点
• 查询关键码为x的节点的排名
• 求关键码为x的节点的前驱
• 求关键码为x的节点的后继
• 删除关键码为x的节点
二叉查找树的建立
为了避免越界,减少边界情况的特殊判断,编程实现时一般在 BST中额外插入一个关键码为正无穷和一个关键码为负无穷的节点。 仅由这两个节点构成的BST就是一棵初始的空BST。
int New(int val) {

    a[++tot].val = val;

    return tot;

}

void Build() {

    New(-INF), New(INF);

    root = , a[].r = ;

}
二叉查找树的检索
在BST中检索是否存在关键码为val的节点。 设变量p等于根节点root,执行以下过程:
1.若p的关键码等于val,则已经找到
2.若p的关键码大于val
a.若p的左子节点为空,则说明不存在val
b.若p的左子节点不空,在p的左子树中递归进行检索
3.若瀃的关键码小于val
a.若p的右子节点为空,则说明不存在val
b.若p的右子节点不空,在p的右子树中递归进行检索
在如下BST中:
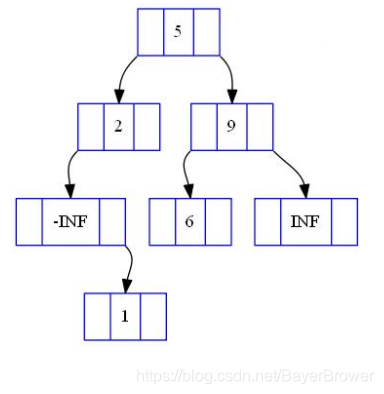
查找6:
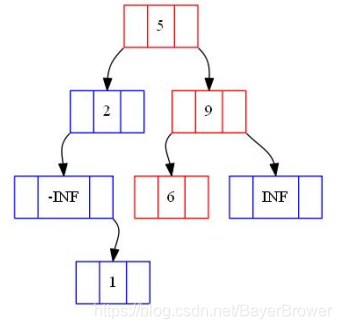
查找3:

 int Get(int p, int val) {

     if (p == ) return ; //检索失败

     if (val == a[p].val) return p; //检索成功

     if (val < a[p].val) return Get(a[p].l, val); //递归检索左子树

     else return Get(a[p].r, val);//递归检索右子树

 }
二叉查找树的插入
在BST中插入一个新的值val(假设目前BST中不存在关键码为val的节点, 若存在则不插入),与BST的检索过程类似。
在发现要走向的p的子节点为空,说明val不存在时,直接建立关键码为 val的新节点作为p的子节点。
 void Insert(int &p, int val) {

     if (p == ) {

         p = new(val); //p是引用,其父节点的l或r值会被同时更新

         return;

     }

     if (val == a[p].val) return;

     if (val < a[p].val) Insert(a[p].l, val);

     else Insert(a[p].r, val);

 }
二叉查找树找后继
在BST中, val 的后继指的是在关键码大于 val 的前提下,关键码最小的节点。
初始化val为具有正无穷关键码的那个节点的编号(编号为2)。然后,从根节点开始在BST中检索val。在检索的过程中,每经过一个节点,都检查该节点的关键码,判断能否更新所求的后继val。
检索完成后,有三种可能的结果:
1.没有找到val此时val的后继就在已经经过的节点中,val即为所求。
2.找到了关键码为val的节点p,但p没有右子树与上一种情况相同,val即为所求
3.找到了关键码为val的节点p,且p有右子树从p的右子节点出发,一直向左走,就找到了val的后继
 int GetNext(int val) {

     int ans = ;

     int p = root;

     while (p) {

         if (val == a[p].val) {

             if (a[p].r > ) {

                 p = a[p].r;

                 while (a[p].l > ) p = a[p].l;

                 ans = p;

             }

             break;

         }

         if (a[p].val > val && a[p].val < a[ans].val) ans = p;

         p = val < a[p].val ? a[p].l : a[p].r;

     }

     return a[ans].val;

 }
二叉查找树找前驱
 int GetPre(int val) {

     int ans = ;

     int p = root;

     while (p) {

         if (val == a[p].val) {

             if (a[p].l > ) {

                 p = a[p].l;

                 while (a[p].r > ) p = a[p].r;

                 ans = p;

             }

             break;

         }

         if (a[p].val < val && a[p].val > a[ans].val) ans = p;

         p = val < a[p].val ? a[p].l : a[p].r;

     }

     return a[ans].val;

 }
二叉查找树的删除
从BST中删除关键码为val的节点 首先,在BST中检索val,得到节点p 若p的子节点个数小于2,则直接删除p,并令p的子节点代替p的位置,与p 的父节点相连。 若p既有左子树又有右子树,则在BST中求出val的后继节点next。因为next 没有左子树,所以可以直接删除nest,并令next的右子树代替nest的位置。最后, 再让next节点代替p节点,删除p即可。
 void Remove(int val) {

     //检索val, 得到节点p

     int &p = root;

     while (p) {

         if(val == a[p].val) break;

         p = val < a[p].val ? a[p].l : a[p].r;

     }

     if (p == ) return;//结点不存在

     if (a[p].l == ) //没有左子树

         p = a[p].r; //右子树代替p的位置,p是引用

     else if (a[p].r == ) //没有右子树

         p = a[p].l; //左子树代替p的位置,p是引用

     else { //求后继

         int next = a[p].r;

         while (a[next].l > ) next = a[next].l;

         Remove(a[next].val); //next一定没有左子树,直接删除

         a[next].l = a[p].l, a[next].r = a[p].r; //节点next代替p的位置

         p = next;

     }

 }
二叉查找树的性能分析
在随机数据中,BST一次操作的期望复杂度是O(log n)。然而, BST很容易退化,例如在BST中依此插入一个有序序列,将会得到一条 链,平均每次操作的复杂度都为O(n)。 这样的左右子树大小相差很大的BST是不平衡的。有很多种方法可 以维持BST的平衡,从而产生了各种平衡树。
THE END
二叉查找树的实现与讲解(C++)的更多相关文章
- 二叉查找树(一)之 图文解析 和 C语言的实现
概要 本章先对二叉树的相关理论知识进行介绍,然后给出C语言的详细实现.关于二叉树的学习,需要说明的是:它并不难,不仅不难,而且它非常简单.初次接触树的时候,我也觉得它似乎很难:而之所产生这种感觉主要是 ...
- 二叉查找树(二)之 C++的实现
概要 上一章介绍了"二叉查找树的相关理论知识,并通过C语言实现了二叉查找树".这一章给出二叉查找树的C++版本.这里不再对树的相关概念进行介绍,若遇到不明白的概念,可以在上一章查找 ...
- 二叉查找树(三)之 Java的实现
概要 在前面分别介绍了"二叉查找树的相关理论知识,然后给出了二叉查找树的C和C++实现版本".这一章写一写二叉查找树的Java实现版本. 目录 1. 二叉树查找树2. 二叉查找树的 ...
- 浅谈算法和数据结构: 七 二叉查找树 八 平衡查找树之2-3树 九 平衡查找树之红黑树 十 平衡查找树之B树
http://www.cnblogs.com/yangecnu/p/Introduce-Binary-Search-Tree.html 前文介绍了符号表的两种实现,无序链表和有序数组,无序链表在插入的 ...
- C 关于二叉查找树的回顾,并简述结构接口设计
前言 最经想改写C用的配置读取接口, 准备采用hash或二叉树提到原先用的链表,提高查找效率.就回顾一下二叉树,这里分享一下二叉查找树,代码很精简的, 适合学习运用二叉树查找. 需要基础 1.具备C ...
- 二叉查找树的查找、插入和删除 - Java实现
http://www.cnblogs.com/yangecnu/p/Introduce-Binary-Search-Tree.html 作者: yangecnu(yangecnu's Blog on ...
- AVL树(平衡二叉查找树)
首先要说AVL树,我们就必须先说二叉查找树,先介绍二叉查找树的一些特性,然后我们再来说平衡树的一些特性,结合这些特性,然后来介绍AVL树. 一.二叉查找树 1.二叉树查找树的相关特征定义 二叉树查找树 ...
- 【算法】二叉查找树实现字典API
参考资料 <算法(java)> — — Robert Sedgewick, Kevin Wayne <数据结构> ...
- 二叉查找树之 Java的实现
参考:http://www.cnblogs.com/skywang12345/p/3576452.html 二叉查找树简介 二叉查找树(Binary Search Tree),又被称为二叉搜索树.它是 ...
随机推荐
- Linux 部署MySQL 一主一从一备
主服务器搭建 准备三台服务器,一主一从一备 在主服务器(master)下找到mysql配置文件. Window下为my.ini(一般在C:\ProgramData\MySQL\MySQL Server ...
- strlen函数 (求字符串长度函数)
strlen函数原型在<string.h>中 #include <stdio.h> #include <string.h> int main(){ char *p= ...
- Linux使用之centos下安装Java环境并运行Java程序
前言 在Java中所有的程序都是在JVM上运行的.Java虚拟机(JVM)读取并处理经过编译的与平台无关的*.class文件.因为Java语言源程序编写后,先使用Java伪编译器进行伪编译,将其转换为 ...
- #w30 2019年大前端技术周刊
本周是2019年第30周 会议 2019年ArchSummit全球架构师峰会 2019年7月在深圳举行了ArchSummit全球架构师峰会,里面有不少关于大前端的主题可以关注. 从0到1,移动政务应用 ...
- 如何获取JVM堆转储文件
堆转储是诊断与内存相关的问题(例如内存泄漏缓慢,垃圾回收问题和 java.lang.OutOfMemoryError.它们也是优化内存消耗的重要工具. 有很多很不错的的工具,例如Eclipse MAT ...
- 【ZJOI 2014】力
Problem Description 给出 \(n\) 个数 \(q_i\),给出 \(F_j\) 的定义如下: \[F_j=\sum_{i<j} \frac{q_iq_j}{(i-j)^2} ...
- SpringCloud的入门学习之深入理解Eureka注册中心
1.Eureka 注册中心三种角色. 答:a.Eureka Server,注册中心,通过 Register.Get.Renew 等接口提供服务的注册和发现. b.Application Service ...
- 为Bootstrap Modal(模态框)全局添加拖拽操作
在js中绑定方法 $(document).on("show.bs.modal", ".modal", function(){ $(this).draggable ...
- Python中使用cutecharts实现简单的手绘风格的图表
场景 效果 cutecharts的Github: https://github.com/chenjiandongx/cutecharts 注: 博客: https://blog.csdn.net/ba ...
- PHP mysqli_fetch_object MySQLi 函数
定义和用法 mysqli_fetch_object - 返回结果集的当前行作为对象 版本支持 PHP4 PHP5 PHP7 不支持 支持 支持 语法 mysqli_fetch_object ( mys ...