
MNIST手写数字识别 Tensorflow实现
def conv2d(x, W):

  return tf.nn.conv2d(x, W, strides=[1, 1, 1, 1], padding='SAME')
1. strides在官方定义中是一个一维具有四个元素的张量,其规定前后必须为1,所以我们可以改的是中间两个数,中间两个数分别代表了水平滑动和垂直滑动步长值。
在卷积核移动逐渐扫描整体图时候,因为步长的设置问题,可能导致剩下未扫描的空间不足以提供给卷积核的,大小扫描 比如有图大小为5*5,卷积核为2*2,步长为2,卷积核扫描了两次后,剩下一个元素,不够卷积核扫描了,这个时候就在后面补零,补完后满足卷积核的扫描,这种方式就是same。如果说把刚才不足以扫描的元素位置抛弃掉,就是valid方式。
如果padding = ‘VALID’ ,卷积后的特征图长和宽计算公式如下:
new_height = new_width = (W – F + 1) / S (结果向上取整)
如果padding = ‘SAME’
new_height = new_width = W / S (结果向上取整)
2 tf.nn.conv2d 和 tf.layers.conv2d 的区别
padding='valid', data_format='channels_last',
dilation_rate=(1,1), activation=None,
use_bias=True, kernel_initializer=None,
bias_initializer=init_ops.zeros_initializer(),
kernel_regularizer=None,
bias_regularizer=None,
activity_regularizer=None, trainable=True,
name=None, reuse=None)
这个层创建了一个卷积核,将输入进行卷积来输出一个 tensor。如果 use_bias 是 True(且提供了 bias_initializer),则一个偏差向量会被加到输出中。最后,如果 activation 不是 None,激活函数也会被应用到输出中。
inputs:Tensor 输入
filters:整数,表示输出空间的维数(即卷积过滤器的数量)
kernel_size:一个整数,或者包含了两个整数的元组/队列,表示卷积窗的高和宽。如果是一个整数,则宽高相等。
strides:一个整数,或者包含了两个整数的元组/队列,表示卷积的纵向和横向的步长。如果是一个整数,则横纵步长相等。另外, strides 不等于1 和 dilation_rate 不等于1 这两种情况不能同时存在。
padding:"valid" 或者 "same"(不区分大小写)。"valid" 表示不够卷积核大小的块就丢弃,"same"表示不够卷积核大小的块就补0。
"valid" 的输出形状为
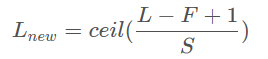
"same" 的输出形状为
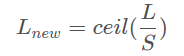
其中,L 为输入的 size(高或宽),F为 filter 的 size,S 为 strides 的大小,ceil()为向上取整。
data_format:channels_last 或者 channels_first,表示输入维度的排序。

dilation_rate:一个整数,或者包含了两个整数的元组/队列,表示使用扩张卷积时的扩张率。如果是一个整数,则所有方向的扩张率相等。另外, strides 不等于1 和 dilation_rate 不等于1 这两种情况不能同时存在。
activation:激活函数。如果是None则为线性函数。
use_bias:Boolean类型,表示是否使用偏差向量。
kernel_initializer:卷积核的初始化。
bias_initializer:偏差向量的初始化。如果是None,则使用默认的初始值。
kernel_regularizer:卷积核的正则项
bias_regularizer:偏差向量的正则项
activity_regularizer:输出的正则函数
kernel_constraint:映射函数,当核被Optimizer更新后应用到核上。Optimizer 用来实现对权重矩阵的范数约束或者值约束。映射函数必须将未被影射的变量作为输入,且一定输出映射后的变量(有相同的大小)。做异步的分布式训练时,使用约束可能是不安全的。
bias_constraint:映射函数,当偏差向量被Optimizer更新后应用到偏差向量上。
trainable:Boolean类型。
name:字符串,层的名字。
reuse:Boolean类型,表示是否可以重复使用具有相同名字的前一层的权重。
##返回值
输出 Tensor
##异常抛出
ValueError:if eager execution is enabled.
一个参数要注意一下:
filter: 是一个4维张量,其type必须和输入一样,
[filter_height, filter_width, in_channels, out_channels]
tf.nn.conv2d,一般在下载预训练好的模型时使用。
from tensorflow.examples.tutorials.mnist import input_data

import tensorflow as tf

#加载数据集

mnist = input_data.read_data_sets('MNIST_data', one_hot=True)

#以交互式方式启动session

#如果不使用交互式session,则在启动session前必须

# 构建整个计算图,才能启动该计算图

sess = tf.InteractiveSession()

"""构建计算图"""

#通过占位符来为输入图像和目标输出类别创建节点

#shape参数是可选的,有了它tensorflow可以自动捕获维度不一致导致的错误

x = tf.placeholder("float", shape=[None, 784]) #原始输入

y_ = tf.placeholder("float", shape=[None, 10]) #目标值

#为了不在建立模型的时候反复做初始化操作,

# 我们定义两个函数用于初始化

def weight_variable(shape):

    #截尾正态分布,stddev是正态分布的标准偏差

    initial = tf.truncated_normal(shape=shape, stddev=0.1)

    return tf.Variable(initial)

def bias_variable(shape):

    initial = tf.constant(0.1, shape=shape)

    return tf.Variable(initial)

#卷积核池化,步长为1,0边距

def conv2d(x, W):

    return tf.nn.conv2d(x, W, strides=[1, 1, 1, 1], padding='SAME')

def max_pool_2x2(x):

    return tf.nn.max_pool(x, ksize=[1, 2, 2, 1],

                          strides=[1, 2, 2, 1], padding='SAME')

"""第一层卷积"""

#由一个卷积和一个最大池化组成。滤波器5x5中算出32个特征,是因为使用32个滤波器进行卷积

#卷积的权重张量形状是[5, 5, 1, 32],1是输入通道的个数,32是输出通道个数

W_conv1 = weight_variable([5, 5, 1, 32])

#每一个输出通道都有一个偏置量

b_conv1 = bias_variable([32])

#位了使用卷积,必须将输入转换成4维向量,2、3维表示图片的宽、高

#最后一维表示图片的颜色通道(因为是灰度图像所以通道数维1,RGB图像通道数为3)

x_image = tf.reshape(x, [-1, 28, 28, 1])

#第一层的卷积结果,使用Relu作为激活函数

h_conv1 = tf.nn.relu(conv2d(x_image, W_conv1))

#第一层卷积后的池化结果

h_pool1 = max_pool_2x2(h_conv1)

"""第二层卷积"""

W_conv2 = weight_variable([5, 5, 32, 64])

b_conv2 = bias_variable([64])

h_conv2 = tf.nn.relu(conv2d(h_pool1, W_conv2) + b_conv2)

h_pool2 = max_pool_2x2(h_conv2)

"""全连接层"""

#图片尺寸减小到7*7,加入一个有1024个神经元的全连接层

W_fc1 = weight_variable([7*7*64, 1024])

b_fc1 = bias_variable([1024])

#将最后的池化层输出张量reshape成一维向量

h_pool2_flat = tf.reshape(h_pool2, [-1, 7*7*64])

#全连接层的输出

h_fc1 = tf.nn.relu(tf.matmul(h_pool2_flat, W_fc1) + b_fc1)

"""使用Dropout减少过拟合"""

#使用placeholder占位符来表示神经元的输出在dropout中保持不变的概率

#在训练的过程中启用dropout,在测试过程中关闭dropout

keep_prob = tf.placeholder("float")

h_fc1_drop = tf.nn.dropout(h_fc1, keep_prob)

"""输出层"""

W_fc2 = weight_variable([1024, 10])

b_fc2 = bias_variable([10])

#模型预测输出

y_conv = tf.nn.softmax(tf.matmul(h_fc1_drop, W_fc2) + b_fc2)

#交叉熵损失

cross_entropy = -tf.reduce_sum(y_ * tf.log(y_conv))

#模型训练,使用AdamOptimizer来做梯度最速下降

train_step = tf.train.AdamOptimizer(1e-4).minimize(cross_entropy)

#正确预测,得到True或False的List

correct_prediction = tf.equal(tf.argmax(y_, 1), tf.argmax(y_conv, 1))

#将布尔值转化成浮点数,取平均值作为精确度

accuracy = tf.reduce_mean(tf.cast(correct_prediction, "float"))

#在session中先初始化变量才能在session中调用

sess.run(tf.initialize_all_variables())

#迭代优化模型

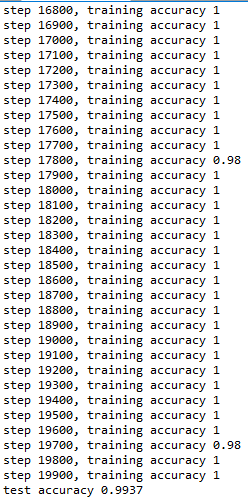
for i in range(20000):

    #每次取50个样本进行训练

    batch = mnist.train.next_batch(50)

    if i%100 == 0:

        train_accuracy = accuracy.eval(feed_dict={

            x: batch[0], y_:batch[1], keep_prob:1.0}) #模型中间不使用dropout

        print("step %d, training accuracy %g" % (i, train_accuracy))

    train_step.run(feed_dict={x:batch[0], y_:batch[1], keep_prob:0.5})

print("test accuracy %g" % accuracy.eval(feed_dict={

            x:mnist.test.images, y_:mnist.test.labels, keep_prob:1.0}))
1、启动session
(1)交互方式启动session
sess = tf.InteractiveSession()
(2)一般方式启动session
sess = tf.Session()
ps: 使用交互方式不用提前构建计算图,而使用一般方式必须提前构建好计算图才能启动session
2、权重和偏置初始化
权重初始化的原则:应该加入少量的噪声来打破对称性并且要避免0梯度(初始化为0)
权重初始化一般选择均匀分布或是正态分布
定义权重初始化方法:
def weight_variable(shape):
#截尾正态分布,stddev是正态分布的标准偏差
initial = tf.truncated_normal(shape=shape, stddev=0.1)
return tf.Variable(initial)
定义偏置初始化方法:
def bias_variable(shape):
initial = tf.constant(0.1, shape=shape)
return tf.Variable(initial)
3. Tensorflow 将list转换为Tensor

两种方法:
tf.convert_to_tensor([np.nan, 1, 1, 64])
tf.TensorShape([None, 1, 1, 64])
这两种方法我都试过,第二种好用。
MNIST手写数字识别 Tensorflow实现的更多相关文章
- Mnist手写数字识别 Tensorflow
Mnist手写数字识别 Tensorflow 任务目标 了解mnist数据集 搭建和测试模型 编辑环境 操作系统:Win10 python版本:3.6 集成开发环境:pycharm tensorflo ...
- Android+TensorFlow+CNN+MNIST 手写数字识别实现
Android+TensorFlow+CNN+MNIST 手写数字识别实现 SkySeraph 2018 Email:skyseraph00#163.com 更多精彩请直接访问SkySeraph个人站 ...
- 基于tensorflow的MNIST手写数字识别(二)--入门篇
http://www.jianshu.com/p/4195577585e6 基于tensorflow的MNIST手写字识别(一)--白话卷积神经网络模型 基于tensorflow的MNIST手写数字识 ...
- Tensorflow之MNIST手写数字识别:分类问题(1)
一.MNIST数据集读取 one hot 独热编码独热编码是一种稀疏向量,其中:一个向量设为1,其他元素均设为0.独热编码常用于表示拥有有限个可能值的字符串或标识符优点: 1.将离散特征的取值扩展 ...
- TensorFlow——MNIST手写数字识别
MNIST手写数字识别 MNIST数据集介绍和下载:http://yann.lecun.com/exdb/mnist/ 一.数据集介绍: MNIST是一个入门级的计算机视觉数据集 下载下来的数据集 ...
- 基于TensorFlow的MNIST手写数字识别-初级
一:MNIST数据集 下载地址 MNIST是一个包含很多手写数字图片的数据集,一共4个二进制压缩文件 分别是test set images,test set labels,training se ...
- Tensorflow实现MNIST手写数字识别
之前我们讲了神经网络的起源.单层神经网络.多层神经网络的搭建过程.搭建时要注意到的具体问题.以及解决这些问题的具体方法.本文将通过一个经典的案例:MNIST手写数字识别,以代码的形式来为大家梳理一遍神 ...
- mnist手写数字识别——深度学习入门项目(tensorflow+keras+Sequential模型)
前言 今天记录一下深度学习的另外一个入门项目——<mnist数据集手写数字识别>,这是一个入门必备的学习案例,主要使用了tensorflow下的keras网络结构的Sequential模型 ...
- mnist 手写数字识别
mnist 手写数字识别三大步骤 1.定义分类模型2.训练模型3.评价模型 import tensorflow as tfimport input_datamnist = input_data.rea ...
随机推荐
- 从iOS 11看怎样设计APP图标
苹果WWDC2017开发者大会已经尘埃落定,除了新产品的发布,iOS 11也正式亮相.新系统中,地图.App Store.时钟.相机.联系人等等原生应用都换了新的图标.此次图标的变化势必也会激发下一个 ...
- Java程序设计9——泛型
泛型是对集合的补充,JDK1.5增加泛型支持很大程度上都是为了让集合能记住其元素的数据类型.在没有泛型之前,一旦把一个对象丢进Java集合中,集合就会忘记对象的类型,把所有的对象都当成Object类型 ...
- iOS密码输入框的实现
[iOS密码输入框的实现] 就是一个UITextField,把属性 UITextField.secureTextEntry设置为Yes即可.此种UI效果为iOS默认效果.
- 声音处理(Cool Edit)
平直化处理 上升半音
- 测试用数据库表设计和SessionFactory
本篇为struts-2.5.2和spring-3.2.0以及hibernate-4.2.21的整合开篇. 一.测试的数据库表. 用户.角色和权限关系表.数据库是Mysql5.6.为了考虑到一些特殊数据 ...
- Linux 基础教程 33-硬盘分区及挂载
挂载命令 在Windows系统中如果插入了U盘.移动硬盘.光驱等,只要能被Windows系统识别出来,则系统会进行自动挂载并添加盘符,然后我们就可以访问,而这一切均由系统完成,用户并不需要做任 ...
- .NET 匿名方法的BUG,请专家解答
匿名方法是.NET 3.5之后的一个好东东,很多人使用,但是我在最近的工作当中发现了一个问题. 请专家解答 //list里存放10个数字 List<); ; i < ; i++) { li ...
- MSP430 G2553 低功耗模式LPMx
MSP430除了正常运行时的active模式外,还支持五种低功耗模式(Low-power mode),分别为LPM0.LPM1.LPM2.LPM3.LPM4,由状态寄存器中的CPUOFF.OSCOFF ...
- C# defualt关键字默认值用法
默认值表达式生成类型的默认值. 默认值表达式在泛型类和泛型方法中非常有用. 使用泛型类和泛型方法时出现的一个问题是,如何在无法提前知道以下内容的情况下将默认值赋值给参数化类型 T: T 是引用类型还是 ...
- linux命令之用户管理及用户信息查询命令(下)
1.visudo:编辑sudoers文件 该命令专门用来编辑/etc/sudoers文件,同时提供语法检查等功能. 示例: 1)执行visudo对普通用户授权 [root@boxiaoyuan ~]# ...