
Python——爬虫学习2
BeautifulSoup插件的使用
这个插件需要先使用pip安装(在上一篇中不再赘言),然后再程序中申明引用
from bs4 import BeautifulSoup

html=self.requests(url)#调用requests函数把套图地址传入会返回一个response

all_a=BeautifulSoup(html.text,'lxml').find('div',class_='all').find('li').find_all('a')
这里find方法只会查找第一个匹配的元素,所以返回的是一个对象,find_all方法会查找所有匹配的元素,所以返回的是list
在使用网页文本的时候用text,在下载多媒体文件的时候用content。
正式编程
这里对程序进行了一些封装,方便函数的复用
ps:不得不感叹,python的io操作真的是很好用,简单方便,敲几下键盘就搞定,比起C#的各种参数真是太简洁!!!
import requests

from bs4 import BeautifulSoup

import os

class mzitu():

    def __init__(self):

        self.headers={'User-Agent':'Mozilla/5.0(Windows NT 6.2;WOW64)AppleWebKit/535.24(KHTML,like Gecko)Chrome/19.0.1055.1 Safari/535.24'}

        #self.route="D:\GITHUB\学习Python\爬虫基础教程mzitu\mzitu"

    def all_url(self,url):

        html=self.requests(url)#调用requests函数把套图地址传入会返回一个response

        all_a=BeautifulSoup(html.text,'lxml').find('div',class_='all').find('li').find_all('a')

        for a in all_a:

            title=a.get_text()

            print(u'开始保存:',title)#加一点提示,不然太枯燥了

            path=str(title).replace("?",'_')

            path = str(title).replace("?", '_') ##我注意到有个标题带有 ?  这个符号Windows系统是不能创建文件夹的所以要替换掉

            if self.mkdir(path):#调用mkdir函数创建文件夹

                href=a['href']

                self.html(href)#调用html函数把href参数传递过去

        print(u'共找到资源:',len(all_a),u'组')

    def html(self,href): ##这个函数是处理套图地址获得图片的页面地址

        html=self.requests(href)#调用requests函数

        self.headers['referer']=href

        max_span=BeautifulSoup(html.text,'lxml').find('div',class_='pagenavi').find_all('span')[-2].get_text()

        for page in range(1,int(max_span)+1):

            page_url=href+'/'+str(page)

            self.img(page_url)#调用img函数

    def img(self,page_url): ##这个函数处理图片页面地址获得图片的实际地址

        img_html=self.requests(page_url)

        img_url=BeautifulSoup(img_html.text,'lxml').find('div',class_='main-image').find('img')['src']

        self.save(img_url)#调用save函数

    def save(self,img_url): ##这个函数保存图片

        name=img_url[-9:-4]

        img=self.requests(img_url)

        f=open(name+'.jpg','ab')

        f.write(img.content)

        f.close()

    def mkdir(self,path): ##这个函数创建文件夹

        path=path.strip()

        isExists=os.path.exists(os.path.join("D:\GITHUB\学习Python\爬虫基础教程mzitu\mzitu",path))#创建一个存放套图的文件夹

        if not isExists:

            print(u'创建了',path,u'文件夹!')

            os.makedirs(os.path.join("D:\GITHUB\学习Python\爬虫基础教程mzitu\mzitu",path))

            os.chdir(os.path.join("D:\GITHUB\学习Python\爬虫基础教程mzitu\mzitu",path))#切换到目录

            return True

        else:

            print(u'名字叫做',path,u'的文件夹已经存在了!')

            return False

    def requests(self,url): ##这个函数获取网页的response 然后返回

        content=requests.get(url,headers=self.headers)

        return content

Mzitu=mzitu()#实例化

Mzitu.all_url('http://www.mzitu.com/all')##给函数all_url传入参数 当作启动爬虫(就是入口)
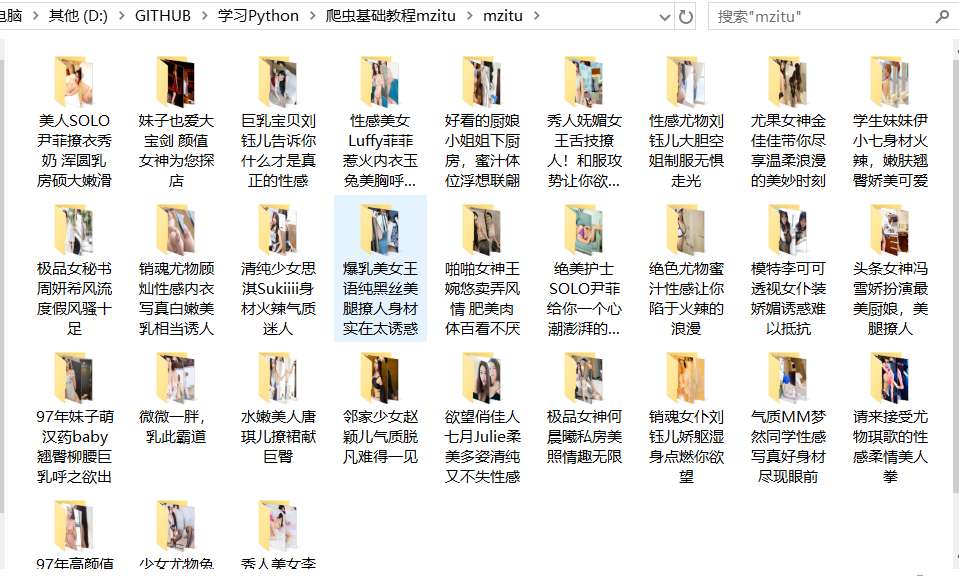
运行脚本,下载后到文件夹去看看,效果很惊艳!
Python——爬虫学习2的更多相关文章
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
- python爬虫学习 —— 总目录
开篇 作为一个C党,接触python之后学习了爬虫. 和AC算法题的快感类似,从网络上爬取各种数据也很有意思. 准备写一系列文章,整理一下学习历程,也给后来者提供一点便利. 我是目录 听说你叫爬虫 - ...
- Python爬虫学习:三、爬虫的基本操作流程
本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:三.爬虫的基本操作与流程 一般我们使用Python爬虫都是希望实现一套完整的功能,如下: 1.爬虫目标数据.信息: 2.将 ...
- Python爬虫学习:四、headers和data的获取
之前在学习爬虫时,偶尔会遇到一些问题是有些网站需要登录后才能爬取内容,有的网站会识别是否是由浏览器发出的请求. 一.headers的获取 就以博客园的首页为例:http://www.cnblogs.c ...
- Python爬虫学习:二、爬虫的初步尝试
我使用的编辑器是IDLE,版本为Python2.7.11,Windows平台. 本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:二.爬虫的初步尝试 1.尝试抓取指定网页 ...
- 《Python爬虫学习系列教程》学习笔记
http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多.学习过程中我把一些学习的笔记总结下来,还记录了一些自己 ...
- python爬虫学习视频资料免费送,用起来非常666
当我们浏览网页的时候,经常会看到像下面这些好看的图片,你是否想把这些图片保存下载下来. 我们最常规的做法就是通过鼠标右键,选择另存为.但有些图片点击鼠标右键的时候并没有另存为选项,或者你可以通过截图工 ...
- python爬虫学习笔记(一)——环境配置(windows系统)
在进行python爬虫学习前,需要进行如下准备工作: python3+pip官方配置 1.Anaconda(推荐,包括python和相关库) [推荐地址:清华镜像] https://mirrors ...
- [转]《Python爬虫学习系列教程》
<Python爬虫学习系列教程>学习笔记 http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多. ...
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
随机推荐
- iOS Socket编程(一)基本概念
1.Socket的解释 Socket翻译过来中文称为套接字, 这里我找到了一段比较官方的解释Socket是什么东西: Socket是通信的基石,是支持TCP/IP协议的网络通信的基本操作单元,包含进行 ...
- WebService-php- 1(16)
最近看了挺多关于php中webservice的资料,感谢燕十八的分享,帮助了我构建服务端的过程.将学习笔记记录如下,其中包含燕十八的笔记. WebService 1 快速了解WebService 通俗 ...
- (转)科普:SATA、PCIe、AHCI、NVMe
原文链接:https://forum.51nb.com/thread-1670848-1-1.html IT 界总喜欢发明新名词.而且同一个东西,可能有几个不同的名字.同一个名字,又可能指不同的东西. ...
- 2018-2019-2 20165219《网络对抗技术》Exp4 恶意代码分析
基础问题回答 实验目的 监控系统的运行状态,看有没有可疑的程序在运行 分析一个恶意软件,就分析Exp2或Exp3中生成后门软件:分析工具尽量使用原生指令或sysinternals,systracer套 ...
- LOJ#2076. 「JSOI2016」炸弹攻击(模拟退火)
题面 传送门 题解 退火就好了 记得因为答案比较小,但是温度比较高,所以在算\(\exp\)的时候最好把相差的点数乘上一个常数来让选取更劣解的概率降低 话虽如此然而我自己打的退火答案永远是\(0\)- ...
- SpringMvc date数据传递处理
1.form表单提交date数据 form表单提交的date数据要在接收的字段上加入@DateTimeFormat注解 @DateTimeFormat(pattern = "yyyy-MM- ...
- leetcode-383-Ransom Note(以空间换时间)
题目描述: Given an arbitrary ransom note string and another string containing letters from all the magaz ...
- 【转载】Java 9 新特性——模块化
来自 <http://www.jianshu.com/p/053a5ca89bbb#> 前言 年,我们将迎来 Java 语言的 22 岁生日,22岁,对于一个人而言,正是开始大展鸿图的年纪 ...
- jQuery 动画用法
jQuery动画: <head> <meta charset="UTF-8"> <title>Title</title> <s ...
- 我把双系统的win10抹除了现在开机只按option还是会出现双系统选择,怎么把那个win10给取消了或删除掉
找到解决方法了,按步骤来吧,准备:[打开Finder如果你在侧边设备一栏里看不到 Macintosh HD 就打开Finder设置>边栏>勾选硬盘,如果能看到请无视这一行]1. 打开终端执 ...