
一个sqoop export案例中踩到的坑
案例分析:
需要将hdfs上的数据导出到mysql里的一张表里。
虚拟机集群的为:centos1-centos5
问题1:
在centos1上将hdfs上的数据导出到centos1上的mysql里:
sqoop export

  --connect jdbc:mysql://centos1:3306/test \

  --username root \

  --password root \

  --table order_uid \

  --export-dir /user/hive/warehouse/test.db/order_uid/ \

  --fields-terminated-by ','
报错:
Error executing statement: java.sql.SQLException: Access denied for user 'root'@'centos1' (using password: YES)
改成:
sqoop export
  --connect jdbc:mysql://localhost:3306/test \
  --username root \
  --password root \
  --table order_uid \
  --export-dir /user/hive/warehouse/test.db/order_uid/ \
  --fields-terminated-by ','
报错:
Error: java.io.IOException: com.mysql.jdbc.exceptions.jdbc4.MySQLSyntaxErrorException: Table 'test.order_uid' doesn't exist at

org.apache.sqoop.mapreduce.AsyncSqlRecordWriter.close(AsyncSqlRecordWriter.java:) at
org.apache.hadoop.mapred.MapTask$NewDirectOutputCollector.close(MapTask.java:) at

org.apache.hadoop.mapred.MapTask.runNewMapper(MapTask.java:) at org.apache.hadoop.mapred.MapTask.run(MapTask.java:) at

org.apache.hadoop.mapred.YarnChild$.run(YarnChild.java:) at java.security.AccessController.doPrivileged(Native Method) at
javax.security.auth.Subject.doAs(Subject.java:) at

...
问题2:
在centos3上将hdfs上的数据导出到centos1上的mysql里:
sqoop export

  --connect jdbc:mysql://centos1:3306/test \

  --username root \

  --password root \

  --table order_uid \

  --export-dir /user/hive/warehouse/test.db/order_uid/ \

  --fields-terminated-by ','
报错:
// :: ERROR mapreduce.ExportJobBase: Export job failed!

// :: ERROR tool.ExportTool: Error during export:

Export job failed!

at org.apache.sqoop.mapreduce.ExportJobBase.runExport(ExportJobBase.java:)

at org.apache.sqoop.manager.SqlManager.exportTable(SqlManager.java:)

at org.apache.sqoop.tool.ExportTool.exportTable(ExportTool.java:)

at org.apache.sqoop.tool.ExportTool.run(ExportTool.java:)

at org.apache.sqoop.Sqoop.run(Sqoop.java:)

at org.apache.hadoop.util.ToolRunner.run(ToolRunner.java:)

at org.apache.sqoop.Sqoop.runSqoop(Sqoop.java:)

at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

at org.apache.sqoop.Sqoop.main(Sqoop.java:)
在网上找到两种解决方案:
1.在网上找到有人说在hdfs的路径写到具体文件,而不是写到目录,改成:
sqoop export

  --connect jdbc:mysql://centos1:3306/test \

  --username root \

  --password root \

  --table order_uid \

  --export-dir /user/hive/warehouse/test.db/order_uid/t1.dat \

  --fields-terminated-by ','
还是报相同错误!
2. 更改mysql里表的编码
将cengos1里mysql的表order_uid字符集编码改成:utf-8,重新执行,centos1的mysql表里导入了部分数据, 仍然报错:
Job failed as tasks failed. failedMaps: failedReduces:

// :: INFO mapreduce.Job: Counters:

File System Counters

FILE: Number of bytes read=

FILE: Number of bytes written=

FILE: Number of read operations=

FILE: Number of large read operations=

FILE: Number of write operations=

HDFS: Number of bytes read=

HDFS: Number of bytes written=

HDFS: Number of read operations=

HDFS: Number of large read operations=

HDFS: Number of write operations=

Job Counters

Failed map tasks=

Killed map tasks=

Launched map tasks=

Data-local map tasks=

Rack-local map tasks=

Total time spent by all maps in occupied slots (ms)=

Total time spent by all reduces in occupied slots (ms)=

Total time spent by all map tasks (ms)=

Total vcore-milliseconds taken by all map tasks=

Total megabyte-milliseconds taken by all map tasks=

Map-Reduce Framework

Map input records=

Map output records=

Input split bytes=

Spilled Records=

Failed Shuffles=

Merged Map outputs=

GC time elapsed (ms)=

CPU time spent (ms)=

Physical memory (bytes) snapshot=

Virtual memory (bytes) snapshot=

Total committed heap usage (bytes)=

File Input Format Counters

Bytes Read=

File Output Format Counters

Bytes Written=

// :: INFO mapreduce.ExportJobBase: Transferred 1.1035 KB in 223.4219 seconds (5.0577 bytes/sec)

// :: INFO mapreduce.ExportJobBase: Exported  records.

// :: ERROR mapreduce.ExportJobBase: Export job failed!

// :: ERROR tool.ExportTool: Error during export:

Export job failed!

at org.apache.sqoop.mapreduce.ExportJobBase.runExport(ExportJobBase.java:)

at org.apache.sqoop.manager.SqlManager.exportTable(SqlManager.java:)

at org.apache.sqoop.tool.ExportTool.exportTable(ExportTool.java:)

at org.apache.sqoop.tool.ExportTool.run(ExportTool.java:)

at org.apache.sqoop.Sqoop.run(Sqoop.java:)

at org.apache.hadoop.util.ToolRunner.run(ToolRunner.java:)

at org.apache.sqoop.Sqoop.runSqoop(Sqoop.java:)

at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

at org.apache.sqoop.Sqoop.main(Sqoop.java:)
当指定map为1时:
sqoop export

  --connect jdbc:mysql://centos1:3306/test \

  --username root \

  --password root \

  --table order_uid \

  --export-dir /user/hive/warehouse/test.db/order_uid \

  --fields-terminated-by ',' \

     --m
运行成功了!!!
sqoop默认情况下的map数量为4,也就是说这种情况下1个map能运行成功,而多个map会失败。于是将map改为2又试了一遍:
sqoop export

  --connect jdbc:mysql://centos1:3306/test \

  --username root \

  --password root \

  --table order_uid \

  --export-dir /user/hive/warehouse/test.db/order_uid \

  --fields-terminated-by ',' \

     --m 2
执行结果为:
// :: INFO mapreduce.Job: Counters:

        File System Counters

                FILE: Number of bytes read=

                FILE: Number of bytes written=

                FILE: Number of read operations=

                FILE: Number of large read operations=

                FILE: Number of write operations=

                HDFS: Number of bytes read=

                HDFS: Number of bytes written=

                HDFS: Number of read operations=

                HDFS: Number of large read operations=

                HDFS: Number of write operations=

        Job Counters

                Failed map tasks=

                Launched map tasks=

                Data-local map tasks=

                Rack-local map tasks=

                Total time spent by all maps in occupied slots (ms)=

                Total time spent by all reduces in occupied slots (ms)=

                Total time spent by all map tasks (ms)=

                Total vcore-milliseconds taken by all map tasks=

                Total megabyte-milliseconds taken by all map tasks=

        Map-Reduce Framework

                Map input records=

                Map output records=

                Input split bytes=

                Spilled Records=

                Failed Shuffles=

                Merged Map outputs=

                GC time elapsed (ms)=

                CPU time spent (ms)=

                Physical memory (bytes) snapshot=

                Virtual memory (bytes) snapshot=

                Total committed heap usage (bytes)=

        File Input Format Counters

                Bytes Read=

        File Output Format Counters

                Bytes Written=

// :: INFO mapreduce.ExportJobBase: Transferred  bytes in 99.4048 seconds (7.0922 bytes/sec)

// :: INFO mapreduce.ExportJobBase: Exported 5 records.

// :: ERROR mapreduce.ExportJobBase: Export job failed!

// :: ERROR tool.ExportTool: Error during export:

Export job failed!

        at org.apache.sqoop.mapreduce.ExportJobBase.runExport(ExportJobBase.java:)

        at org.apache.sqoop.manager.SqlManager.exportTable(SqlManager.java:)

        at org.apache.sqoop.tool.ExportTool.exportTable(ExportTool.java:)

        at org.apache.sqoop.tool.ExportTool.run(ExportTool.java:)

        at org.apache.sqoop.Sqoop.run(Sqoop.java:)

        at org.apache.hadoop.util.ToolRunner.run(ToolRunner.java:)

        at org.apache.sqoop.Sqoop.runSqoop(Sqoop.java:)

        at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

        at org.apache.sqoop.Sqoop.runTool(Sqoop.java:)

        at org.apache.sqoop.Sqoop.main(Sqoop.java:)
可以看到它成功的导入了5条记录!!!
通过jobhistory窗口可以看到两个map一个成功,一个执行失败
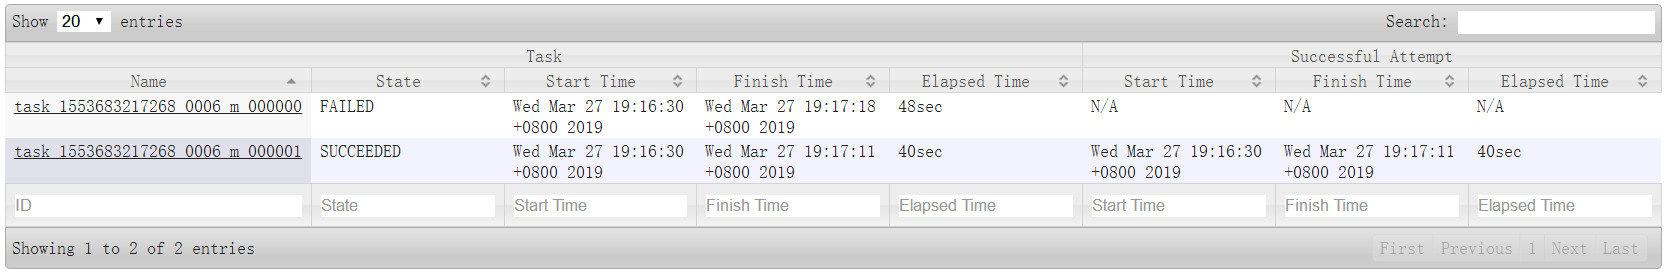
点击task的name:
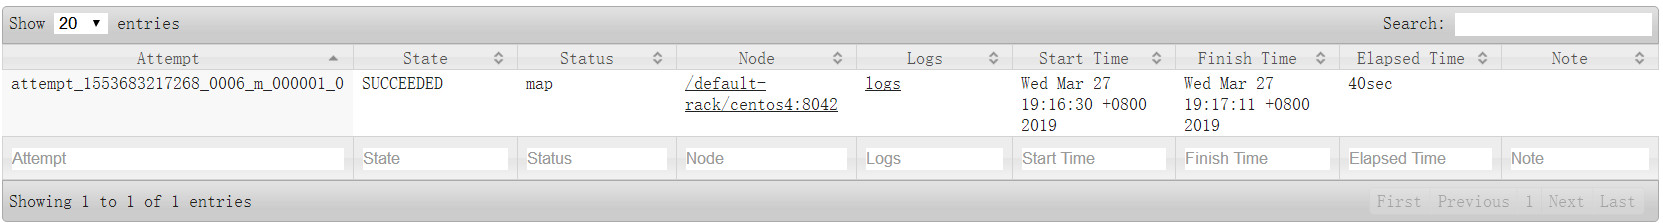
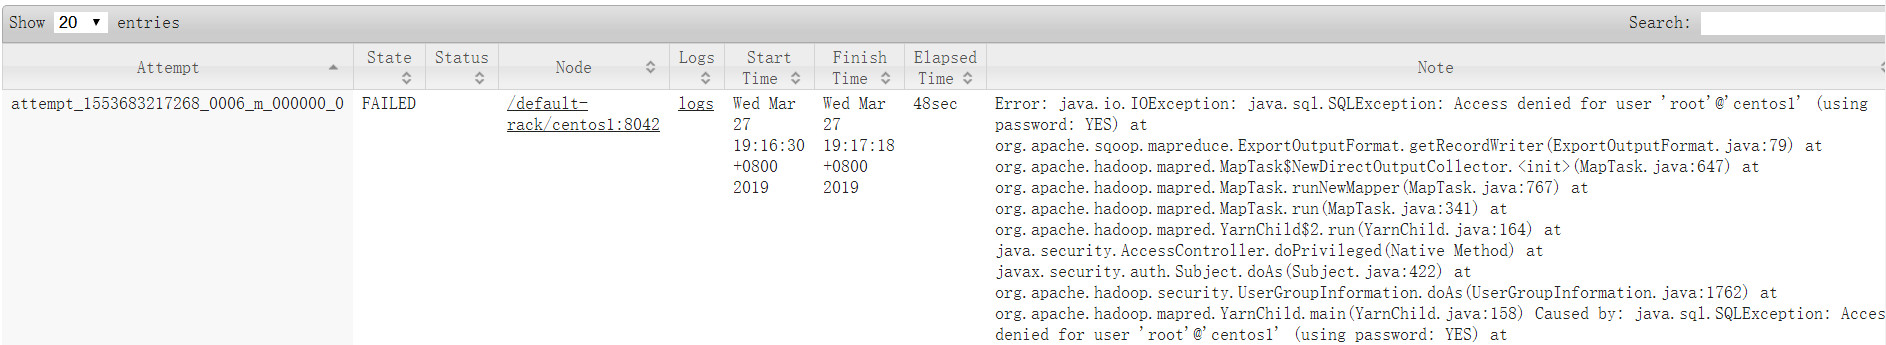
成功的任务由centos4节点运行的,失败的task由centos1运行,又回到了问题1,就是centos1不能访问centos1的mysql数据!
最终一个朋友告诉我再centos1上单独添加对centos1的远程访问权限:
grant all privileges on *.* to 'root'@'centos1' identified by 'root' with grant option;

flush privileges;
然后重新运行一下,问题1和问题2都被愉快的解决了!!!
当时在centos1上的mysql里执行了:
GRANT ALL PRIVILEGES ON *.* TO 'root'@'%' IDENTIFIED BY 'root' WITH GRANT OPTION;
flush privileges;
对其他节点添加了远程访问,但没有对自己添加远程访问权限。
一个sqoop export案例中踩到的坑的更多相关文章
- 项目中踩过的坑之-sessionStorage
总想写点什么,却不知道从何写起,那就从项目中踩过的坑开始吧,希望能给可能碰到相同问题的小伙伴一点帮助. 项目情景: 有一个id,要求通过当前网页打开一个新页面(不是当前页面),并把id传给打开的新页面 ...
- ng-zorro-antd中踩过的坑
ng-zorro-antd中踩过的坑 前端项目中,我们经常会使用阿里开源的组件库:ant-design,其提供的组件已经足以满足多数的需求,拿来就能直接用,十分方便,当然了,有些公司会对组件库进行二次 ...
- 【spring】使用spring过程中踩到的坑
这里简单记录一下,学习spring的时候碰过的异常: 异常:org.springframework.beans.factory.BeanDefinitionStoreException: Unexpe ...
- git工作中常用命令-工作中踩过的坑
踩坑篇又来啦,这是我在工作中从git小白进化到现在工作中运用自如的过程中,踩过的坑,以及解决办法. 1.基于远程develop分支,建一个本地task分支,并切换到该task分支 git checko ...
- 转:Flutter开发中踩过的坑
记录一下入手Flutter后实际开发中踩过的一些坑,这些坑希望后来者踩的越少越好.本文章默认读者已经掌握Flutter初步开发基础. 坑1问题:在debug模式下,App启动第一个页面会很慢,甚至是黑 ...
- vue项目开发中踩过的坑
一.路由 这两天移动端的同事在研究vue,跟我说看着我的项目做的,子路由访问的时候是空白的,我第一反应是,不会模块没加载进来吧,还是....此处省略一千字... 废话不多说上代码 路由代码 { pat ...
- ionic2+angular2中踩的那些坑
好久没写什么东西了,最近在做一个ionic2的小东西,遇到了不少问题,也记录一下,避免后来的同学走弯路. 之前写过一篇使用VS2015开发ionic1的文章,但自己还没摸清门道,本来也是感兴趣就学习了 ...
- JasperReport 中踩过的坑
Mac Book Pro 10.13.6Jaspersoft Studio community version 6.6.9JDK 8 安装 Jaspersoft Studio Jasper Rep ...
- spring-data-redis 使用过程中踩过的坑
spring-data-redis简介 Spring-data-redis是spring大家族的一部分,提供了在srping应用中通过简单的配置访问redis服务,对reids底层开发包(Jedis, ...
随机推荐
- visual studio 2017安装教程以及各类问题解决方案
文章的关键词和所含教程: VS2017安装/visual studio 2017安装/Xamarin/Android for visual studio 2017/VS2017找不到网站/VS2017 ...
- 沉淀再出发:ELK使用初探
沉淀再出发:ELK使用初探 一.前言 ELK是Elasticsearch.Logstash.Kibana的简称,这三者是核心套件,但并非全部. 最近ElasticSearch可以说是非常火的一款开源软 ...
- January 08 2017 Week 2nd Sunday
Believe not all that you see nor half what you hear. 眼见的不能全信,耳闻的也不能半信. What you hear, what you see, ...
- apt安装mysql
使用 APT 安装 MySQL 参考官方文档 apt-get install mysql-server 这将安装MySQL服务器的包,以及客户端和数据库公共文件的包. 在安装过程中,系统会要求您为ro ...
- Java自学之路(新手一定要看)
Java自学之路(新手一定要看) 转自尚学堂 JAVA自学之路 一:学会选择 为了就业,不少同学参加各种各样的培训. 决心做软件的,大多数人选的是java,或是.net,也有一些选择了手机.嵌入式.游 ...
- 两天学会css基础(一)
什么是css?css的作用是什么? CSS 指层叠样式表 (Cascading Style Sheets)主要作用就是给HTML结构添加样式,搭建页面结构,比如设置元素的宽高大小,颜色,位置等等. 学 ...
- BZOJ3997:[TJOI2015]组合数学(DP,Dilworth定理)
Description 给出一个网格图,其中某些格子有财宝,每次从左上角出发,只能向下或右走.问至少走多少次才能将财宝捡完.此对此问题变形,假设每个格子中有好多财宝,而每一次经过一个格子至多只能捡走一 ...
- redis安装及测试
http://jingyan.baidu.com/article/9113f81b0333e12b3214c7a8.html 下载地址:http://git.oschina.net/bingoPure ...
- XMPP备忘笔记
xmpp中文翻译计划: http://wiki.jabbercn.org/%E9%A6%96%E9%A1%B5 XEP-0004: 数据表单 摘要: 本文定义了一个XMPP扩展协议用于数据表单,可以用 ...
- css模型框
在 CSS 中,width 和 height 指的是内容区域的宽度和高度.增加内边距.边框和外边距不会影响内容区域的尺寸,但是会增加元素框的总尺寸. 假设框的每个边上有 10 个像素的外边距和 5 个 ...