
分布式ID方案有哪些以及各自的优势
1. 背景
在分布式系统中,经常需要对大量的数据、消息、http请求等进行唯一标识。例如:在分布式系统之间http请求需要唯一标识,调用链路分析的时候需要使用这个唯一标识。这个时候数据自增主键已经不能满足需求,需要一个能够生成全局唯一ID的系统,这个系统需要满足两个需求:
----全局唯一:不能出现重复ID
----高可用:ID生成系统是基础系统,被许多关键系统调用,一旦宕机,会造成严重影响
2. 经典方案介绍
1). UUID
UUID是Universally Unique Identifier的缩写,它是在一定的范围内唯一的机器生成的标识符,UUID是16字节128位长的数字,通常以36字节的字符串表示,比如:3F2504E0-4F89-11D3-9A0C-0305E82C3301。
UUID通过一定的算法机器生成,为了保证UUID的唯一性,规范定义了包括网卡MAC地址、时间戳、名字空间、随机或者伪随机数、时序等元素,以及这些元素生成UUID的算法。UUID的复杂特性保证了其唯一性。
优点:本地生成ID,不需要进行远程调用,时延低,性能高。
缺点:
1)) UUID过长,很多场景不适用,比如用UUID做数据库索引字段。
2)) 没有排序,无法保证趋势递增
2). Flicker方案
只要思路采用了MySQL自增长ID的机制,
#数据表

CREATE TABLE Tickets64(

id bigint(20) unsigned NOT NULL auto_increment,

stub char(1) NOT NULL default '',

PRIMARY KEY(id),

UNIQUE KEY stub(stub)

)ENGINE=MyISAM;

#使用下列SQL读写得到ID号

REPLACE INTO Tickets64 (stub) VALUES('a');

SELECT LAST_INSERT_ID();
replace into 跟 insert 功能类似,不同点在于:replace into 首先尝试插入数据到表中,如果发现表中已经有此行数据(根据主键或者唯-索引判断)则先删除此行数据,然后插入新的数据, 否则直接插入新数据。
优点:充分借助数据库的自增ID机制,可靠性高,生成有序的ID
缺点:
----ID生成性能依赖单台数据库读写性能
----依赖数据库,当数据库异常时整个系统不可用
3). 类snowflake方案
这种方案生成一个64bit的数字,64bit被划分成多个阶段,分别表示时间戳、机器编码、序号。
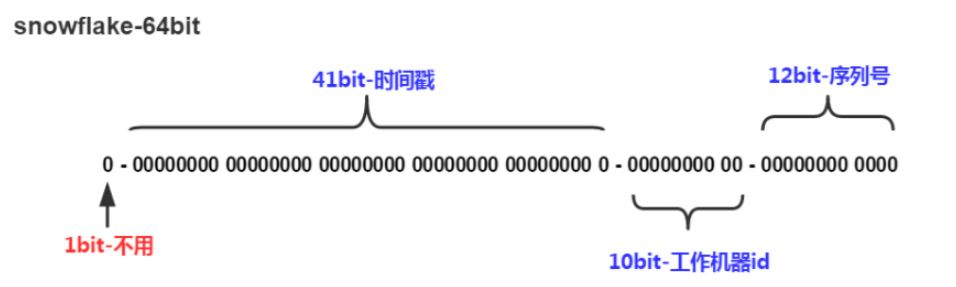
ID为64bit的long数字,由三部分组成:
----41位的时间序列(精确到毫秒,41位的长度可以使用69年)
----10位的机器标识(10位的长度最多支持部署1024个节点)
----12位的计数顺序号(12位的计数顺序号支持每个姐节点每毫秒产生4096个ID序号)
优点:
----时间戳在高位,自增序列在低位,整个ID是趋势递增的,按照时间有序
----性能高,每秒可生成几百万ID
----可以根据自身业务需求灵活调整bit位划分,满足不同需求
缺点:
----依赖机器时钟,如果机器时钟回拨,会导致重复ID生成。
----在单机上是递增的,但是由于涉及到分布式环境,每台机器上的时钟不可能完全同步,有时候会出现不时全局递增的情况
4). TDDL序列生成方式
TDDL是阿里的分裤分表中间件,它里面包含了全局数据库ID的生成方式,只要思路:
----使用数据库同步ID信息
----每次批量取一定数量的可用ID在内存中,使用完后,再请求数据库重新获取下一批可用ID,每次获取的可用ID数量由步长控制,实际业务中可根据使用速度进行匹配。
----每个业务可以给自己的序列起个唯一的名字,隔离各个业务系统的ID。
优点
----相比flicker方案,大大降低数据库写压力,数据库不再是性能瓶颈。
----相比flicker方案,生成ID性能大幅度提高,因为获取一个可用号段后在内存中直接分配,相对于每次读取数据库性能提高了几个量级
----不同业务不同的ID需求可用seqName字段区分,每个seqName的ID相互隔离,互不影响。
缺点:
----强依赖数据库,当数据库异常时整个系统不可用。
学习并转载自:https://blog.csdn.net/hl_java/article/details/78462283
分布式ID方案有哪些以及各自的优势的更多相关文章
- redis生成分布式id方案
分布式Id - redis方式 本篇分享内容是关于生成分布式Id的其中之一方案,除了redis方案之外还有如:数据库,雪花算法,mogodb(object_id也是数据库)等方案,对于redis来 ...
- 分布式ID方案有哪些以及各自的优劣势,我们当如何选择
作者介绍 段同海,就职于达达基础架构团队,主要参与达达分布式ID生成系统,日志采集系统等中间件研发工作. 背景 在分布式系统中,经常需要对大量的数据.消息.http请求等进行唯一标识,例如:在分布式系 ...
- 大型互联网公司分布式ID方案总结
ID是数据的唯一标识,传统的做法是利用UUID和数据库的自增ID,在互联网企业中,大部分公司使用的都是Mysql,并且因为需要事务支持,所以通常会使用Innodb存储引擎,UUID太长以及无序,所以并 ...
- 分布式ID方案SnowFlake雪花算法分析
1.算法 SnowFlake算法生成的数据组成结构如下: 在java中用long类型标识,共64位(每部分用-分开): 0 - 0000000000 0000000000 0000000000 000 ...
- Dubbo学习系列之七(分布式订单ID方案)
既然选择,就注定风雨兼程! 开始吧! 准备:Idea201902/JDK11/ZK3.5.5/Gradle5.4.1/RabbitMQ3.7.13/Mysql8.0.11/Lombok0.26/Erl ...
- 分布式ID生成方案汇总
1.目标 1.1.全局唯一 不能出现重复的ID,全局唯一是最基本的要求. 1.2.趋势有序 业务上分页查询需求,排序需求,如果ID直接有序,则不必建立更多的索引,增加查询条件. 而且Mysql Inn ...
- 分布式ID解决方案
开发十年,就只剩下这套Java开发体系了 >>> 在游戏开发中,我们使用分布式ID.有很多优点 便于合服 便于ID管理 等等 一.单服各自ID系统的弊端 1. 列如合服 在游戏上 ...
- 分布式Id - redis方式
本篇分享内容是关于生成分布式Id的其中之一方案,除了redis方案之外还有如:数据库,雪花算法,mogodb(object_id也是数据库)等方案,对于redis来说是我们常用并接触比较多的,因此主要 ...
- 分布式ID生成器(CosId)的设计与实现
分布式ID生成器(CosId)设计与实现 CosId 简介 CosId 旨在提供通用.灵活.高性能的分布式 ID 生成器. 目前提供了俩类 ID 生成器: SnowflakeId : 单机 TPS 性 ...
随机推荐
- abs()
abs() 用于返回一个数值的绝对值 In [1]: abs(10) Out[1]: 10 In [2]: abs(-10) Out[2]: 10 In [3]: abs(-10.9) Out[3]: ...
- 第三篇:基于K-近邻分类算法的手写识别系统
前言 本文将继续讲解K-近邻算法的项目实例 - 手写识别系统. 该系统在获取用户的手写输入后,判断用户写的是什么. 为了突出核心,简化细节,本示例系统中的输入为32x32矩阵,分类结果也均为数字.但对 ...
- vue2.0+element-ui(01简单点的单页面)
前言: 在<Vue.js权威指南>刚出版的时候,自己就作为一名前端粉捧了一把场,可是真是应了那句“出来混,总是要还的“这句话了,那时候信心满满的买来书想要认真研究,最终却还是把它搁浅了.直 ...
- PHP和shell脚本遍历目录及其下子目录
用shell写了个递归遍历目录的脚本,本脚本实现递归遍历指定目录,打印目录下的文件名(全路径). #!/bin/sh function scandir() { local cu ...
- php 升级后 htmlspecialchars 返回空 的解决方案
今天将php版本升级到5.3.0以上(我升级到php5.4.13)的版本后发现一个问题 htmlspecialchars 函数返回为空.查了资料后,发现新版本对htmlspecialchars这个函数 ...
- poj_1743 后缀数组
题目大意 给定一串数字,长度为N.定义数字中的某个连续的子串为一个"theme",只要子串满足: (1)长度 >= 5 (2)和该子串相同或者该子串的“变种串”在整串数字中出 ...
- OpenLayers基础知识:
OpenLayers是一个开源的js框架,用于在您的浏览器中实现地图浏览的效果和基本的zoom,pan等功能.OpenLayers支持的地图来源 包括了WMS,GoogleMap,KaMap,MSV ...
- LeetCode——Reverse Linked List
反转链表,用了一个比较笨的方法. public class Solution { public ListNode reverseList(ListNode head) { if(head == nul ...
- FileInputStream与FileOutputStream类 Reader类和Writer类 解析
FileInputStream和FileOutputStream类分别用来创建磁盘文件的输入流和输出流对象,通过它们的构造函数来指定文件路径和文件名. 创建FileInputStream实例对象时,指 ...
- 以用户名注册来分析三种Action获取数据的方式
1.注入属性 直接注入属性: public String userName; public String getUserName() { return userName; } public void ...