
Spark读写Hbase的二种方式对比
作者:Syn良子 出处:http://www.cnblogs.com/cssdongl 转载请注明出处
一.传统方式
这种方式就是常用的TableInputFormat和TableOutputFormat来读写hbase,如下代码所示
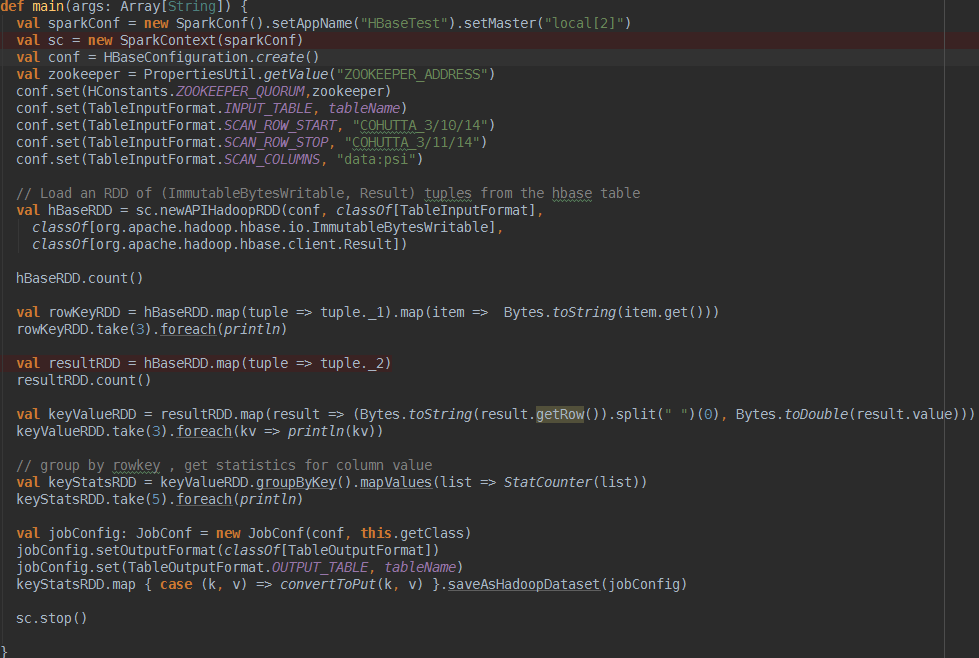
简单解释下,用sc.newAPIHadoopRDD根据conf中配置好的scan来从Hbase的数据列族中读取包含(ImmutableBytesWritable, Result)的RDD,
随后取出rowkey和value的键值对儿利用StatCounter进行一些最大最小值的计算最终写入hbase的统计列族.
二.SparkOnHbase方式
重点介绍第二种方式,这种方式其实是利用Cloudera-labs开源的一个HbaseContext的工具类来支持spark用RDD的方式批量读写hbase,先给个传送门大家感受下
https://issues.apache.org/jira/browse/HBASE-13992
https://issues.apache.org/jira/browse/HBASE-14160
虽然这个hbase-spark的module在Hbase上的集成任务很早就完成了,但是已知发布的任何版本我还没找到该模块,不知道什么情况,再等等吧
那么问题来了,这种方式的优势在哪儿呢,官方的解释我翻译如下
1>无缝的使用Hbase connection
2>和Kerberos无缝集成
3>通过get或者scan直接生成rdd
4>利用RDD支持hbase的任何组合操作
5>为通用操作提供简单的方法,同时通过API允许不受限制的未知高级操作
6>支持java和scala
7>为spark和 spark streaming提供相似的API
ok,由于hbaseContext是一个只依赖hadoop,hbase,spark的jar包的工具类,因此可以拿过来直接用
废话不说,直接用我调试过的代码来感受下
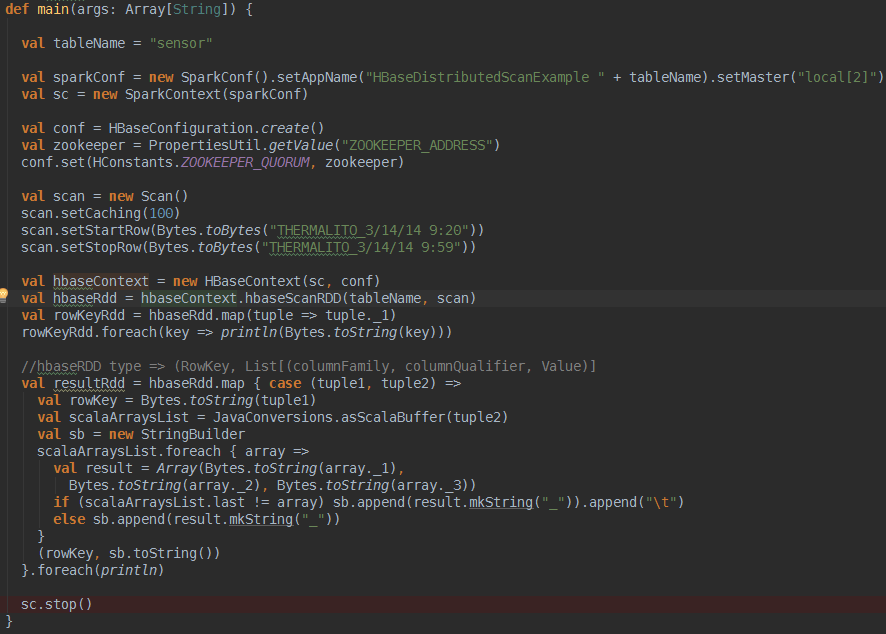
想用HbaseContext很简单,如上面代码所示,需要说明的是hbaseContext的hbaseScanRDD方法,这个方法返回的是一个
(RowKey, List[(columnFamily, columnQualifier, Value)]类型的RDD,如下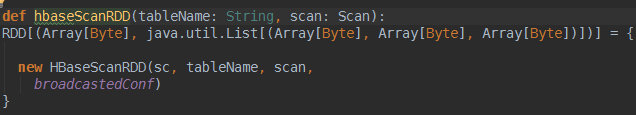
刚开始用的挺不习惯的.还得循环取出来rowkey对应的这么多列,这里你如果对它的RDD返回类型不爽,官方很贴心的提供了另外一个方法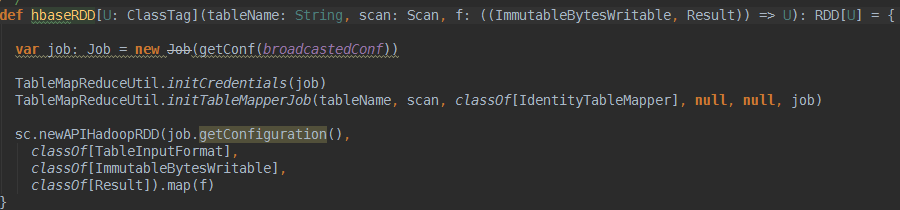
怎么样,是不是看着很眼熟了?你可以自定义第三个参数(ImmutableBytesWritable, Result),对函数f进行自定义来返回你自己喜欢的RDD格式,
程序运行结果如下,过滤出了9:20到9:58所有的rowkey以及对应的列
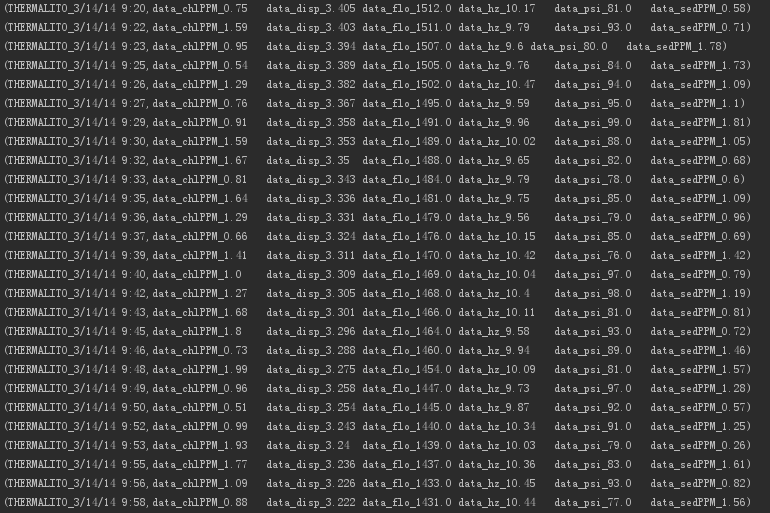
当然HbaseContext还有其他bulkGet,bulkPut,bulkDelete等,都是可以直接将hbase的操作转换成RDD,只要转成RDD了,那么rdd的这么多transform和action就可以玩的很happy了.
参考资料
https://github.com/cloudera-labs/SparkOnHBase
http://blog.cloudera.com/blog/2015/03/how-edmunds-com-used-spark-streaming-to-build-a-near-real-time-dashboard/
https://blog.cloudera.com/blog/2014/12/new-in-cloudera-labs-sparkonhbase/
Spark读写Hbase的二种方式对比的更多相关文章
- Spark入Hbase的四种方式效率对比
一.方式介绍 本次测试一种采用了四种方式进行了对比,分别是:1.在RDD内部调用java API.2.调用saveAsNewAPIHadoopDataset()接口.3.saveAsHadoopDat ...
- Spark:DataFrame批量导入Hbase的两种方式(HFile、Hive)
Spark处理后的结果数据resultDataFrame可以有多种存储介质,比较常见是存储为文件.关系型数据库,非关系行数据库. 各种方式有各自的特点,对于海量数据而言,如果想要达到实时查询的目的,使 ...
- UserView--第二种方式(避免第一种方式Set饱和),基于Spark算子的java代码实现
UserView--第二种方式(避免第一种方式Set饱和),基于Spark算子的java代码实现 测试数据 java代码 package com.hzf.spark.study; import ...
- Linux上删除大量文件几种方式对比
目录 Linux上删除大量文件几种方式对比 1. rm删除:因为文件数量太多,rm无法删除(报错) 2. find查找删除:-exec 3. find查找删除:xargs 4. find调用-dele ...
- Spark读写HBase
Spark读写HBase示例 1.HBase shell查看表结构 hbase(main)::> desc 'SDAS_Person' Table SDAS_Person is ENABLED ...
- Android自动化测试中AccessibilityService获取控件信息(2)-三种方式对比
Android自动化测试中AccessibilityService获取控件信息(2)-三种方式对比 上一篇文章: Android自动化测试中AccessibilityService获取控件信息(1 ...
- spark读写hbase性能对比
一.spark写入hbase hbase client以put方式封装数据,并支持逐条或批量插入.spark中内置saveAsHadoopDataset和saveAsNewAPIHadoopDatas ...
- Python读写文件的几种方式
一.pandas pandas模块是数据分析的大杀器,它使得对于文件相关的操作变得简单. 看一下它的简单使用 import pandas as pd # 读取 df = pd.read_csv('al ...
- spark DataFrame的创建几种方式和存储
一. 从Spark2.0以上版本开始,Spark使用全新的SparkSession接口替代Spark1.6中的SQLContext及HiveContext接口来实现其对数据加载.转换.处理等功能.Sp ...
随机推荐
- C语言 · 奇偶判断
问题描述 能被2整除的数称为偶数,不能被2整除的数称为奇数.给一个整数x,判断x是奇数还是偶数. 输入格式 输入包括一个整数x,0<=x<=100000000. 输出格式 如果x是奇数,则 ...
- Docker 第一篇--初识docker
已经多年不写博客, 看完<晓松奇谈>最后一期猛然觉醒, 决定仔细梳理下自己这几年的知识脉络. 既然决定写, 那么首先就从最近2年热门的开源项目Docker开始.Docker 这两年在国内很 ...
- 窥探Vue.js 2.0 - Virtual DOM到底是个什么鬼?
引言 你可能听说在Vue.js 2.0已经发布,并且在其中新添加如了一些新功能.其中一个功能就是"Virtual DOM". Virtual DOM是什么 在之前,React和Em ...
- .NET平台开源项目速览(17)FluentConsole让你的控制台酷起来
从该系列的第一篇文章 .NET平台开源项目速览(1)SharpConfig配置文件读写组件 开始,不知不觉已经到第17篇了.每一次我们都是介绍一个小巧甚至微不足道的.NET平台的开源软件,或者学习,或 ...
- JavaScript动画-拖拽改变元素大小
▓▓▓▓▓▓ 大致介绍 拖拽改变元素大小是在模拟拖拽上增加了一些功能 效果:拖拽改变元素大小 ▓▓▓▓▓▓ 拖拽改变元素大小原理 首先这个方块得知道我们想要改变这个它的大小,所以我给它设定一个范围,当 ...
- 谈谈一些有趣的CSS题目(十)-- 结构性伪类选择器
开本系列,谈谈一些有趣的 CSS 题目,题目类型天马行空,想到什么说什么,不仅为了拓宽一下解决问题的思路,更涉及一些容易忽视的 CSS 细节. 解题不考虑兼容性,题目天马行空,想到什么说什么,如果解题 ...
- bootstrap-fileinput 简单使用
bootstrap-fileinput 是一款图片/文件上传 bootstrap 插件,简单示例代码: <!DOCTYPE html> <html> <head> ...
- JavaScript基础知识总结(四)
JavaScript语法 八.函数 函数就是完成某个功能的一组语句,函数由关键字function + 函数名 + 加一组参数定义: 函数在定义后可以被重复调用,通常将常用的功能写成一个函数,利用函数可 ...
- 【JQ基础】数组
each() 方法规定为每个匹配元素规定运行的函数.
- Android 死锁和重入锁
死锁的定义: 1.一般的死锁 一般的死锁是指多个线程的执行必须同时拥有多个资源,由于不同的线程需要的资源被不同的线程占用,最终导致僵持的状态,这就是一般死锁的定义. package com.cxt.t ...