
python 排序和查找算法
一、搜索
1.顺序查找
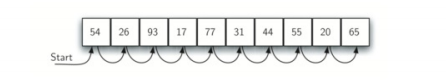
数据存储在具有线性或顺序关系的结构中时,可顺序访问查找
def sequential_search(ilist, item):

    pos = 0

    while pos < len(ilist):

        if ilist[pos] == item:

            return pos

        else:

            pos = pos + 1

    return -1
2.二分查找
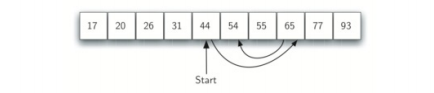
对于有序顺序表可使用二分查找,每次从中间项开始,故每次可以排除剩余项的一半
def binary_search(ilist, item):

    first = 0

    last = len(ilist)

    while first <= last:

        mid_point = (first + last) // 2

        if ilist[mid_point] == item:

            return mid_point

        else:

            if item < ilist[mid_point]:

                last = mid_point - 1

            else:

                first = mid_point + 1

    return -1
递归版本
def binary_search(ilist, item):

    if len(ilist) == 0:

        return -1

    else:

        midpoint = len(ilist) // 2

        if ilist[midpoint] == item:

            return midpoint

        else:

            if item < ilist[midpoint]:

                return binary_search(ilist[:midpoint-1], item)

            else:

                return binary_search(ilist[midpoint+1:], item)
3.Hash查找
数据存储在哈希表,哈希表每一个位置通常称为一个槽,槽一般可以从1开始依次编号,数据与槽之间的映射叫做hash 函数。负载因子
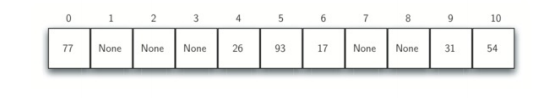
一些普通的hash函数:余数法(只需要将数据除以表大小)、分组求和法(将数据分成相等的大小的块,然后将块加在一起求出散列值)、平方取中法(先对数据平方,然后提取一部分数据结果)
由于槽数有限,所以会有冲突发生,解决冲突的方式:开放寻址(循环查看hash表,直到找到一个空槽),线性探测(顺序查找空槽,例如:1,2,3,4,5,缺点是容易产生聚集),重新散列(跳过槽,均匀分布冲突的槽,例如:1,3,5,7,9),二次探测(使用常量跳过值,如1,4,9,16),链表(如下图)

具体实现可以使用Python的字典
二、排序
1.冒泡排序
顾名思义,像泡沫一样浮起来,或者像重物一样沉底,每趟排序都会有一个极值到达最终位置。
def bubble_sort(nlist):

    for pass_num in range(len(nlist)-1, 0, -1):

        exchanges = False

        for i in range(pass_num):

            if nlist[i] > nlist[i+1]:

                exchanges = True

                nlist[i], nlist[i+1] = nlist[i+1], nlist[i]

        if not exchanges:

            return
2.选择排序
每一次选择一个极值放在最终位置。相比冒泡排序,减少了交换次数。
def selection_sort(nlist):

    for fill_slot in range(len(nlist)-1, 0, -1):

        position_of_max = 0

        for location in range(1, fill_slot+1):

            if nlist[location] > nlist[position_of_max]:

                position_of_max = location

        nlist[fill_slot], nlist[position_of_max] = nlist[position_of_max], nlist[fill_slot]
3.插入排序
类似于打牌抽牌时的插牌,逐次增加有序列表的个数。
def insertion_sort(nlist):

    for index in range(1, len(nlist)):

        current_value = nlist[index]

        position = index

        while position > 0 and nlist[position-1] > current_value:

            nlist[position] = nlist[position-1]

            position = position - 1

        nlist[position] = current_value
4.希尔排序
希尔排序通过将原始列表分解为多个较小的子列表来改进插入排序,每个子列表使用插入排序进行排序。
def shell_sort(nlist):

    sub_list_count = len(nlist) // 2

    while sub_list_count > 0:

        for start_position in range(sub_list_count):

            gap_insertion_sort(nlist, start_position, sub_list_count)

        sub_list_count = sub_list_count // 2

def gap_insertion_sort(nlist, start, gap):

    for i in range(start + gap, len(nlist), gap):

        current_value = nlist[i]

        position = i

        while position >= gap and nlist[position - gap] > current_value:

            nlist[position] = nlist[position - gap]

            position = position - gap

        nlist[position] = current_value
5.归并排序
一种递归算法,不断将列表分成一半,然后排序子列表,再合并。分而治之策略。
def merge_sort(nlist):

    if len(nlist) > 1:

        mid = len(nlist) // 2

        left_half = nlist[:mid]

        right_half = nlist[mid:]

        merge_sort(left_half)

        merge_sort(right_half)

        i, j, k = 0, 0, 0

        while i < len(left_half) and j < len(right_half):

            if left_half[i] < right_half[j]:

                nlist[k] = left_half[i]

                i += 1

            else:

                nlist[k] = right_half[j]

                j += 1

            k += 1

        while i < len(left_half):

            nlist[k] = left_half[i]

            i += 1

            k += 1

        while j < len(right_half):

            nlist[k] = right_half[j]

            j += 1

            k += 1
6.快速排序
选择一个值作为枢轴值,然后作为基准,序列变为一边比值大一边比值小的两部分,每趟排序确定枢轴值的位置。
def quick_sort(nlist):

    quick_sort_helper(nlist, 0, len(nlist) - 1)

def quick_sort_helper(nlist, first, last):

    if first < last:

        split_point = partition(nlist, first, last)

        quick_sort_helper(nlist, first, split_point - 1)

        quick_sort_helper(nlist, split_point + 1, last)

def partition(nlist, first, last):

    pivot_value = nlist[first]

    left_mark = first + 1

    right_mark = last

    while True:

        while left_mark <= right_mark and nlist[left_mark] <= pivot_value:

            left_mark = left_mark + 1

        while right_mark >= left_mark and nlist[right_mark] >= pivot_value:

            right_mark = right_mark - 1

        if right_mark < left_mark:

            break

        else:

            nlist[left_mark], nlist[right_mark] = nlist[right_mark], nlist[left_mark]

    nlist[first], nlist[right_mark] = nlist[right_mark], nlist[first]

    return right_mark
最后:

python 排序和查找算法的更多相关文章
- Python排序搜索基本算法之归并排序实例分析
Python排序搜索基本算法之归并排序实例分析 本文实例讲述了Python排序搜索基本算法之归并排序.分享给大家供大家参考,具体如下: 归并排序最令人兴奋的特点是:不论输入是什么样的,它对N个元素的序 ...
- python实现折半查找算法&&归并排序算法
今天依旧是学算法,前几天在搞bbs项目,界面也很丑,评论功能好像也有BUG.现在不搞了,得学下算法和数据结构,笔试过不了,连面试的机会都没有…… 今天学了折半查找算法,折半查找是蛮简单的,但是归并排序 ...
- python实现二分查找算法
二分查找算法也成为折半算法,对数搜索算法,一会中在有序数组中查找特定一个元素的搜索算法.搜索过程是从数组中间元素开始的 如果中间元素正好是要查找的元素,则搜索过程结束:如果查找的数大于中间数,则在数组 ...
- Python递归函数,二分查找算法
目录 一.初始递归 二.递归示例讲解 二分查找算法 一.初始递归 递归函数:在一个函数里在调用这个函数本身. 递归的最大深度:998 正如你们刚刚看到的,递归函数如果不受到外力的阻止会一直执行下去.但 ...
- C# 基础排序与查找算法
排序算法: class Sort { static void swap<T>(ref T a, ref T b) { T tmp = a; a = b; b = tmp; } #regio ...
- python基础一 ------排序和查找算法
插入排序; 假设数组长度为n,先从第二个元素开始,与前一个元素比较,之后将较小的元素 放在前面,现在前两个元素是有顺序的,这时取第三个元素,与前一个元素(也就是第二个)比较,较小的放在前面 ...
- 面试常问的几个排序和查找算法,PHP实现
冒泡,快排,二分查找,都是面试常问的几个算法题目,虽然简单,但是一段时间不用的话就很容易忘记,这里我用PHP实现了一下,温故而知新. 排序 冒泡排序 每一次冒出一个最大的值 function bubb ...
- [PHP] 排序和查找算法
知乎:冒泡排序(bubble sort)的原理是什么? 潘屹峰: 冒泡排序的原理可以顾名思义:把每个数据看成一个气泡,按初始顺序自底向上依次对两两气泡进行比较,对上重下轻的气泡交换顺序(这里用气泡轻. ...
- C#常用排序和查找算法
1.C#堆排序代码 private static void Adjust (int[] list, int i, int m) { int Temp = list[i]; int j = i * 2 ...
随机推荐
- Wireshark使用技巧:提取VOIP通话中的音频流
"Wireshark的RTP流分析功能实战." 在VOIP协议的分析过程中,常常会遇到一些标准协议承载的语音传输,如以SIP.H.323为控制协商协议,RTP为语音数据协议的VOI ...
- Discuz! 全局变量说明
$_G 保存了 Discuz! 中所有的预处理数据 缓存能够很好的提高程序的性能,一些配置数据没必要每次都查询数据库,只要在修改了的时候更新下缓存即可. Discuz! 中所有的缓存保存在 $_G[c ...
- .net4.0使用Dapper操作MySql
准备使用Dapper操作MySql,由于电脑只有vs2010,所以需要Dapper和MySql组件支持.net 4.0.经过一番测试,终于弄出一个DEMO. 1.操作MySql需要用MySql.Dat ...
- hive的metatable学习
一.存储Hive版本的元数据表(VERSION)   二.Hive数据库相关的元数据表(DBS.DATABASE_PARAMS) DBS --存储Hive中所有数据库的基本信息   DATAB ...
- HOW TO: Setting up Encrypted Communications Channels in Oracle Databas
access_timeSeptember 22, 2015 person_outlineMartin Rakhmanov share In this article, I will explain h ...
- JavaScript判断是否是数字
JavaScript判断是否是数字的几种方法 isNaN() /** * 判断是否是数字 */ function isNumber(value){ if(isNaN(value)){ return f ...
- win10查看桌面壁纸路径
如题,win10查看自己壁纸的缓存路径,就是找到壁纸的原图:在explorer里输入 %USERPROFILE%\AppData\Roaming\Microsoft\Windows\Themes 1 ...
- Hadoop序列化案例实操
需求 统计每一个手机号耗费的总上行流量.下行流量.总流量. 输入数据: 1 13736230513 192.196.100.1 www.atguigu.com 2481 24681 200 2 138 ...
- requests---重定向
通常我们抓包的过程中,都会看到302的状态码,那么这个过程发生了什么? 什么是重定向 就是通过各种方法将各种网络请求重新定个方向转到其它位置,本来应该从a出发到达b但是最终到达了c,这种场景就叫做重定 ...
- spring框架开发包官网各版本的下载地址
链接地址https://spring.io/tools3/sts/legacy,推荐迅雷下载