
首次引入大模型!Bert-vits2-Extra中文特化版40秒素材复刻巫师3叶奈法

Bert-vits2项目又更新了,更新了一个新的分支:中文特化,所谓中文特化,即针对中文音色的特殊优化版本,纯中文底模效果百尺竿头更进一步,同时首次引入了大模型,使用国产IDEA-CCNL/Erlangshen-MegatronBert-1.3B大模型作为Bert特征提取,基本上完全解决了发音的bad case,同时在情感表达方面有大幅提升,可以作为先前V1.0.1纯中文版本更好的替代。
更多情报请参见Bert-vits2项目官网:
https://github.com/fishaudio/Bert-VITS2/releases/tag/Extra
本次我们基于Bert-vits2中文特化版本通过40秒素材复刻巫师3角色叶奈法(Yennefer)的音色。
配置Bert-vits2中文特化版本
首先克隆项目:
git clone https://github.com/v3ucn/Bert-VITS2-Extra_-.git
注意这里是针对官方的Extra分支的修改版本,增加了音频切分和转写。
随后下载新的纯中文底模:
https://openi.pcl.ac.cn/Stardust_minus/Bert-VITS2/modelmanage/show_model
同时还需要下载IDEA-CCNL/Erlangshen-MegatronBert-1.3B大模型的预训练模型:
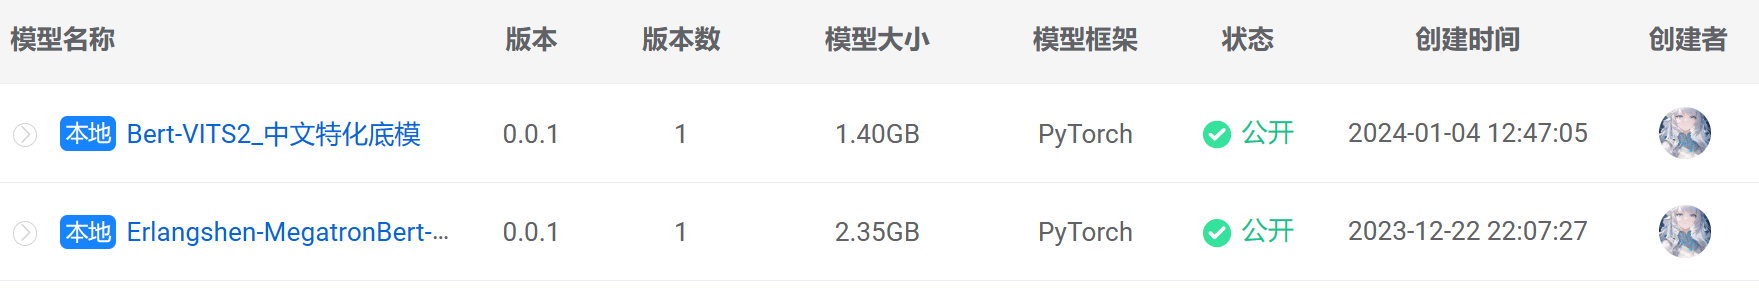
值得一提的是,这个新炼的纯中文底模非常牛逼,官方作者仅通过一个5秒的素材就可以完美复刻音色。
关于作者的中文特化底模极限测试:
https://www.bilibili.com/video/BV1Fa4y1B7HB/
随后将模型放入对应的文件夹,bert模型文件结构如下:
E:\work\Bert-VITS2-Extra\bert>tree /f

Folder PATH listing for volume myssd

Volume serial number is 7CE3-15AE

E:.

│   bert_models.json

│

├───bert-base-japanese-v3

│       .gitattributes

│       config.json

│       README.md

│       tokenizer_config.json

│       vocab.txt

│

├───bert-large-japanese-v2

│       .gitattributes

│       config.json

│       README.md

│       tokenizer_config.json

│       vocab.txt

│

├───chinese-roberta-wwm-ext-large

│       .gitattributes

│       added_tokens.json

│       config.json

│       pytorch_model.bin

│       README.md

│       special_tokens_map.json

│       tokenizer.json

│       tokenizer_config.json

│       vocab.txt

│

├───deberta-v2-large-japanese

│       .gitattributes

│       config.json

│       pytorch_model.bin

│       README.md

│       special_tokens_map.json

│       tokenizer.json

│       tokenizer_config.json

│

├───deberta-v2-large-japanese-char-wwm

│       .gitattributes

│       config.json

│       pytorch_model.bin

│       README.md

│       special_tokens_map.json

│       tokenizer_config.json

│       vocab.txt

│

├───deberta-v3-large

│       .gitattributes

│       config.json

│       generator_config.json

│       pytorch_model.bin

│       README.md

│       spm.model

│       tokenizer_config.json

│

├───Erlangshen-DeBERTa-v2-710M-Chinese

│       config.json

│       special_tokens_map.json

│       tokenizer_config.json

│       vocab.txt

│

├───Erlangshen-MegatronBert-1.3B-Chinese

│       config.json

│       pytorch_model.bin

│       vocab.txt

│

└───Erlangshen-MegatronBert-3.9B-Chinese

        config.json

        special_tokens_map.json

        tokenizer_config.json

        vocab.txt
很明显,这里关于Erlangshen-MegatronBert大模型,其实有三个参数选择,有710m和1.3b以及3.9B,作者选择了居中的1.3b大模型。
这里介绍一下国产的Erlangshen-MegatronBert大模型。
Erlangshen-MegatronBert 是一个具有 39 亿参数的中文 BERT 模型,它是目前最大的中文 BERT 模型之一。这个模型的编码器结构为主,专注于解决各种自然语言理解任务。它同时,鉴于中文语法和大规模训练的难度,使用了四种预训练策略来改进 BERT,Erlangshen-MegatronBert 模型适用于各种自然语言理解任务,包括文本生成、文本分类、问答等,这个模型的权重和代码都是开源的,可以在 Hugging Face 和 CSDN 博客等平台上找到。
Erlangshen-MegatronBert 模型可以应用于多种领域,如 AI 模拟声音、数字人虚拟主播等。
另外需要注意的是,clap模型也已经回归,结构如下:
E:\work\Bert-VITS2-Extra\emotional\clap-htsat-fused>tree /f

Folder PATH listing for volume myssd

Volume serial number is 7CE3-15AE

E:.

    .gitattributes

    config.json

    merges.txt

    preprocessor_config.json

    pytorch_model.bin

    README.md

    special_tokens_map.json

    tokenizer.json

    tokenizer_config.json

    vocab.json

No subfolders exist
clap主要负责情感风格的引导。2.3版本去掉了,中文特化又加了回来。
至此模型就配置好了。
Bert-vits2中文特化版本训练和推理
首先把叶奈法的音频素材放入角色的raw目录。
随后需要对数据进行预处理操作:
python3 audio_slicer.py

python3 short_audio_transcribe.py
这里是切分和转写。
接着运行预处理的webui:
python3 webui_preprocess.py
这里需要注意的是,bert特征文件的生成会变慢,因为需要大模型的参与。
后续应该会有一些改进。
数据处理之后,应该包括重采样音频,bert特征文件,以及clap特征文件:
E:\work\Bert-VITS2-Extra\Data\Yennefer\wavs>tree /f

Folder PATH listing for volume myssd

Volume serial number is 7CE3-15AE

E:.

    Yennefer_0.bert.pt

    Yennefer_0.emo.pt

    Yennefer_0.spec.pt

    Yennefer_0.wav

    Yennefer_1.bert.pt

    Yennefer_1.emo.pt

    Yennefer_1.spec.pt

    Yennefer_1.wav

    Yennefer_10.bert.pt

    Yennefer_10.emo.pt

    Yennefer_10.spec.pt

    Yennefer_10.wav

    Yennefer_11.bert.pt

    Yennefer_11.emo.pt

    Yennefer_11.spec.pt

    Yennefer_11.wav

    Yennefer_12.bert.pt

    Yennefer_12.emo.pt

    Yennefer_12.spec.pt

    Yennefer_12.wav

    Yennefer_13.bert.pt

    Yennefer_13.emo.pt

    Yennefer_13.spec.pt

    Yennefer_13.wav

    Yennefer_14.bert.pt

    Yennefer_14.emo.pt

    Yennefer_14.spec.pt

    Yennefer_14.wav

    Yennefer_15.bert.pt

    Yennefer_15.emo.pt

    Yennefer_15.spec.pt

    Yennefer_15.wav

    Yennefer_16.bert.pt

    Yennefer_16.emo.pt

    Yennefer_16.spec.pt

    Yennefer_16.wav

    Yennefer_17.bert.pt

    Yennefer_17.emo.pt

    Yennefer_17.spec.pt

    Yennefer_17.wav

    Yennefer_18.bert.pt

    Yennefer_18.emo.pt

    Yennefer_18.spec.pt

    Yennefer_18.wav

    Yennefer_19.bert.pt

    Yennefer_19.emo.pt

    Yennefer_19.spec.pt

    Yennefer_19.wav

    Yennefer_2.bert.pt

    Yennefer_2.emo.pt

    Yennefer_2.spec.pt

    Yennefer_2.wav

    Yennefer_20.bert.pt

    Yennefer_20.emo.pt

    Yennefer_20.spec.pt

    Yennefer_20.wav

    Yennefer_3.bert.pt

    Yennefer_3.emo.pt

    Yennefer_3.spec.pt

    Yennefer_3.wav

    Yennefer_4.bert.pt

    Yennefer_4.emo.pt

    Yennefer_4.spec.pt

    Yennefer_4.wav

    Yennefer_5.bert.pt

    Yennefer_5.emo.pt

    Yennefer_5.spec.pt

    Yennefer_5.wav

    Yennefer_6.bert.pt

    Yennefer_6.emo.pt

    Yennefer_6.spec.pt

    Yennefer_6.wav

    Yennefer_7.bert.pt

    Yennefer_7.emo.pt

    Yennefer_7.spec.pt

    Yennefer_7.wav

    Yennefer_8.bert.pt

    Yennefer_8.emo.pt

    Yennefer_8.spec.pt

    Yennefer_8.wav

    Yennefer_9.bert.pt

    Yennefer_9.emo.pt

    Yennefer_9.spec.pt

    Yennefer_9.wav
随后训练即可:
python3 train_ms.py
结语
Bert-vits2中文特化版本引入了大模型,导致入门的门槛略微变高了一点,官方说至少需要8G显存才可以跑,实际上6G也是可以的,如果bert大模型选择参数更少的版本,相信运行的门槛会进一步的降低。
最后奉上整合包链接:
整合包链接:https://pan.quark.cn/s/754f236ef864
首次引入大模型!Bert-vits2-Extra中文特化版40秒素材复刻巫师3叶奈法的更多相关文章
- 华为高级研究员谢凌曦:下一代AI将走向何方?盘古大模型探路之旅
摘要:为了更深入理解千亿参数的盘古大模型,华为云社区采访到了华为云EI盘古团队高级研究员谢凌曦.谢博士以非常通俗的方式为我们娓娓道来了盘古大模型研发的"前世今生",以及它背后的艰难 ...
- 千亿参数开源大模型 BLOOM 背后的技术
假设你现在有了数据,也搞到了预算,一切就绪,准备开始训练一个大模型,一显身手了,"一朝看尽长安花"似乎近在眼前 -- 且慢!训练可不仅仅像这两个字的发音那么简单,看看 BLOOM ...
- AI大模型学习了解
# 百度文心 上线时间:2019年3月 官方介绍:https://wenxin.baidu.com/ 发布地点: 参考资料: 2600亿!全球最大中文单体模型鹏城-百度·文心发布 # 华为盘古 上线时 ...
- DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍
DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍 1. 概述 近日来,ChatGPT及类似模型引发了人工智能(AI)领域的一场风潮. 这场风潮对数字世 ...
- 无插件的大模型浏览器Autodesk Viewer开发培训-武汉-2014年8月28日 9:00 – 12:00
武汉附近的同学们有福了,这是全球第一次关于Autodesk viewer的教室培训. :) 你可能已经在各种场合听过或看过Autodesk最新推出的大模型浏览器,这是无需插件的浏览器模型,支持几十种数 ...
- PowerDesigner 学习:十大模型及五大分类
个人认为PowerDesigner 最大的特点和优势就是1)提供了一整套的解决方案,面向了不同的人员提供不同的模型工具,比如有针对企业架构师的模型,有针对需求分析师的模型,有针对系统分析师和软件架构师 ...
- PowerDesigner 15学习笔记:十大模型及五大分类
个人认为PowerDesigner 最大的特点和优势就是1)提供了一整套的解决方案,面向了不同的人员提供不同的模型工具,比如有针对企业架构师的模型,有针对需求分析师的模型,有针对系统分析师和软件架构师 ...
- 文心大模型api使用
文心大模型api使用 首先,我们要获取硅谷社区的连个key 复制两个api备用 获取Access Token 获取access_token示例代码 之后就会输出 作文创作 作文创作:作文创作接口基于文 ...
- 《zw版·delphi与halcon系列原创教程》zw版_THOperatorSetX控件函数列表 v11中文增强版
<zw版·delphi与halcon系列原创教程>zw版_THOperatorSetX控件函数列表v11中文增强版 Halcon虽然庞大,光HALCONXLib_TLB.pas文件,源码就 ...
- xshell 5中文破解版下载
xshell 5破解版是一款功能强大的终端模拟软件,支持Telnet.Rlogin.SSH.SFTP.Serial等远程协议,让用户能通过互联网直接连接远程主机.用户通过xshell 5破解版能轻松和 ...
随机推荐
- 西门子300PLC转以太网无需编程实现与1200PLC转以太网数据交换
西门子300PLC转以太网无需编程实现与1200PLC转以太网数据通信 本文介绍利用兴达易控生产的PLC转以太网模块(MPI-ETH-XD1.0Plus)实现1200/1500PLC与300(CPU3 ...
- 分布式事务 —— SpringCloud Alibaba Seata
Seata 简介 传统的单体应用中,业务操作使用同一条连接操作不同的数据表,一旦出现异常就可以整体回滚.随着公司的快速发展.业务需求的变化,单体应用被拆分成微服务应用,原来的单体应用被拆分成多个独立的 ...
- 其它——Siege压力测试工具使用
文章目录 Siege压力测试工具使用 一 Siege介绍 二 windows 下使用 三 mac和linux使用 四 使用 五 参数详解 六 结果详解 七 修改系统的文件描述符限制 Siege压力测试 ...
- Android应用中对于微信分享的实例及问题
源码地址 如何分享 分享无相应 分享结果如何接收响应 微信 分享回调 (提示几点关键问题: debug_key 一定要获得对应的签名码 然后和weixin官网的appid对应 ) 几点注意 ...
- NOI 2023 春季测试 游记
开坑,待填. upd: 摆,不想填,但还是来填坑了. \(Day -1\) 看板子,什么都不会.发现自己已经不会写十二月刷了一整个题单的线段树合并了,感慨了一下自己连鱼都不如的记忆力,不过反正春测不考 ...
- Codeforces Round 856 (Div. 2)C
C. Scoring Subsequences 思路:我们想要找到满足的最大值的长度最长的的区间,因为单调不减,所以更大的数一定在最大值的里面包含,所以我们用两个指针维护这样一个满足当前i的最大值区间 ...
- Qt 迭代器
目录 (一) java风格迭代器 1. QListIterator类 1. 初始化 2. findNext() 3. findPrevious() 4. hasNext() 5. hasPreviou ...
- Html文本学习内容-2
(一)文本 1.大小写转换 text-transform属于处理文本的大小写,有4个值: none(默认值) uppercase(全部大写) lowercase(全部小写) capitalize(首字 ...
- 神经网络基础篇:Python 中的广播(Broadcasting in Python)
Python 中的广播 这是一个不同食物(每100g)中不同营养成分的卡路里含量表格,表格为3行4列,列表示不同的食物种类,从左至右依次为苹果,牛肉,鸡蛋,土豆.行表示不同的营养成分,从上到下依次为碳 ...
- 微信支付:wxpay.unifiedOrder(data)返回appid 与 openId 不配
原因:小程序和APP.公众号等支付方式夸端口调用支付,后台配置多个appId时 A程序中的openid 在B程序中支付.即使用A程序的openid和B程序的appIdy去调用wxpay.unified ...