
mybatis查询大批量数据的几种方式
问题背景
公司里有很多需要跑批数据的场景,这些数据几十万到几千万不等,目前我们采用的是分页查询,但是分页查询有个深度分页问题,上百万的数据就会查询的很慢
常规解决方案
- 全量查询
- 分页查询
- 流式查询
- 游标查询
1. 全量查询
默认情况下,全量查询的话系统会把所有结果集存储在内存中,在数据库中准备了大概200w的数据:
<select id="listUser" resultType="com.sun.ddd.infra.po.User">

        select * from user

</select>
@Test

public void test() {

    StopWatch stopWatch = new StopWatch();

    stopWatch.start("全量查询");

    List<User> users = userService.listUser();

    stopWatch.stop();

    System.out.println(stopWatch.getLastTaskName() + ":" + stopWatch.getLastTaskTimeMillis() + ":代码行数:" + users.size());

}
全量查询:21757:代码行数:2778523
利用JDK自带的java VisualVM监控全量查询时的内存占用情况
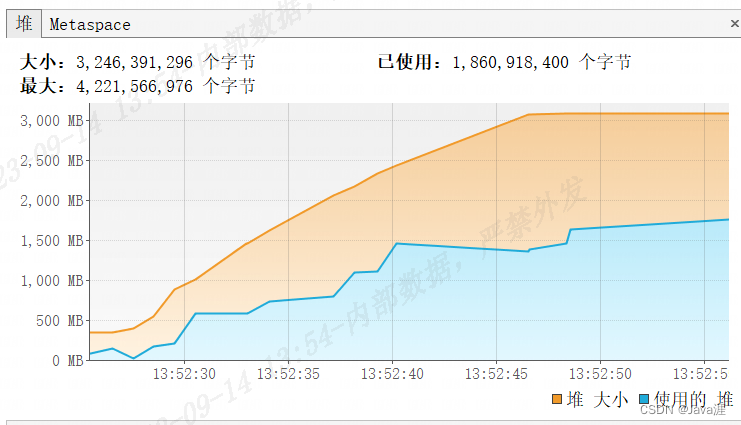
- 可以很明显的看出
200w的数据一次性查询占用总体内存1500MB,这个内存占用还是很大的,如果还有其他服务在运行,很容易导致OOM
2. 分页查询
为了解决全量查询占用内存过大,可能导致OOM问题,我们可以选择使用分页查询,这样就不会导致内存溢出问题了
@Override

public List<User> pageUser(Integer pageNum, Integer pageSize) {

    pageNum = (pageNum - 1) * pageSize;

	return userDao.pageUser(pageNum, pageSize);

}
<select id="pageUser" resultType="com.sun.ddd.infra.po.User">

    select * from user limit #{pageNum},#{pageSize}

</select>
@Test

public void test() {

    StopWatch stopWatch = new StopWatch();

    stopWatch.start("分页查询");

        int pageCount = 0;

        for (int i = 1; i < 1000; i++) {

            List<User> users1 = userService.pageUser(i, 2000);

            pageCount = pageCount + users1.size();

        }

        stopWatch.stop();

        System.out.println(stopWatch.getLastTaskName() + ":" + stopWatch.getLastTaskTimeMillis() + ":代码行数:" + pageCount);

    }
分页查询:285343:代码行数:1998000
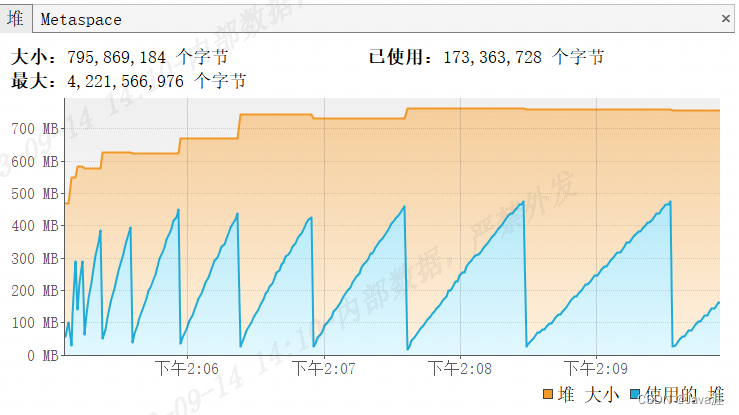
- 使用分页后,查询内存使用情况,最多占用内存不到
500MB,是全量查询占用内存的1/3不到,但是由于深度分页和多次与数据库连接的缘故,导致整个查询时间很长,长达280s,如果数据更多点查询时间则更多
3. 流式查询
那有没有什么方式,可以查的又快,占用内存又小呢?答案当然是有的了
客户端 JDBC 发起 SQL 查询,等待服务端准备数据。MySQL 服务端会向 JDBC 代表的客户端内核源源不断的输送数据,直到客户端请求 Socket 缓冲区满,这时的 MySQL服务端会阻塞。对于 JDBC 客户端而言,数据每次读取都是从本机器的内核缓冲区,所以性能会更快一些。类似服务端向客户端不断push的过程
是否使用流式的标志:
 /**

     * We only stream result sets when they are forward-only, read-only, and the

     * fetch size has been set to Integer.MIN_VALUE

     *

     * @return true if this result set should be streamed row at-a-time, rather

     *         than read all at once.

     */

    protected boolean createStreamingResultSet() {

        return ((this.query.getResultType() == Type.FORWARD_ONLY) && (this.resultSetConcurrency == java.sql.ResultSet.CONCUR_READ_ONLY)

                && (this.query.getResultFetchSize() == Integer.MIN_VALUE));

    }
其中我们只要关注this.query.getResultFetchSize() == Integer.MIN_VALUE,对应xml配置就是fetchSize="-2147483648"
<select id="listUserByStream" fetchSize="-2147483648" resultType="com.sun.ddd.infra.po.User">

        select * from user

</select>
这里mapper接口不需要返回值,因为数据都存储在ResultHandler<User>中了
void listUserByStream(ResultHandler<User> handler);
@Test

public void test() {

   StopWatch stopWatch = new StopWatch();

   stopWatch.start("流式查询");

        AtomicInteger totalCount = new AtomicInteger(0);

        userService.listUserByStream(context -> {

            // 处理查询结果

            context.getResultObject();

            totalCount.incrementAndGet();

        });

        stopWatch.stop();

        System.out.println(stopWatch.getLastTaskName() + ":" + stopWatch.getLastTaskTimeMillis() + ":代码行数:" + totalCount.get());

    }
流式查询:9967:代码行数:2778523
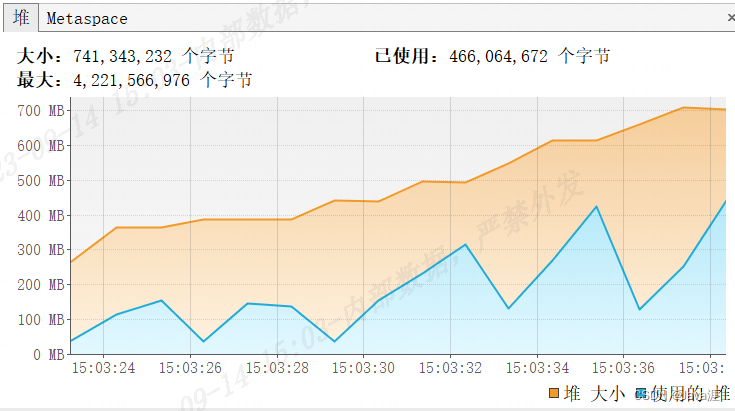
同样是
200w数据,可以明显看出查询时间只要9s多,占用内存也保持在500MB之内4. 游标查询
客户端
JDBC发起SQL查询,等待服务端准备数据。服务端数据准备完成后,进行数据传输,它允许应用程序在数据库服务器上打开一个游标并按需检索数据,而不是一次性获取整个结果集,类似客户端向服务端分批pull的过程。mapper接口层接收参数方式使用Cursor<User>Cursor<User> listUserByCursor();
<select id="listUserByCursor"  fetchSize="-2147483648" resultType="com.sun.ddd.infra.po.User">

    select * from user

</select>
@Test

@Transactional

public void test() {

   StopWatch stopWatch = new StopWatch();

 stopWatch.start("游标查询");

        AtomicInteger totalCountCursor = new AtomicInteger(0);

        Cursor<User> users2 = userService.listUserByCursor();

        for (User user : users2) {

            totalCountCursor.incrementAndGet();

        }

        stopWatch.stop();

        System.out.println(stopWatch.getLastTaskName() + ":" + stopWatch.getLastTaskTimeMillis() + ":代码行数:" + totalCountCursor.get());

    }
由于Cursor是一条条查,所以会关闭会话,需要在方法上加@Transactional即可
游标查询:9813:代码行数:2778523
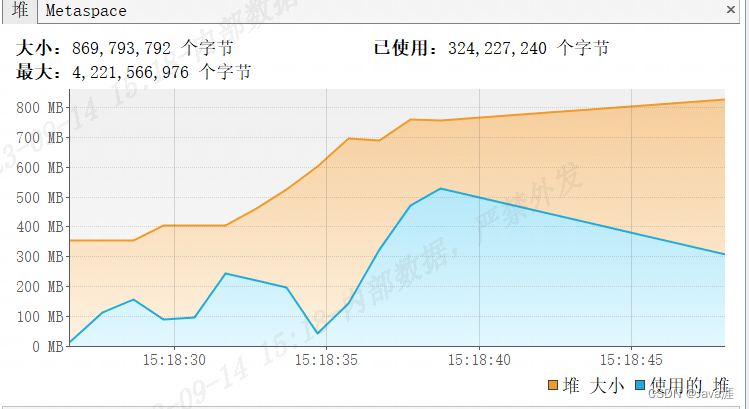
从测试结果来看,查询
200w条数据时间跟流式查询差不多,占用的内存也不到500MB
总结:
| 查询方式 | 数据条数 | 查询时间 | 占用内存 |
|---|---|---|---|
| 全量查询 | 2778523 | 21757 | 1600MB |
| 分页查询 | 1998000 | 285343 | 500MB |
| 流式查询 | 2778523 | 9967 | 450MB |
| 游标查询 | 2778523 | 9813 | 550MB |
推荐使用流式查询,游标查询还跟指定数据库有关
mybatis查询大批量数据的几种方式的更多相关文章
- android sqlite使用之模糊查询数据库数据的三种方式
android应用开发中常常需要记录一下数据,而在查询的时候如何实现模糊查询呢?很少有文章来做这样的介绍,所以这里简单的介绍下三种sqlite的模糊查询方式,直接上代码把: package com.e ...
- mybatis批量添加数据的三种方式
原文地址:https://www.cnblogs.com/gxyandwmm/p/9565002.html
- mybatis中批量插入的两种方式(高效插入)
MyBatis简介 MyBatis是一个支持普通SQL查询,存储过程和高级映射的优秀持久层框架.MyBatis消除了几乎所有的JDBC代码和参数的手工设置以及对结果集的检索封装.MyBatis可以使用 ...
- Linux就这个范儿 第15章 七种武器 linux 同步IO: sync、fsync与fdatasync Linux中的内存大页面huge page/large page David Cutler Linux读写内存数据的三种方式
Linux就这个范儿 第15章 七种武器 linux 同步IO: sync.fsync与fdatasync Linux中的内存大页面huge page/large page David Cut ...
- Solr 删除数据的几种方式
原文出处:http://blog.chenlb.com/2010/03/solr-delete-data.html 有时候需要删除 Solr 中的数据(特别是不重做索引的系统中,在重做索引期间).删除 ...
- 查询json数据结构的8种方式
查询json数据结构的8种方式 你有没有对“在复杂的JSON数据结构中查找匹配内容”而烦恼.这里有8种不同的方式可以做到: JsonSQL JsonSQL实现了使用SQL select语句在json数 ...
- MyBatis开发Dao层的两种方式(原始Dao层开发)
本文将介绍使用框架mybatis开发原始Dao层来对一个对数据库进行增删改查的案例. Mapper动态代理开发Dao层请阅读我的下一篇博客:MyBatis开发Dao层的两种方式(Mapper动态代理方 ...
- MyBatis开发Dao层的两种方式(Mapper动态代理方式)
MyBatis开发原始Dao层请阅读我的上一篇博客:MyBatis开发Dao层的两种方式(原始Dao层开发) 接上一篇博客继续介绍MyBatis开发Dao层的第二种方式:Mapper动态代理方式 Ma ...
- Day20-单表中获取表单数据的3种方式
1. 搭建环境请参考:http://www.cnblogs.com/momo8238/p/7508677.html 2. 创建表结构 models.py from django.db import m ...
- python爬虫---爬虫的数据解析的流程和解析数据的几种方式
python爬虫---爬虫的数据解析的流程和解析数据的几种方式 一丶爬虫数据解析 概念:将一整张页面中的局部数据进行提取/解析 作用:用来实现聚焦爬虫的吧 实现方式: 正则 (针对字符串) bs4 x ...
随机推荐
- TienChin 渠道管理-添加渠道
在我们平时新建一个全新的 Java 类,这个类需要存放的包不存在,可以使用如下的方式进行创建: 含义就是说,将 ChannelVO 这个类放在 vo 这个包当中,如果存在则不创建,存在就将新建的类放入 ...
- 深度学习应用篇-计算机视觉-语义分割综述[5]:FCN、SegNet、Deeplab等分割算法、常用二维三维半立体数据集汇总、前景展望等
深度学习应用篇-计算机视觉-语义分割综述[5]:FCN.SegNet.Deeplab等分割算法.常用二维三维半立体数据集汇总.前景展望等 语义分割综述(semantic segmentation) 1 ...
- 2.4 Windows驱动开发:内核字符串拷贝与比较
在上一篇文章<内核字符串转换方法>中简单介绍了内核是如何使用字符串以及字符串之间的转换方法,本章将继续探索字符串的拷贝与比较,与应用层不同内核字符串拷贝与比较也需要使用内核专用的API函数 ...
- 4.8 C++ Boost 应用JSON解析库
property_tree 是 Boost 库中的一个头文件库,用于处理和解析基于 XML.Json 或者 INFO 格式的数据. property_tree 可以提供一个轻量级的.灵活的.基于二叉数 ...
- RabbitMQ高级知识(消息可靠性,死信交换机,惰性队列,MQ集群)
服务异步通信-高级篇 消息队列在使用过程中,面临着很多实际问题需要思考: 1.消息可靠性 消息从发送,到消费者接收,会经历多个过程: 其中的每一步都可能导致消息丢失,常见的丢失原因包括: 发送时丢失: ...
- Redis安装,数据类型及常用命令
安装 - 可以使用yum 安装,要先配置epel源 ``` yum install -y redis ``` - 可以编译安装 ``` wget http://download.redis.io/re ...
- centos离线安装mongodb-database-tools
mongodb-database-tools是MongoDB数据库工具的命令行的工具,用于工作与MongoDB部署.可以使用mongodump和mongoimport很方便的导入导出备份数据. 该数据 ...
- Ubuntu 23.04 正式发布
Ubuntu 23.04 "Lunar Lobster" 是 Ubuntu 操作系统的最新短期支持版本,该版本将获得 9 个月的支持,直到 2024 年 1 月.如果你需要长期支持 ...
- DevToys(开发工具) v1.0.2.1
从事开发工作的朋友们千万不要错过了!今天为大家带来的这款软件可以说是开发人员的必备工具,它就是DevToys软件!DevToys中包含了许多强大实用的开发工具,能够帮助用户将程序开发变得更加简单大大降 ...
- 【STL源码剖析】list模拟实现 | 适配器实现反向迭代器【超详细的底层算法解释】
今天博主继续带来STL源码剖析专栏的第三篇博客了! 今天带来list的模拟实现!话不多说,直接进入我们今天的内容! 前言 那么这里博主先安利一下一些干货满满的专栏啦! 手撕数据结构https://bl ...