
Python数据分析--------numpy数据打乱
一、shuffle函数:
import numpy.random
def shuffleData(data):
np.random.shufflr(data)
cols=data.shape[1]
X=data[:,0:cols-1]
Y=data[:,cols-1:]
return X,Y
二、np.random.permutation()函数
这个函数的使用来随机排列一个数组的,
一维数组:
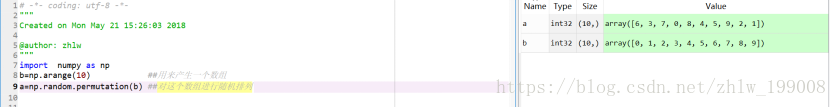
对多维数组来说,是多维随机打乱而不是1维,例如:
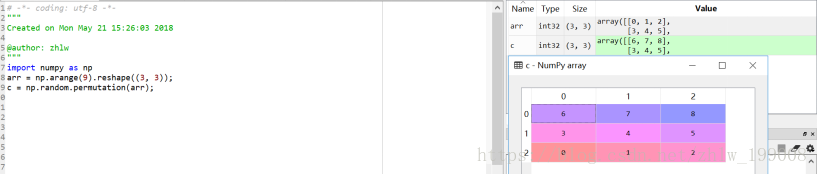
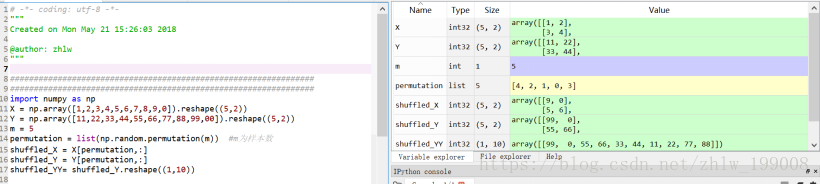
如果要利用次函数对输入数据X、Y进行随机排序,且要求随机排序后的X Y中的值保持原来的对应关系,可以这样处理:
permutation = list(np.random.permutation(m)) #m为样本数
shuffled_X = X[permutation]
shuffled_Y = Y[permutation].reshape((1,m))
图4中的代码是针对一维数组来说的,(图片中右侧为运行结果):
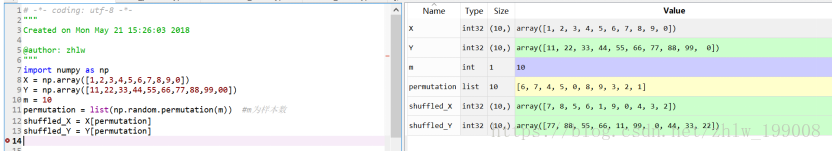
图5中的代码是针对二维数组来说的:
https://blog.csdn.net/zhlw_199008/article/details/80569167
三、sameple函数
sample()参数frac是要返回的比例,比如df中有10行数据,我只想返回其中的30%,那么frac=0.3
以下代码实现了从“CRASHSEV”中选出1,2,3,4的属性,乱序,然后取出前10000行,按行链接成新的数据,重建索引:
def unbanlance(un_data):

    data1 = un_data.loc[(data["CRASHSEV"] == 1)].sample(frac=1).iloc[:10000, :]

    data2 = un_data.loc[(data["CRASHSEV"] == 2)].sample(frac=1).iloc[:10000, :]

    data3 = un_data.loc[(data["CRASHSEV"] == 3)].sample(frac=1).iloc[:10000, :]

    data4 = un_data.loc[(data["CRASHSEV"] == 4)].sample(frac=1).iloc[:10000, :]

    ba_data = pd.concat([data1,data2,data3,data4], axis=0).sample(frac=1).reset_index(drop=True)  #0是按行链接

    return ba_data
Python数据分析--------numpy数据打乱的更多相关文章
- Python数据分析-Numpy数值计算
Numpy介绍: NumPy是高性能科学计算和数据分析的基础包.它是pandas等其他各种工具的基础. NumPy的主要功能: 1)ndarray,一个多维数组结构,高效且节省空间 2)无需循环对整组 ...
- python数据分析笔记——数据加载与整理]
[ python数据分析笔记——数据加载与整理] https://mp.weixin.qq.com/s?__biz=MjM5MDM3Nzg0NA==&mid=2651588899&id ...
- python数据分析Numpy(二)
Numpy (Numerical Python) 高性能科学计算和数据分析的基础包: ndarray,多维数组(矩阵),具有矢量运算能力,快速.节省空间: 矩阵运算,无需循环,可以完成类似Matlab ...
- Python数据分析——numpy基础简介
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:基因学苑 NumPy(Numerical Python的简称)是高性 ...
- python 利用numpy同时打乱列表的顺序,同时打乱数据和标签的顺序
可用于网络训练打乱训练数据个标签,不改变对应关系 方法一: np.random.shuffle (无返回值,直接打乱原列表) state = np.random.get_state() np.rand ...
- Python数据分析--Numpy常用函数介绍(4)--Numpy中的线性关系和数据修剪压缩
摘要:总结股票均线计算原理--线性关系,也是以后大数据处理的基础之一,NumPy的 linalg 包是专门用于线性代数计算的.作一个假设,就是一个价格可以根据N个之前的价格利用线性模型计算得出. 前一 ...
- python 数据分析----numpy
NumPy是高性能科学计算和数据分析的基础包.它是pandas等其他各种工具的基础. NumPy的主要功能: ndarray,一个多维数组结构,高效且节省空间 无需循环对整组数据进行快速运算的数学函数 ...
- Python数据分析numpy库
1.简介 Numpy库是进行数据分析的基础库,panda库就是基于Numpy库的,在计算多维数组与大型数组方面使用最广,还提供多个函数操作起来效率也高 2.Numpy库的安装 linux(Ubuntu ...
- python数据分析 Numpy基础 数组和矢量计算
NumPy(Numerical Python的简称)是Python数值计算最重要的基础包.大多数提供科学计算的包都是用NumPy的数组作为构建基础. NumPy的部分功能如下: ndarray,一个具 ...
随机推荐
- 洛谷 P2144 BZOJ 1003 [FJOI2007]轮状病毒
题目描述 轮状病毒有很多变种.许多轮状病毒都是由一个轮状基产生.一个n轮状基由圆环上n个不同的基原子和圆心的一个核原子构成.2个原子之间的边表示这2个原子之间的信息通道,如图1. n轮状病毒的产生规律 ...
- HDU4565 So Easy!
/* HDU4565 So Easy! http://acm.hdu.edu.cn/showproblem.php?pid=4565 数论 快速幂 矩阵快速幂 题意:求[(a+sqrt(b))^n ] ...
- Windows系统SNMP数据监测与OID
Windows系统SNMP数据监测与OID http://blog.csdn.net/liuhuango123/article/details/52253953
- 使用大白菜U盘进入PE后再次重启电脑会留后门的清理方法
使用大白菜U盘进入PE后再次重启电脑会留后门,这个后门主要是自动下载安装一些软件,比如金山毒霸等. 清除方法: 1.每次用完PE重启前,清理以下地方: ①c:\Windows\xxxxx.exe(查看 ...
- HDU 5358(2015多校联合训练赛第六场1006) First One (区间合并+常数优化)
pid=5358">HDU 5358 题意: 求∑i=1n∑j=in(⌊log2S(i,j)⌋+1)∗(i+j). 思路: S(i,j) < 10^10 & ...
- SQL Server 运行计划操作符具体解释(2)——串联(Concatenation )
本文接上文:SQL Server 运行计划操作符具体解释(1)--断言(Assert) 前言: 依据计划.本文開始讲述另外一个操作符串联(Concatenation).读者能够依据这个词(中英文均可) ...
- @RequiresPermissions 注解说明
@RequiresAuthentication验证用户是否登录,等同于方法subject.isAuthenticated() 结果为true时.@RequiresUser验证用户是否被记忆,user有 ...
- 【翻译自mos文章】 asmcmd cp命令不能拷贝大于2GB的文件。
asmcmd cp命令不能拷贝大于2GB的文件. 參考原文: Asmcmd CP Command Can Not Copy Files Larger Than 2 GB (Doc ID 786258. ...
- struts1——静态ActionForm与动态ActionForm
在struts1中,我们能够使用ActionForm来获取从client端提交上来的数据.并通过action配置中的name属性.将某个ActionForm配置到某次请求应答的Action中.作为本次 ...
- 设计模式C++实现——组合模式
模式定义: 组合模式同意你将对象组合成树形结构来表现"总体/部分"层次结构.组合能让客户以一致的方式处理个别对象以及对象组合. 这个模式可以创建一个树形结构,在同一个结构中处理嵌套 ...