
(七)Transformation和action详解-Java&Python版Spark
Transformation和action详解
视频教程:
1、优酷
2、YouTube
什么是算子
算子是RDD中定义的函数,可以对RDD中的数据进行转换和操作。
算子分类:
具体:
1、Value数据类型的Transformation算子,这种变换并不触发提交作业,针对处理的数据项是Value型的数据。
2、Key-Value数据类型的Transfromation算子,这种变换并不触发提交作业,针对处理的数据项是Key-Value型的数据对。
3、Action算子,这类算子会触发SparkContext提交Job作业。
RDD有两种操作算子:
1、Transformation(转换)
2、Ation(执行)
作用
1、transformation是得到一个新的RDD,方式很多,比如从数据源生成一个新的RDD,从RDD生成一个新的RDD,Transformation属于延迟计算,当一个RDD转换成另一个RDD时并没有立即进行转换,仅仅是记住了数据集的逻辑操作。
2、action是得到一个值,或者一个结果(直接将RDDcache到内存中),触发Spark作业的运行,真正触发转换算子的计算。
所有的transformation都是采用的懒策略,如果只是将transformation提交是不会执行计算的,计算只有在action被提交的时候才被触发。
下图描述了Spark在运行转换中通过算子对RDD进行转换:
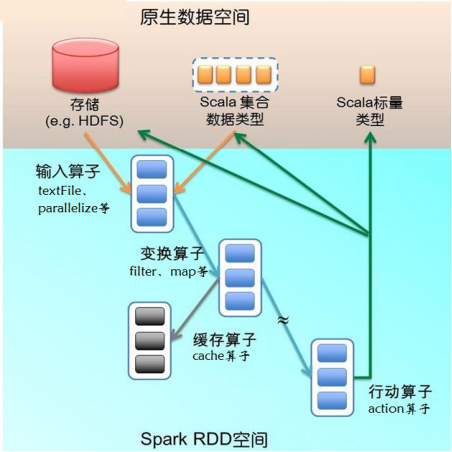
输入:在Spark程序运行中,数据从外部数据空间(如分布式存储:textFile读取HDFS等,parallelize方法输入Scala集合或数据)输入Spark,数据进入Spark运行时数据空间,转化为Spark中的数据块,通过BlockManager进行管理。
运行:在Spark数据输入形成RDD后便可以通过变换算子,如filter等,对数据进行操作并将RDD转化为新的RDD,通过Action算子,触发Spark提交作业。 如果数据需要复用,可以通过Cache算子,将数据缓存到内存。
输出:程序运行结束数据会输出Spark运行时空间,存储到分布式存储中(如saveAsTextFile输出到HDFS),或Scala数据或集合中(collect输出到Scala集合,count返回Scala int型数据)。
Transformation和Actions操作概况
Transformation具体内容
1、map(func) :返回一个新的分布式数据集,由每个原元素经过func函数转换后组成。
2、filter(func) : 返回一个新的数据集,由经过func函数后返回值为true的原元素组成 。
3、flatMap(func) : 类似于map,但是每一个输入元素,会被映射为0到多个输出元素(因此,func函数的返回值是一个Seq,而不是单一元素)。
4、sample(withReplacement, frac, seed) : 根据给定的随机种子seed,随机抽样出数量为frac的数据。
5、union(otherDataset) : 返回一个新的数据集,由原数据集和参数联合而成。
6、groupByKey([numTasks]) : 在一个由(K,V)对组成的数据集上调用,返回一个(K,Seq[V])对的数据集。注意:默认情况下,使用8个并行任务进行分组,你可以传入numTask可选参数,根据数据量设置不同数目的Task。
7、reduceByKey(func, [numTasks]) : 在一个(K,V)对的数据集上使用,返回一个(K,V)对的数据集,key相同的值,都被使用指定的reduce函数聚合到一起。和groupbykey类似,任务的个数是可以通过第二个可选参数来配置的。
8、join(otherDataset, [numTasks]) : 在类型为(K,V)和(K,W)类型的数据集上调用,返回一个(K,(V,W))对,每个key中的所有元素都在一起的数据集。
9、groupWith(otherDataset, [numTasks]) : 在类型为(K,V)和(K,W)类型的数据集上调用,返回一个数据集,组成元素为(K, Seq[V], Seq[W]) Tuples。
10、cartesian(otherDataset) : 笛卡尔积。但在数据集T和U上调用时,返回一个(T,U)对的数据集,所有元素交互进行笛卡尔积。
Actions具体内容
1、reduce(func) : 通过函数func聚集数据集中的所有元素。Func函数接受2个参数,返回一个值。这个函数必须是关联性的,确保可以被正确的并发执行。
2、collect() : 在Driver的程序中,以数组的形式,返回数据集的所有元素。这通常会在使用filter或者其它操作后,返回一个足够小的数据子集再使用,直接将整个RDD集Collect返回,很可能会让Driver程序OOM。
3、count() : 返回数据集的元素个数。
4、take(n) : 返回一个数组,由数据集的前n个元素组成。注意,这个操作目前并非在多个节点上,并行执行,而是Driver程序所在机器,单机计算所有的元素内存压力会增大,需要谨慎使用。
5、first() : 返回数据集的第一个元素(类似于take(1))。
6、saveAsTextFile(path) : 将数据集的元素,以textfile的形式,保存到本地文件系统,hdfs或者任何其它hadoop支持的文件系统。Spark将会调用每个元素的toString方法,并将它转换为文件中的一行文本。
7、saveAsSequenceFile(path) : 将数据集的元素,以sequencefile的格式,保存到指定的目录下,本地系统,hdfs或者任何其它hadoop支持的文件系统。RDD的元素必须由key-value对组成,并都实现了Hadoop的Writable接口,或隐式可以转换为Writable(Spark包括了基本类型的转换,例如Int,Double,String等等)。
8、foreach(func) : 在数据集的每一个元素上,运行函数func。这通常用于更新一个累加器变量,或者和外部存储系统做交互。
(七)Transformation和action详解-Java&Python版Spark的更多相关文章
- (八)map,filter,flatMap算子-Java&Python版Spark
map,filter,flatMap算子 视频教程: 1.优酷 2.YouTube 1.map map是将源JavaRDD的一个一个元素的传入call方法,并经过算法后一个一个的返回从而生成一个新的J ...
- sparkStreaming的transformation和action详解
根据Spark官方文档中的描述,在Spark Streaming应用中,一个DStream对象可以调用多种操作,主要分为以下几类 Transformations Window Operations J ...
- (一)Spark简介-Java&Python版Spark
Spark简介 视频教程: 1.优酷 2.YouTube 简介: Spark是加州大学伯克利分校AMP实验室,开发的通用内存并行计算框架.Spark在2013年6月进入Apache成为孵化项目,8个月 ...
- (四)Spark集群搭建-Java&Python版Spark
Spark集群搭建 视频教程 1.优酷 2.YouTube 安装scala环境 下载地址http://www.scala-lang.org/download/ 上传scala-2.10.5.tgz到m ...
- (二)Spark-Linux环境准备-Java&Python版Spark
Spark-Linux环境准备 视频教程: 1.优酷 2.YouTube 硬软件环境 1.虚拟机:VMware Workstation 12 2.虚拟机操作系统:RedHat5u4,单核,1G内存,2 ...
- (九)groupByKey,reduceByKey,sortByKey算子-Java&Python版Spark
groupByKey,reduceByKey,sortByKey算子 视频教程: 1.优酷 2. YouTube 1.groupByKey groupByKey是对每个key进行合并操作,但只生成一个 ...
- (三)Spark-Hadoop集群搭建-Java&Python版Spark
Spark-Hadoop集群搭建 视频教程: 1.优酷 2.YouTube 配置java 启动ftp [root@master ~]# /etc/init.d/vsftpd restart 关闭 vs ...
- “全栈2019”Java第七十章:静态内部类详解
难度 初级 学习时间 10分钟 适合人群 零基础 开发语言 Java 开发环境 JDK v11 IntelliJ IDEA v2018.3 文章原文链接 "全栈2019"Java第 ...
- Protocol Buffer技术详解(Java实例)
Protocol Buffer技术详解(Java实例) 该篇Blog和上一篇(C++实例)基本相同,只是面向于我们团队中的Java工程师,毕竟我们项目的前端部分是基于Android开发的,而且我们研发 ...
随机推荐
- Leetcode 笔记 113 - Path Sum II
题目链接:Path Sum II | LeetCode OJ Given a binary tree and a sum, find all root-to-leaf paths where each ...
- 遍历dynamic的方式
一.遍历ExpandoObject /// <summary> /// 遍历ExpandoObject /// </summary> [TestMethod] public v ...
- CocoaPods 1.1.0上传遇到swift问题
更新时间: 2016-11-25 1.出现如下信息: Conn keep-alive Updating spec repo `master` - Data URL: https://raw.githu ...
- 如何通过源生js获取一个元素的具体样式值 /* getCss:获取指定元素的具体样式的属性值 curElement:[dom对象] attr:[string] */
昨天的博客些的真的是惨不忍睹啊!!!但是我的人生宗旨就是将不要脸的精神进行到底,所以,今天我又来了.哈哈哈哈哈! 方法一:元素.style.属性名:(这个有局限性--只能获取行内样式的值,对于样式表或 ...
- 1. SVM简介
从这一部分开始,将陆续介绍SVM的相关知识,主要是整理以前学习的一些笔记内容,梳理思路,形成一套SVM的学习体系. 支持向量机(Support Vector Machine)是Cortes和Vapni ...
- 前端学HTTP之摘要认证
前面的话 上一篇介绍的基本认证便捷灵活,但极不安全.用户名和密码都是以明文形式传送的,也没有采取任何措施防止对报文的篡改.安全使用基本认证的唯一方式就是将其与SSL配合使用 摘要认证与基本认证兼容,但 ...
- GIS部分理论知识备忘随笔
文章版权由作者李晓晖和博客园共有,若转载请于明显处标明出处:http://www.cnblogs.com/naaoveGIS/ 1.高斯克吕格投影带换算 某坐标的经度为112度,其投影的6度带和3度带 ...
- 关于join时显示no join predicate的那点事
我们偶尔,非常偶尔的情况下会在一个查询计划中看到这样的警告: 大红叉,好吓人啊! 把鼠标放上去一看显示这样的信息 No join predicate 直译过来就是:没有连接谓词 在真实的生产环境下我们 ...
- 让BASH,VIM美美的Powerline
前言 鉴于BASH及其周边强大的工具以及VIM高效快捷,加上现在我工作重心转移到前端开发上,因此我华丽地转向Linux阵营(当然从最傻瓜式的Ubuntu开始啦!).但BASH和VIM默认样式确实颜值 ...
- 线程安全性:num++操作为什么也会出问题?
线程的安全性可能是非常复杂的,在没有充足同步的情况下,由于多个线程中的操作执行顺序是不可预测的,甚至会产生奇怪的结果(非预期的).下面的Tools工具类的plus方法会使计数加一,为了方便,这里的nu ...