Spark数据本地化-->如何达到性能调优的目的

1.Spark数据的本地化:移动计算,而不是移动数据

2.Spark中的数据本地化级别:

TaskSetManager 的 Locality Levels 分为以下五个级别:
PROCESS_LOCAL
 NODE_LOCAL
NO_PREF
   RACK_LOCAL
ANY
    
PROCESS_LOCAL   进程本地化:task要计算的数据在同一个Executor中


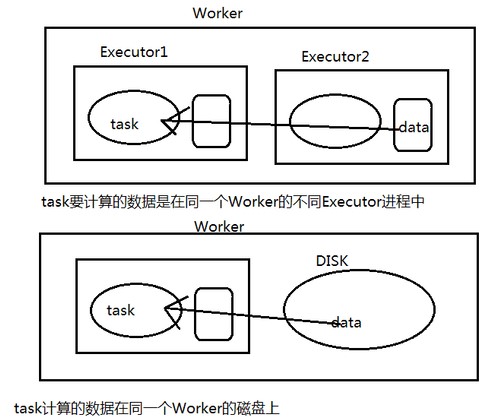
    NODE_LOCAL    节点本地化:速度比 PROCESS_LOCAL 稍慢,因为数据需要在不同进程之间传递或从文件中读取
                                        情况一:task要计算的数据是在同一个Worker的不同Executor进程中
                                        情况二:task要计算的数据是在同一个Worker的磁盘上,或在 HDFS 上,恰好有 block 在同一个节点上。
                                 Spark计算数据来源于HDFS,那么最好的数据本地化级别就是NODE_LOCAL


    NODE_PREF    没有最佳位置这一说,数据从哪里访问都一样快,不需要位置优先。比如说SparkSQL读取MySql中的数据
 
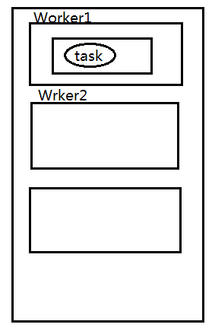
    RACK_LOCAL 机架本地化,数据在同一机架的不同节点上。需要通过网络传输数据及文件 IO,比 NODE_LOCAL 慢
                                         情况一:task计算的数据在Worker2的Executor中
                                         情况二:task计算的数据在Worker2的磁盘上
 
    ANY   跨机架,数据在非同一机架的网络上,速度最慢
            

3.Spark中的数据本地化由谁负责?

        DAGScheduler,TaskScheduler
 
            val rdd1 = rdd1.cache
            rdd1.map.filter.count()
            Driver(TaskScheduler)在发送task之前,首先应该拿到RDD1缓存在哪一些节点上(node1,node2)-->这一步就是由DAGScheduler通过cacheManager对象调用getPreferredLocations()来拿到RDD1缓存在哪些节点上,TaskScheduler根据这些节点来发送task。
 
            val rdd1 = sc.textFile("hdfs://...")    //rdd1中封装了是这个文件所对应的block的位置,getPreferredLocation()-->TaskScheduler调用拿到partition所对应的数据的位置
            rdd1.map.filter.count()
            Driver(TaskScheduler)在发送task之前,首先应该拿到rdd1数据所在的位置(node1,node2)-->RDD1封装了这个文件所对应的block的位置,TaskScheduler通过调用getPreferredLocations()拿到partition所对应的数据的位置,TaskScheduler根据这些位置来发送相应的task
 
    总的来说:
      Spark中的数据本地化由DAGScheduler和TaskScheduler共同负责。
      DAGScheduler切割Job,划分Stage, 通过调用submitStage来提交一个Stage对应的tasks,submitStage会调用submitMissingTasks,submitMissingTasks 确定每个需要计算的 task 的preferredLocations,通过调用getPreferrdeLocations()得到partition 的优先位置,就是这个 partition 对应的 task 的优先位置,对于要提交到TaskScheduler的TaskSet中的每一个task,该task优先位置与其对应的partition对应的优先位置一致。
      TaskScheduler接收到了TaskSet后,TaskSchedulerImpl 会为每个 TaskSet 创建一个 TaskSetManager 对象,该对象包含taskSet 所有 tasks,并管理这些 tasks 的执行,其中就包括计算 TaskSetManager 中的 tasks 都有哪些locality levels,以便在调度和延迟调度 tasks 时发挥作用。

4.Spark中的数据本地化流程图

即某个 task 计算节点与其输入数据的位置关系,下面将要挖掘Spark 的调度系统如何产生这个结果,这一过程涉及 RDD、DAGScheduler、TaskScheduler,搞懂了这一过程也就基本搞懂了 Spark 的 PreferredLocations(位置优先策略)
 
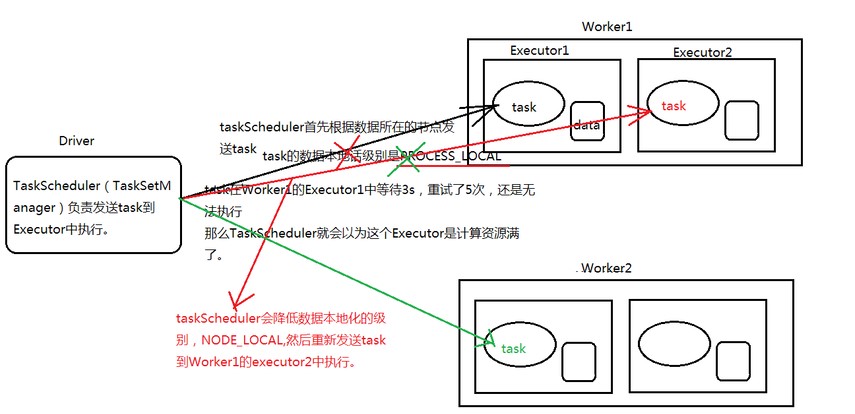
   第一步:PROCESS_LOCAL-->TaskScheduler首先根据数据所在的节点发送task,
如果task在Worker1的Executor1中等待了3s(这个3s是spark的默认等待时间,通过spark.locality.wait来设置,可以在SparkConf()中修改),重试了5次,还是无法执行
 
   TaskScheduler会降低数据本地化的级别,从PROCESS_LOCAL降到NODE_LOCAL
 
   第二步:NODE_LOCAL-->TaskScheduler重新发送task到Worker1中的Executor2中执行,
如果task在Worker1的Executor2中等待了3s,重试了5次,还是无法执行
 
   TaskScheduler会降低数据本地化的级别,从NODE_LOCAL降到RACK_LOCAL 
 
   第三步:RACK_LOCAL -->TaskScheduler重新发送task到Worker2中的Executor1中执行。
 
   第四步:当task分配完成之后,task会通过所在Worker的Executor中的BlockManager来获取数据,如果BlockManager发现自己没有数据,那么它会调用getRemote()方法,通过ConnectionManager与原task所在节点的BlockManager中的ConnectionManager先建立连接,然后通过TransferService(网络传输组件)获取数据,通过网络传输回task所在节点(这时候性能大幅下降,大量的网络IO占用资源),计算后的结果返回给Driver。
 
总结:
   TaskScheduler在发送task的时候,会根据数据所在的节点发送task,这时候的数据本地化的级别是最高的,如果这个task在这个Executor中等待了三秒,重试发射了5次还是依然无法执行,那么TaskScheduler就会认为这个Executor的计算资源满了,TaskScheduler会降低一级数据本地化的级别,重新发送task到其他的Executor中执行,如果还是依然无法执行,那么继续降低数据本地化的级别...
 
    现在想让每一个task都能拿到最好的数据本地化级别,那么调优点就是等待时间加长。注意!如果过度调大等待时间,虽然为每一个task都拿到了最好的数据本地化级别,但是我们job执行的时间也会随之延长
  1. spark.locality.wait 3s//相当于是全局的,下面默认以3s为准,手动设置了,以手动的为准
  2. spark.locality.wait.process
  3. spark.locality.wait.node
  4. spark.locality.wait.rack
  5. newSparkConf.set("spark.locality.wait","100")
 

Spark数据本地化-->如何达到性能调优的目的的更多相关文章

  1. Spark SQL概念学习系列之性能调优

    不多说,直接上干货! 性能调优 Caching Data In Memory Spark SQL可以通过调用sqlContext.cacheTable("tableName") 或 ...

  2. Spark(十二)--性能调优篇

    一段程序只能完成功能是没有用的,只能能够稳定.高效率地运行才是生成环境所需要的. 本篇记录了Spark各个角度的调优技巧,以备不时之需. 一.配置参数的方式和观察性能的方式 额...从最基本的开始讲, ...

  3. [Spark性能调优] 第一章:性能调优的本质、Spark资源使用原理和调优要点分析

    本課主題 大数据性能调优的本质 Spark 性能调优要点分析 Spark 资源使用原理流程 Spark 资源调优最佳实战 Spark 更高性能的算子 引言 我们谈大数据性能调优,到底在谈什么,它的本质 ...

  4. [Spark性能调优] 第二章:彻底解密Spark的HashShuffle

    本課主題 Shuffle 是分布式系统的天敌 Spark HashShuffle介绍 Spark Consolidated HashShuffle介绍 Shuffle 是如何成为 Spark 性能杀手 ...

  5. [Spark性能调优] 第三章 : Spark 2.1.0 中 Sort-Based Shuffle 产生的内幕

    本課主題 Sorted-Based Shuffle 的诞生和介绍 Shuffle 中六大令人费解的问题 Sorted-Based Shuffle 的排序和源码鉴赏 Shuffle 在运行时的内存管理 ...

  6. [Spark性能调优] 第四章 : Spark Shuffle 中 JVM 内存使用及配置内幕详情

    本课主题 JVM 內存使用架构剖析 Spark 1.6.x 和 Spark 2.x 的 JVM 剖析 Spark 1.6.x 以前 on Yarn 计算内存使用案例 Spark Unified Mem ...

  7. [Spark性能调优] 源码补充 : Spark 2.1.X 中 Unified 和 Static MemoryManager

    本课主题 Static MemoryManager 的源码鉴赏 Unified MemoryManager 的源码鉴赏 引言 从源码的角度了解 Spark 内存管理是怎么设计的,从而知道应该配置那个参 ...

  8. Spark性能调优之资源分配

    Spark性能调优之资源分配    性能优化王道就是给更多资源!机器更多了,CPU更多了,内存更多了,性能和速度上的提升,是显而易见的.基本上,在一定范围之内,增加资源与性能的提升,是成正比的:写完了 ...

  9. 【原创】SQL Server 性能调优读书笔记

    CPU 100%: 有时可能是硬盘性能不足,或者内存容量不够,让CPU一直忙于I/O. 导致性能问题的一些因素: 用户习惯:在运行尖峰时刻做一些不必做但消耗资源的事情,如之行数据库完整备份,如在服务器 ...

随机推荐

  1. DELPHI中多线程知识【转】

    本文的内容取自网络,并重新加以整理,在此留存仅仅是方便自己学习和查阅.所有代码均亲自测试 delphi7下测试有效.图片均为自己制作. 多线程应该是编程工作者的基础技能, 但这个基础我从来没学过,所以 ...

  2. js连接sqlserver进行查询

    <script language="JavaScript"> // 创建数据库对象 var objdbConn = new ActiveXObject("AD ...

  3. MVC下form表单一次上传多种类型的图片(每种类型的图片可以上传多张)

    form表单一次上传多种类型的图片(每种类型的图片可以上传多张) controller中的action方法 public ActionResult UploadImage( )        { in ...

  4. CentOS7系统安装DNS服务

    CentOS7系统安装DNS服务 30.1.DNS是什么? DNS ( Domain Name System )是"域名系统"的英文缩写,简单来说就是一个数据库,用于存储网络中IP ...

  5. Java内存回收优化及配置

    原文链接:http://eol.cqu.edu.cn/eol/jpk/course/preview/jpkmaterials_folder_txtrtfview.jsp?resId=23156& ...

  6. ubuntu 压缩软件

    7-zip 安装: sudo apt-get install p7zip-full 使用方法: 7z x file file是你要解压的文件名 更多使用方法: man 7z rar sudo apt- ...

  7. Scrollview回弹效果自定义控件

    滚动回弹效果分析: 首先,创建一个类,继承scrollview,重写ontouch事件,实现伸缩回弹效果. [scroollview节点下只能有一个子节点,这个子节点就是我们要移动的view布局]   ...

  8. removeAll

    问题:无法移除2个集合中相同元素 方法:移除所包含的其所有元素. 在执行removeAll方法时,会先对集合元素进行比较,如果元素相等才执行移除操作,说到这,相信很多人都已经明白是怎么回事了,因为不相 ...

  9. GoldenGate 传统抽取进程的 ADG 模式

    :first-child { margin-top: 0; } blockquote > :last-child { margin-bottom: 0; } img { border: 0; m ...

  10. use vue vuex vue-router, not use webpack

    vue,vuex,vue-router放在一起能做什么?不用webpack之类的打包工具使用他们是否可行?各位道友在初学vue时是否有这样的困惑.因为现代构建前端项目的一般模式是: 安装webapck ...