
图的最小生成树(Prim、Kruskal)
理论:
Prim:
基本思想:假设G=(V,E)是连通的,TE是G上最小生成树中边的集合。算法从U={u0}(u0∈V)、TE={}开始。重复执行下列操作:
在所有u∈U,v∈V-U的边(u,v)∈E中找一条权值最小的边(u0,v0)并入集合TE中,同时v0并入U,直到V=U为止。
此时,TE中必有n-1条边,T=(V,TE)为G的最小生成树。
Prim算法的核心:始终保持TE中的边集构成一棵生成树。

Kruskal:
假设连通网N=(V,{E})。则令最小生成树的初始状态为只有n个顶点而无边的非连通图T=(V,{}),图中每个顶点自成一个连通分量。
在E中选择最小代价的边,若该边依附的顶点落在T中不同的连通分量中,则将该边加入到T中,否则舍去此边而选择下一条代价最小的边,依次类推,直到T中所有顶点都在同一连通分量上为止。
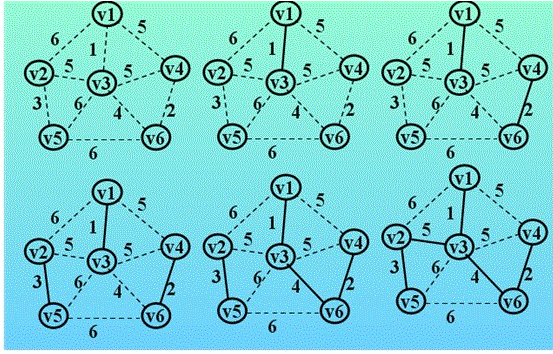
两者比较;
prim算法适合稠密图,其时间复杂度为O(n^2),其时间复杂度与边得数目无关,而kruskal算法的时间复杂度为O(eloge)跟边的数目有关,适合稀疏图。
java实现
Vertex.java
package 图;

public class Vertex{

    String value;

    boolean isVisited;

    Vertex(String value)

    {

        this.value=value;

        this.isVisited=false;

    }

    public String getValue() {

        return value;

    }

    public void setValue(String value) {

        this.value = value;

    }

    public boolean isVisited() {

        return isVisited;

    }

    public void setVisited(boolean isVisited) {

        this.isVisited = isVisited;

    }

}
Edge.java
package 图;

public class Edge{

    Vertex start;

    Vertex end;

    int value;

    public Vertex getStart() {

        return start;

    }

    public void setStart(Vertex start) {

        this.start = start;

    }

    public Vertex getEnd() {

        return end;

    }

    public void setEnd(Vertex end) {

        this.end = end;

    }

    public int getValue() {

        return value;

    }

    public void setValue(int value) {

        this.value = value;

    }

    Edge(Vertex start,Vertex end, int value){

        this.start=start;

        this.end=end;

        this.value=value;

    }

}
Graph.java
    package 图;

    import java.util.ArrayList;

    import java.util.Collections;

    import java.util.Comparator;

    import java.util.Iterator;

    import java.util.List;

    import java.util.Stack;

    public class Graph {

        public static List<Vertex> vertexList=new ArrayList<Vertex>();

        public static List<Edge> EdgeQueue=new ArrayList<Edge>();

        public static List<Vertex> newVertex=new ArrayList<Vertex>();

        public static List<Edge> newEdge=new ArrayList<Edge>();

        public static void buildGraph(){

            Vertex a=new Vertex("a");

            vertexList.add(a);

            Vertex b=new Vertex("b");

            vertexList.add(b);

            Vertex c=new Vertex("c");

            vertexList.add(c);

            Vertex d=new Vertex("d");

            vertexList.add(d);

            Vertex e=new Vertex("e");

            vertexList.add(e);

            Vertex f=new Vertex("f");

            vertexList.add(f);

            addEdge(a, b, 3);

            addEdge(a, e, 6);

            addEdge(a, f, 5);

            addEdge(b, a, 3);

            addEdge(b, c, 1);

            addEdge(b, f, 4);

            addEdge(c, b, 1);

            addEdge(c, d, 6);

            addEdge(c, f, 4);

            addEdge(d, c, 6);

            addEdge(d, f, 5);

            addEdge(d, e, 8);

            addEdge(e, d, 8);

            addEdge(e, f, 2);

            addEdge(e, a, 6);

            addEdge(f, a, 5);

            addEdge(f, b, 4);

            addEdge(f, c, 4);

            addEdge(f, d, 5);

            addEdge(f, e, 2);

        }

        public static void addEdge(Vertex start,Vertex end,int value){

            Edge e=new Edge(start,end,value);

            EdgeQueue.add(e);

        }

        public static boolean containVertex(Vertex v){

            for(Vertex each:newVertex)

            {

                if(each.value.equals(v.value))

                    return true;

            }

            return false;

        }

        public static void prim(){

            buildGraph();

            Vertex start=vertexList.get(0);

            newVertex.add(start);

            for(int i=0; i<vertexList.size(); i++)

            {

                Vertex temp=new Vertex(start.value);

                Edge tempEdge=new Edge(start, start, 1000);

                for(Vertex v:newVertex)

                {

                    for(Edge e:EdgeQueue)

                    {

                        if(e.start==v && !containVertex(e.end))

                        {

                            if(tempEdge.value>e.value)

                            {

                                tempEdge=e;

                                temp=e.end;

                            }

                        }

                    }

                }

                newVertex.add(temp);

            }

            Iterator<Vertex>i=newVertex.iterator();

            while(i.hasNext())

            {

                Vertex v=i.next();

                System.out.print(v.value+" ");

            }

        }

        public static void kruskal(){

            buildGraph();

            sort();

        }

        public static void sort(){

            Comparator<Edge>comparator=new Comparator<Edge>(){

                @Override

                public int compare(Edge e1, Edge e2) {

                    // TODO Auto-generated method stub

                    return e1.getValue()-e2.getValue();

                }

            };

            Collections.sort(EdgeQueue,comparator);

        }

        public static void main(String[] args) {

               prim();

        }

    }
图的最小生成树(Prim、Kruskal)的更多相关文章
- 最小生成树 Prim Kruskal
layout: post title: 最小生成树 Prim Kruskal date: 2017-04-29 tag: 数据结构和算法 --- 目录 TOC {:toc} 最小生成树Minimum ...
- 邻接矩阵c源码(构造邻接矩阵,深度优先遍历,广度优先遍历,最小生成树prim,kruskal算法)
matrix.c #include <stdio.h> #include <stdlib.h> #include <stdbool.h> #include < ...
- 数据结构学习笔记05图(最小生成树 Prim Kruskal)
最小生成树Minimum Spanning Tree 一个有 n 个结点的连通图的生成树是原图的极小连通子图,且包含原图中的所有 n 个结点,并且有保持图连通的最少的边. 树: 无回路 |V|个顶 ...
- 布线问题 最小生成树 prim + kruskal
1 : 第一种 prime 首先确定一个点 作为已经确定的集合 , 然后以这个点为中心 , 向没有被收录的点 , 找最短距离( 到已经确定的点 ) , 找一个已知长度的最小长度的 边 加到 s ...
- 图的最小生成树prim算法模板
用prim算法构建最小生成树适合顶点数据较少而边较多的图(稠密图) prim算法生成连通图的最小生成树模板伪代码: G为图,一般为全局变量,数组d为顶点与集合s的最短距离 Prim(G, d[]){ ...
- POJ 1258 Agri-Net(最小生成树 Prim+Kruskal)
题目链接: 传送门 Agri-Net Time Limit: 1000MS Memory Limit: 10000K Description Farmer John has been elec ...
- 图的最小生成树——Prim算法
Prim算法 Prim算法求最小生成树是采取蓝白点的思想,白点代表已经加入最小生成树的点,蓝点表示未加入最小生成树的点. 进行n次循环,每次循环把一个蓝点变为白点,该蓝点应该是与白点相连的最小边权的是 ...
- 最小生成树-Prim&Kruskal
Prim算法 算法步骤 S:当前已经在联通块中的所有点的集合 1. dist[i] = inf 2. for n 次 t<-S外离S最近的点 利用t更新S外点到S的距离 st[t] = true ...
- 邻接表c源码(构造邻接矩阵,深度优先遍历,广度优先遍历,最小生成树prim,kruskal算法)
graph.c #include <stdio.h> #include <stdlib.h> #include <limits.h> #include " ...
随机推荐
- laravel-模板引擎Blade
(慕课网_轻松学会Laravel-基础篇_天秤vs永恒老师) 一.概述 Blade是Laravel提供的一个既简单又强大的模板引擎 和其他流行的PHP模板引擎不一样,Blade并不限制你在视图view ...
- jps命令使用
jps工具 jps(Java Virtual Machine Process Status Tool)是JDK 1.5提供的一个显示当前全部java进程pid的命令,简单有用,很适合在linux/un ...
- winzip15.0注冊码
username:Juzhaofeng 授权码:MPZRP-Y7LWW-K1DKG-FM92E-2C5F5-ZEKFF
- c语言学习之结构篇代码演示样例-输入n个同学的姓名,数学英语成绩,依照平均分从低到高排序并输出
#include<stdio.h> void main(){ const int count = 5;//定义数量 struct student{ char name[80]; float ...
- c/c++ 复习基础要点01-const指针、指针函数 函数指针、new/delete与malloc/free区别与联系
1. 引用本身是有指针实现的:引用为只读指针 例子: int d=123; int& e=d; //引用 int * const e=d; //只读指针,e指向d,不可修改e指 ...
- (转)Windows Server 2008 默认"照片库查看器" 无法打开图片, 只能用画图程序打开
1.解决[启用Win2008照片查看器] Win2008 中放了一些图片,本来以为可以象Win7那样直接用“照片查看器”打开,可是Win2008默认竟然是用“画图”打开的,非常不方便. 再仔细一看,“ ...
- Javscript中的null和undefined
1.null是JavaScript关键字,含义是“非对象”,它可以表示数字.字符串和对象是“无值”的. var x = null; typeof x ;//返回“object” var x=null, ...
- web 调用OPC HRESULT:0x80070005 (E_ACCESSDENIED))
除了配置DCOM外,还需要在web.config里面添加设置系统管理员权限的帐号和密码<identity impersonate="true" userName=" ...
- (转) Resource file and Source file
基本上是这样的,Sourcefile文件夹里面放的是CPP文件这些,Resourcefile文件夹是资源文件夹,里面可以放你程序里需要的资源,包括图标,对话框,图片等等:对应的文件如下: Source ...
- Mysql存储过程分析
为了搞明白为什么mysql的存储过程是高效的,我们需要理解mysql的执行流程是什么,当输入sql语句之后,mysql会先进行sql语句语法正确性检查,然后再进行编译,然后才执行,最后把结果返回.如下 ...