
JVM内存垃圾回收方法
概要:
why:为什么回收,见what
what:垃圾回收哪些内存(不可达对象的确定)
when:何时执行GC(安全点、安全区域)
how:如何回收(原理——垃圾回收算法、实现——垃圾收集器)
1、垃圾回收哪些内存
JVM运行时数据区中,线程私有的程序计数器、虚拟机栈、本地方法栈随线程的创建和退出而自动产生和销毁,不需要垃圾回收;而对于方法区和堆区,由于是随虚拟机的启动和退出而创建和销毁,在这期间被各线程共享,若不回收垃圾以腾出空间则最终会耗尽这两部分空间。因此,JVM垃圾回收的是共享区域的内存,主要是方法区和Java堆内存的回收。
1.1、方法区
方法区的垃圾收集主要是回收废弃常量和无用的类(卸载类)。回收废弃常量与下面将介绍的回收Java堆中的对象很相似,而判定“无用的类”需同时满足三个条件:
1、该类所有实例已被回收,即Java堆中无该类的任何实例。(下层)
2、该类对应的java.lang.Class对象没有在任何地方被引用,无在任何地方通过反射访问该类的方法。(下层)
3、加载该类的ClassLoader已被回收。(上层)
java 8提供了-xx:MetaspaceSize来设置触发元空间垃圾回收的阈值。
1.2、堆
Java堆里面存放着几乎所有的对象实例,垃圾收集器对堆进行回收前,首先要做的就是确定哪些对象可以作为垃圾回收。
JDK1.2后,Java对引用概念进行了扩充,将引用分为强引用(Strong Reference)、软引用(Soft Reference)、弱引用(Weak Reference)、虚引用(Phantom Reference)。被强引用的对象(我们通常所用的对象就是强引用的)一定不会被回收,被其他引用的对象却可能被回收。
总的来说,回收的堆对象有两类:
1、有被引用的对象:即被软引用、弱引用、虚引用所引用的对象可能被当垃圾回收。
1、软引用:软引用对象在系统将要发生内存耗尽(OOM)前会被回收
2、弱引用:弱引用对象只能躲过一次垃圾回收,躲过一次后就被回收
3、虚引用:虚引用对象肯定会被回收,一个对象是否有虚引用完全不会对其生存时间构成影响,也无法通过虚引用来取得一个对象实例,对象被设置成虚引用关联的唯一作用是在对象被垃圾收集时收到一个系统通知。
2、无被引用的对象:需要检查哪些对象已死(没被引用),主要有两种算法检测(3.1节详述具体实现):
1、引用计数法:对象有个计数器记录被引用的个数,为0者可被回收。采用此法的有微软的COM技术、使用ActionScript3的FlashPlayer、Python等。此法存在对象间循环引用的问题导致对象不能被回收。
2、可达性分析法:主流Java虚拟机采用此法。选取一系列GC Roots对象作为起点分析引用链确定不可达对象。采用此法的有Java、C#、Lisp等。对于不可达的对象,如果其覆盖了finalize()方法并且没被执行过,则在JVM对之回收前其有一次逃过被回收的机会。如下:JVM将该对象放入F-Queue队列,并由虚拟机自动建立的、低优先级的Finalizer线程稍后去执行它。若finalize()里此对象又被成员变量(类变量或实例变量)引用,则此对象复活,不会被回收;否则被回收。
2、垃圾回收算法
垃圾回收算法(概述):
- 复制算法:时间效率较高、空间利用率低、不会产生空间碎片。主要操作是复制“活对象”,故适合于每次回收时大量对象死去只有少量存活的情况(年轻代)
- 标记-清除算法:时间效率低、空间利用率高、会产生空间碎片。主要操作是清除“死对象”,故适合于回收时大量对象仍存活只有少数死去的情况(老年代)
- 标记-整理算法。时间效率低、空间利用率高、不会产生空间碎片。适用情况同上
- 分代收集算法:就是上面几种用在堆的不同的分代区域中。年轻代:复制算法;老年代:标记-清除算法、标记-整理算法。
下面详述。
2.1、复制算法
将内存分为两等块,每次使用其中一块。当这一块内存用完后,就将还存活的对象复制到另外一个块上,然后再把已使用过的内存空间一次清理掉。示例:

说明:适合于每次回收时大量对象死去只有少量存活的情况,如年轻代中。1、无内存碎片问题,实现简单,时间效率高。2、空间利用率低,可用内存缩小为原来的一半。
2.2、标记-清除算法
首先标记出所有需要回收的对象,使用可达性分析算法判断一个对象是否为可回收,在标记完成后统一回收所有被标记的对象。示例:
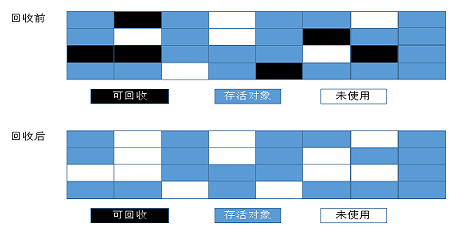
说明:1、效率问题,标记和清除两个阶段的效率都不高。2、空间问题,标记清除后会产生大量不连续的内存碎片,以后需要给大对象分配内存时,会提前触发一次垃圾回收动作。
2.3、标记-整理算法
标记过程与标记 - 清除算法一样,但之后让所有存活的对象移向一端,然后直接清理掉边界以外的内存。示例:
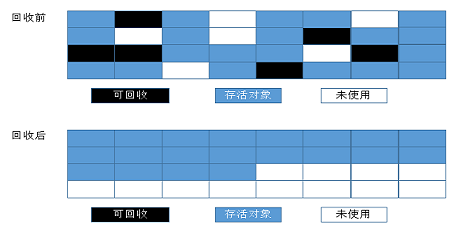
说明:适合对象存活率高的情况,如老年代中。无需考虑内存碎片问题。
2.4、分代收集算法
根据对象存活周期将堆分为新生代和老年代,然后根据各年代特点选择适当的回收算法。
- 新生代基本上对象都是朝生暮死的,生存时间很短暂,因此可采用复制算法,只需要复制少量的对象就可以完成垃圾收集。
- 老年代中的对象存活率高,也没有额外的空间进行分配担保,因此必须使用标记 - 整理或者标记 - 清除算法进行回收,只需要清除少量对象即可完成垃圾收集。
3、具体实现(以HotSpot为例)
3.1、如何确定不可达对象
3.1.1、引用计数法
(采用此法的有微软的COM计数、使用ActionScript3的FlashPlayer、Python等)
思想:
堆中的每一个对象有一个引用计数,当一个对象被创建并把指向该对象的引用赋值给一个变量时,引用计数置为1,当再把这个引用赋值给其他变量时,引用计数加1,当一个对象的引用超过了生命周期或者被设置为新值时,对象的引用计数减1,任何引用计数为0的对象都可以被当成垃圾回收。当一个对象被回收时,它所引用的任何对象计数减1,这样,其他对象也可能被当垃圾回收。
存在的问题:循环引用问题,示例如下。如果采用引用计数法,则两个实例没法被回收,但实际被回收了,说明JVM采用的不是引用计数法。
 public class ReferenceCountingGC {

     public Object instance = null;

     private static final int _1MB = 1024 * 1024;

     /**

      * 这个成员属性的唯一意义就是占点内存,以便能在GC日志中看清楚是否被回收过

      */

     private byte[] bigSize = new byte[2 * _1MB];

     public static void testGC() {

         // 定义两个对象

         ReferenceCountingGC objA = new ReferenceCountingGC();

         ReferenceCountingGC objB = new ReferenceCountingGC();

         // 给对象的成员赋值,即存在相互引用情况

         objA.instance = objB;

         objB.instance = objA;

         // 将引用设为空,即没有到堆对象的引用了

         objA = null;

         objB = null;

         // 进行垃圾回收

         System.gc();

     }

     public static void main(String[] args) {

         testGC();

     }

 }
3.1.2、可达性分析法
(采用此法的有Java、C#、Lisp等)
思想:选取一系列GCRoots对象作为起点,开始向下遍历搜索其他相关的对象,搜索所走过的路径成为引用链,遍历完成后,若一个对象到GCRoots对象没有任何引用链,则证明此对象是不可用的,可以被当做垃圾进行回收。
是什么——可作为GC Roots的对象:(其实就是引用类型的变量所引用的对象)
1、方法区中静态属性引用的对象、常量引用的对象
2、虚拟机栈(栈中的本地变量表)中引用的对象
3、本地方法栈中JNI(Native方法)引用的对象
怎么找——如何快速确定GC Roots节点,以HotSpot的为例:(其实就是确定哪些是引用类型的变量)
问题——枚举寻找出可作为GC Roots的节点耗时:可作为GCRoots的结点主要在全局性的引用(如常量或类静态属性)与执行上下文(如栈帧中的局部变量表)中,很多应用仅方法区就数百兆,逐个检查变量看是否是GC Roots很耗时。
方法(寻找GC Roots节点):采用一组称为OopMap的数据结构,在特定代码位置(安全点或安全区域)记录下哪些变量是引用类型,这样GC时(GC操作也只是用户线程处于安全点或安全区域时才进行的)利用该结构得知哪些是GC Roots从而避免逐个检查变量。
3.2、何时执行GC(GC停顿)
(何时执行 即 考虑GC线程与用户线程间的协调)
JVM采用一组称为OopMap的数据结构,在特定代码位置(安全点、安全区域)记录下哪些变量是引用类型,这样GC时(GC操作也只是用户线程处于安全点或安全区域时才进行的)利用该结构得知哪些是GC Roots从而避免逐个检查变量。
GC停顿(即用户线程停顿以让GC线程执行):每条指令都可能使引用关系发生变化,但若为每条指令生成OopMap空间成本高,因此让在特定位置生成OopMap,程序执行到这些位置时才会停顿进行GC。此特定位置包括两种:
安全点(Safe Point),面向执行着的线程,用户线程响应GC中断请求到安全点时暂停,以让垃圾收集器进行GC。安全点太少会导致用户线程等待GC的时间长,太多会频繁GC从而增大运行时负荷;其选取以“具有让程序长时间执行的特征”为标准,如方法调用、循环跳转、异常跳转等指令会产生安全点。GC时让用户线程中断有抢先式(让所有线程中断,若有线程不在安全点则恢复之以让之执行到安全点后停下)和主动式(在安全点设置标志,线程执行到安全点时检查标志看是否要中断挂起)两种。
安全区域(Safe Region),面向未在执行(如Sleep或Blocked状态)的线程,未在执行的线程(没被分配CPU时间)不会响应线程中断。安全区域是指一段代码片段之中,引用关系不会发生变化,在这个区域的任何地方开始GC都是安全的,安全区域可以看成是对安全点的扩展。当线程执行到安全区域中的代码时,首先标识自己已进入安全区域,则在这段时间里JVM发起GC时就不用管标识自己为安全区域状态的线程;在线程要离开安全区域时,它要检查系统是否已经完成了根节点枚举(或者整个GC过程),若完成,线程继续执行,否则,它必须等待直到收到可以安全离开安全区域的信号。
3.3、垃圾收集器
概述:
HotSpot目前共7种垃圾收集器,如下(图中存在连线表示可以搭配使用):

总结:
(1)
| 收集器 | 适用的代 | 采用的收集算法 | 适用的模式 | 串行、并行、并发 | 目标 |
| Serial | Young | 复制 | Client | 用户线程停止,收集线程串行 | GC时停顿时间少 |
| ParNew(Parallel New Generation) | Young | 复制 | Server | 用户线程停止,收集线程并行 | GC时停顿时间少 |
| Parallel Scavenge | Young | 复制 | 用户线程停止、收集线程并行 | 吞吐量尽可能大 | |
| CMS | Old | 标记-清除 | 用户线程和收集线程均在执行,前者不用停止 | GC时停顿时间少 | |
| Serial Old(MSC) | Old | 标记-整理 | Client、Server | 用户线程停止,收集线程串行 | GC时停顿时间少 |
| Parallel Old | Old | 标记-整理 | 用户线程停止,收集线程并行 | 吞吐量尽可能大 | |
| G1 | Young、Old | 标记-整理 | Server | 用户线程和收集线程均在执行,前者不用停止 | GC时停顿时间少 |
(2)
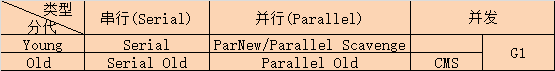
注:
- 串行/并行是说垃圾收集线程是单线程还是多线程执行(此时用户线程得停止),并发则指GC时用户线程可以并发执行不用停下。
- Parallel Scavenge和Parallel Old收集器以提高吞吐量为目标,其他收集器以减少停顿时间(单次GC所用时间)为目标。(吞吐量=运行用户代码时间 /(运行用户代码时间 + 垃圾回收时间,可见吞吐量就是用户线程执行时间的占比)。停顿时间越短越适合与用户交互的程序以提高响应速度和用户体验;而高吞吐量可高效利用CPU以尽快完成程序运算任务,适合后台运算而不需要太多交互的任务。GC停顿时间缩短通常以牺牲吞吐量和新生代空间为代价换来,因为通常会导致需要频繁GC)
- 虚拟机运行在Client 模式下时默认用 Serial + Serial Old 收集器组合,两个分别用于年轻代、老年代。
- 虚拟机运行在Server模式下时默认用 Parallel Scavenge + Serial Old收 集器组合,两个分别用于年轻代、老年代。
- 如果机器只有一个核的话,采用并行回收器可能得不偿失,因为多个回收线程会争抢CPU资源,反而造成更大的消耗,这时,就最好采用串行回收器。
下面详述:
3.3.1、Serial收集器
采用复制算法。
Serial收集器为单线程收集器,在进行垃圾收集时,必须要暂停其他所有的工作线程,直到它收集结束。运行过程如下图所示:
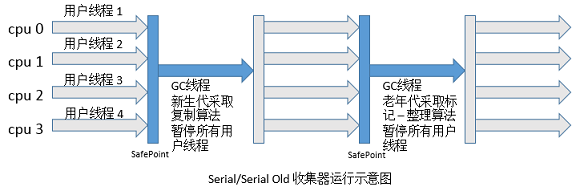
说明:
1、需要STW(Stop The World),停顿时间长。
2、简单高效,对于单个CPU环境而言,Serial收集器由于没有线程交互开销,可以获取最高的单线程收集效率。
3、虚拟机运行在Client模式下的默认年轻代收集器。
3.3.2、ParNew收集器
采用复制算法。
ParNew是Serial的多线程版本,除了使用多线程进行垃圾收集外,其他行为与Serial完全一样,运行过程如下图所示:
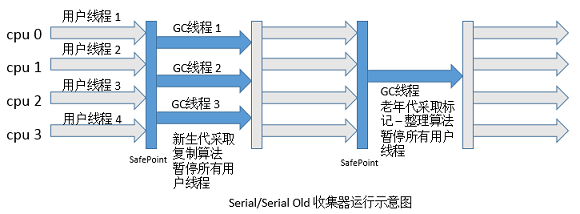
说明:虚拟机运行在Server模式下的默认新生代收集器。
3.3.3、Parallel Scavenge收集器
采用复制算法。
Parallel Scavenge收集器的目标是达到一个可控制的吞吐量,吞吐量 = 运行用户代码时间 / (运行用户代码时间 + 垃圾收集时间),高吞吐量可以高效率地利用CPU时间,尽快完成程序的运算任务,主要适合在后台运算而不需要太多交互的任务。
提供了两个精确控制吞吐量的参数:
-XX:MaxGCPauseMillis:设置最大GC停顿毫秒数,收集器尽可能保证每次回收所用时间不超过该值。GC停顿时间缩短通常以牺牲吞吐量和新生代空间换来。
-XX:GCTimeRatio:设置用户代码运行时间与最大垃圾回收时间的比例,相当于吞吐量的倒数。
提供了自适应调整策略,-XX:+UseAdaptiveSizePolicy,这样虚拟机会根据当前系统的运行情况收集性能监控信息,动态调整这些参数(新生代大小、Eden与Survivor比例、晋升老年代的对象大小阈值等)以提供最合适的停顿时间或者最大的吞吐量,这种调节方式称为GC自适应调节策略。
Parallel Scavenge的运行过程与ParNew相似。
3.3.4、Serial Old收集器
采用标记 - 整理算法。
老年代的单线程收集器,运行过程在之前的Serial收集器已经给出。不再赘述。
常作为下面介绍的CMS收集器的后备预案,在并发收集发生Concurrent Mode Failure时使用。
3.3.5、Parallel Old收集器
采用标记-整理算法。
老年代的多线程收集器,吞吐量优先,运行过程如下图所示:
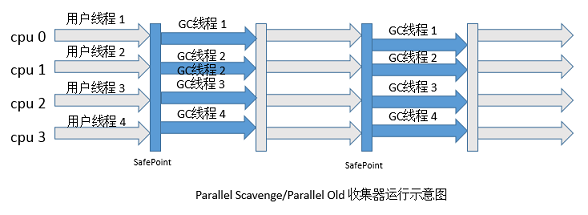
3.3.6、CMS收集器
采用标记-清除算法。
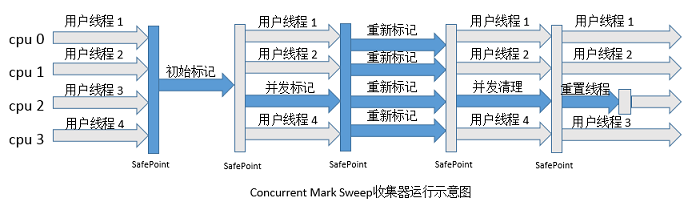
CMS(Conrrurent Mark Sweep)收集器是以获取最短回收停顿时间为目标的收集器。使用标记 - 清除算法,收集过程分为如下四步:
- 初始标记,标记GCRoots能直接关联到的对象(找到GC Roots节点),时间很短。
- 并发标记,进行GCRoots Tracing(可达性分析)过程,时间很长。
- 重新标记,修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,时间较长。
- 并发清除,回收内存空间,时间很长。
- 并发重置线程
其中,初始标记、重新标记仍需要GC停顿(Stop The World),并发标记与并发清除两个阶段耗时最长,但是可以与用户线程并发执行。运行过程如下图所示:
缺点:1:内存碎片;2:由于并发故垃圾回收线程执行时用户线程需要占用CPU、内存从而吞吐量低,并发使得无法处理浮动垃圾
1、内存碎片。由于采用的标记 - 清除算法,会产生大量的内存碎片,不利于大对象的分配,可能会提前触发一次Full GC。虚拟机提供了-XX:+UseCMSCompactAtFullCollection参数来进行碎片的合并整理过程,这样会使得停顿时间变长,虚拟机还提供了一个参数配置-XX:+CMSFullGCsBeforeCompaction,用于设置执行多少次不压缩的Full GC后,接着来一次带压缩的GC。
2、多线程并发,耗费CPU。对CPU资源非常敏感,并发阶段虽不会导致用户线程停顿但会占用一部分线程(CPU资源)从而导致应用程序变慢,总吞吐率下降。(不过总比让用户线程停顿好...)
3、因用户线程并发执行,故需要预留一部分老年代空间提供并发时用户线程运行使用,从而需要额外占用内存空间。预留内存无法满足程序需要时就会出现一次Concurrent Mode Failure,此时启动后备预案即Serial Old来收集老年代垃圾。提供了参数-XX:CMSInitialtingOccupancyFraction来设置内存占用阈值,达到阈值CMS就进行垃圾回收。
4、并发收集,无法处理浮动垃圾。因为在并发清理阶段用户线程还在运行,自然就会产生新的垃圾,而在此次收集中无法收集他们,只能留到下次收集,这部分垃圾为浮动垃圾
3.3.7、G1收集器
采用标记-整理算法。
G1(Garbage First)收集器具有如下特点:
- 并行和并发。使用多个CPU来缩短Stop The World停顿时间,与用户线程并发执行。
- 分代收集。独立管理整个堆,但是能够采用不同的方式去处理新创建对象和已经存活了一段时间、熬过多次GC的旧对象,以获取更好的收集效果。
- 空间整合。基于标记 - 整理算法,无内存碎片产生,收集后能提供规整的可用内存。
- 可预测的停顿。能建立可预测的停顿时间模型,能让使用者明确指定在一个长度为M毫秒的时间片段内,消耗在垃圾收集上的时间不得超过N毫秒。
使用G1收集器时,Java堆会被划分为多个大小相等的独立区域(Region),虽然还保留新生代和老年代的概念,但两者已经不是物理隔离了,都是一部分Region(不需要连续)的集合。G1收集器中,Region之间的对象引用以及其他收集器的新生代和老年代之间的对象引用,虚拟机都使用Remembered Set来避免全堆扫描的。每个Region对应一个Remembered Set,虚拟机发现程序在对Reference类型的数据进行写操作时,会产生一个Write Barrier暂时中断写操作,检查Reference引用的对象是否处于不同的Region之中(在分代的例子中就是检查老年代的对象是否引用了新生代的对象),如果是,则通过CardTable把相关引用信息记录到被引用对象所属的Region的Remembered Set之中,当进行内存回收时,在GC根节点的枚举范围中加入Remembered Set即可保证不对全堆扫描也不会遗漏。
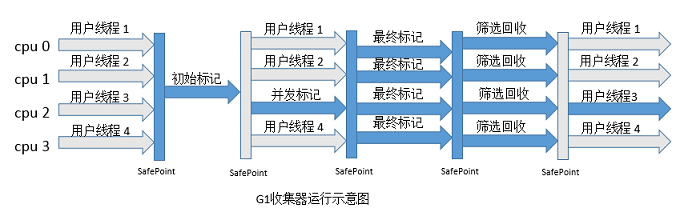
如果不计算维护Remembered Set的操作,G1收集器的运作可以分为如下几步:
- 初始并发,标记GCRoots能直接关联到的对象;修改TAMS(Next Top At Mark Start),使得下一阶段程序并发时,能够在可用的Region中创建新对象,需停顿线程,耗时很短。
- 并发标记,从GCRoots开始进行可达性分析,与用户程序并发执行,耗时很长。
- 最终标记,修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,变动的记录将被记录在Remembered Set Logs中,此阶段会把其整合到Remembered Set中,需要停顿线程,与用户程序并行执行,耗时较短。
- 筛选回收,对各个Region的回收价值和成本进行排序,根据用户期望的GC时间进行回收,与用户程序并发执行,时间用户可控。
G1收集器运行过程的前3阶段与CMS的类似,具体示意图如下:
3.4、垃圾收集器组合及配置参数
以下是虚拟机的一些非稳定运行参数,用来配置使用的收集器组合,通过 -XX:参数 配置。
(可以使用参数-XX:+PrintCommandLineFlags让JVM打印出那些已经被用户或者JVM设置过的详细的XX参数的名称和值)
|
参 数 |
描 述 |
|
UseSerialGC |
虚拟机运行在Client 模式下的默认值,打开此开关后,使用Serial + Serial Old 收集器组合进行内存回收 |
|
UseParNewGC |
打开此开关后,使用ParNew + Serial Old 收集器组合进行内存回收 |
|
UseConcMarkSweepGC |
打开此开关后,使用ParNew + CMS + Serial Old 收集器组合进行内存回收。Serial Old 收集器将作为CMS 收集器出现Concurrent Mode Failure失败后的后备收集器使用 |
|
UseParallelGC |
虚拟机运行在Server 模式下的默认值,打开此开关后,使用Parallel Scavenge + Serial Old(PS MarkSweep)的收集器组合进行内存回收 |
|
UseParallelOldGC |
打开此开关后,使用Parallel Scavenge + Parallel Old 的收集器组合进行内存回收 |
|
SurvivorRatio |
新生代中Eden 区域与Survivor 区域的容量比值, 默认为8, 代表Eden :Survivor=8∶1 |
|
PretenureSizeThreshold |
直接晋升到老年代的对象大小,设置这个参数后,大于这个参数的对象将直接在老年代分配 |
|
MaxTenuringThreshold |
晋升到老年代的对象年龄。每个对象在坚持过一次Minor GC 之后,年龄就加1,当超过这个参数值时就进入老年代 |
|
UseAdaptiveSizePolicy |
动态调整Java堆中各个区域的大小以及进入老年代的年龄 |
|
HandlePromotionFailure |
是否允许分配担保失败,即老年代的剩余空间不足以应付新生代的整个Eden 和Survivor 区的所有对象都存活的极端情况 |
|
ParallelGCThreads |
设置并行GC 时进行内存回收的线程数 |
|
GCTimeRatio |
GC 时间占总时间的比率,默认值为99,即允许1% 的GC 时间。仅在使用Parallel Scavenge 收集器时生效 |
|
MaxGCPauseMillis |
设置GC 的最大停顿时间。仅在使用Parallel Scavenge 收集器时生效 |
|
CMSInitiatingOccupancyFraction |
设置CMS 收集器在老年代空间被使用多少后触发垃圾收集。默认值为68%,仅在使用CMS 收集器时生效 |
|
UseCMSCompactAtFullCollection |
设置CMS 收集器在完成垃圾收集后是否要进行一次内存碎片整理。仅在使用CMS 收集器时生效 |
|
CMSFullGCsBeforeCompaction |
设置CMS 收集器在进行若干次垃圾收集后再启动一次内存碎片整理。仅在使用CMS 收集器时生效 |
注:Java9已默认采用G1收集器
4、其他
4.1、GC类型
MinorGC与MajorGC(FullGC)的区别:
- 新生代 GC(Minor GC):指发生在新生代的垃圾收集动作,在Eden剩余空间不足以分配新对象时触发。因为 Java 对象大多都具备朝生夕灭的特性,所以 Minor GC 非常频繁,一般回收速度也比较快。
- 老年代 GC(Major GC / Full GC):指发生在老年代的 GC,在老年代剩余空间不足以容纳新对象时触发。出现了 Major GC,经常会伴随至少一次的 Minor GC(但非绝对的,在 ParallelScavenge 收集器的收集策略里 就有直接进行 Major GC 的策略选择过程) 。MajorGC 的速度一般会比 Minor GC 慢 10 倍以上。
4.2、理解GC日志
GC日志格式与所用JVM版本及收集器有关,但有一定的共性。这里以JDK1.8.0_45为例。
打印GC日志的参数:
-XX:+PrintGCDetails

-XX:+PrintGCTimeStamps
典型GC日志示例如下:
0.080: [GC (System.gc()) [PSYoungGen: 1147K->616K(9216K)] 1147K->624K(19456K), 0.0006699 secs] [Times: user=0.00 sys=0.00, real=0.00 secs]

0.081: [Full GC (System.gc()) [PSYoungGen: 616K->0K(9216K)] [ParOldGen: 8K->508K(10240K)] 624K->508K(19456K), [Metaspace: 2555K->2555K(1056768K)], 0.0034445 secs] [Times: user=0.00 sys=0.00, real=0.00 secs]

Heap

 PSYoungGen      total 9216K, used 410K [0x00000000ff600000, 0x0000000100000000, 0x0000000100000000)

  eden space 8192K, 5% used [0x00000000ff600000,0x00000000ff666800,0x00000000ffe00000)

  from space 1024K, 0% used [0x00000000ffe00000,0x00000000ffe00000,0x00000000fff00000)

  to   space 1024K, 0% used [0x00000000fff00000,0x00000000fff00000,0x0000000100000000)

 ParOldGen       total 10240K, used 508K [0x00000000fec00000, 0x00000000ff600000, 0x00000000ff600000)

  object space 10240K, 4% used [0x00000000fec00000,0x00000000fec7f1c0,0x00000000ff600000)

 Metaspace       used 2562K, capacity 4486K, committed 4864K, reserved 1056768K

  class space    used 275K, capacity 386K, committed 512K, reserved 1048576K
由PSYoungGen和ParOldGen得知JVM的垃圾收集器组合为Parallel Scavenge(新生代) + Parallel Old(老年代)。
- 最前面的数字0.080、0.081表示GC发生的时间,为JVM启动以来经过的秒数。
- [GC (System.gc())]与[Full GC (System.gc())],表示此次垃圾收集的停顿类型,而不是用来区分新生代GC和老年代GC的,如果有Full,则表示此次GC发生了Stop The World。
- PSYoungGen: 1147K->616K(9216K),表示,“新生代区域:该内存区域GC前已使用容量 -> 该内存区域GC后已使用容量(该内存区域总容量)”。区域名称与所用收集器名称有关:若为Serial收集器则名为DefNew,Default New Generation;若为ParNew收集器则名为ParNew,Parallel New Generation;若为Parallel Scavenge收集器则名为PSYoungGenn。老年代和元空间与此类似。
- 1147K->624K(19456K),, 0.0006699 secs,表示,“GC前Java堆已使用的容量 -> GC后Java堆已使用的容量(Java堆总容量),GC所用秒数”。
- [Times: user=0.00 sys=0.00, real=0.00 secs],表示GC的更具体的时间,user代表用户态消耗的CPU时间,sys代表内核态消耗的CPU时间,real代表操作从开始到结束所经过的墙钟时间。CPU时间与墙钟时间的区别是,墙钟时间包括各种非运算的等待耗时,如等待磁盘IO,等待线程阻塞,CPU时间则不包含这些耗时。当系统有多CPU或者多核时,多线程操作会叠加这些CPU时间,所以读者看到user或者sys时间超过real时间也是很正常的。
4.3、Java程序的总运行时间 = 运行用户代码时间 + 非用户代码时间(即时编译时间 + 类加载验证时间 + 垃圾回收时间)。其中,非用户代码时间里的加载验证和即时编译一般集中在程序运行开始的一阶段,而垃圾回收则是伴随着程序运行的整个过程。
JDK提供的Visual VM工具里Visual GC中展示的即包括该三部分非用户代码时间(Compile Time、Class Loader Time、GC Time);
前面说的吞吐量即这里的 运行用户代码时间/(运行用户代码时间 + 垃圾回收时间)。
此外:
类验证可以通过 -XVerify:none 禁用;
即时编译可以通过 -Xint 禁用,从而纯以解释执行的方式执行代码。
5、参考资料
[1]《深入理解Java虚拟机——JVM高级特性与最佳实践》
[2]http://www.cnblogs.com/leesf456/p/5218594.html
JVM内存垃圾回收方法的更多相关文章
- JVM内存管理学习总结(一)
I.JVM进程的生命周期 JVM实例的生命周期和java程序的生命周期保持一致,即一个新的程序启动则产生一个新的JVM进程实例,程序结束则JVM进程实例伴随着消失.那么程序启动和程序终止就是JVM实例 ...
- jvm-垃圾回收gc简介+jvm内存模型简介
gc是jvm自动执行的,自动清除jvm内存垃圾,无须人为干涉,虽然方便了程序员的开发,但同时增加了开发人员对内存的不可控性. 1.jvm内存模型简介 jvm是在计算机系统上又虚拟出来的一个伪计算机系统 ...
- 程序猿的日常——JVM内存模型与垃圾回收
Java开发有个很基础的问题,虽然我们平时接触的不多,但是了解它却成为Java开发的必备基础--这就是JVM.在C++中我们需要手动申请内存然后释放内存,否则就会出现对象已经不再使用内存却仍被占用的情 ...
- JVM内存模型和垃圾回收
Java开发有个很基础的问题,虽然我们平时接触的不多,但是了解它却成为Java开发的必备基础——这就是JVM.在C++中我们需要手动申请内存然后释放内存,否则就会出现对象已经不再使用内存却仍被占用的情 ...
- JVM内存管理------垃圾搜集器参数精解
本文是GC相关的最后一篇,这次LZ只是罗列一下hotspot JVM中垃圾搜集器相关的重点参数,以及各个参数的解释.废话不多说,这就开始. 垃圾搜集器文章传送门 JVM内存管理------JAVA语言 ...
- Java之美[从菜鸟到高手演变]之JVM内存管理及垃圾回收
很多Java面试的时候,都会问到有关Java垃圾回收的问题,提到垃圾回收肯定要涉及到JVM内存管理机制,Java语言的执行效率一直被C.C++程序员所嘲笑,其实,事实就是这样,Java在执行效率方面确 ...
- JVM的stack和heap,JVM内存模型,垃圾回收策略,分代收集,增量收集
(转自:http://my.oschina.net/u/436879/blog/85478) 在JVM中,内存分为两个部分,Stack(栈)和Heap(堆),这里,我们从JVM的内存管理原理的角度来认 ...
- JVM内存管理和JVM垃圾回收机制
JVM内存管理和JVM垃圾回收机制(1) 这里向大家描述一下JVM学习笔记之JVM内存管理和JVM垃圾回收的概念,JVM内存结构由堆.栈.本地方法栈.方法区等部分组成,另外JVM分别对新生代和旧生代采 ...
- JVM内存管理及垃圾回收
一.JVM内存的构 Java虚拟机会将内存分为几个不同的管理区,这些区域各自有各自的用途,根据不同的特点,承担不同的任务以及在垃圾回收时运用不同的算法.总体分为下面几个部分: 程序计数器(Progra ...
随机推荐
- 介绍几种SSIS部署方式
介绍 如果你已经开发完一个不错的SSIS包并且能够在你的本地完美的运行,每个任务都亮起绿色的通过标志.这时为了能够让这个包处理能够在指定时间运行,你需要将其发布到一个服务器上,并做好相关配置.作为开发 ...
- background-attachment属性进阶
前提是定义了background-image属性,然后用background-attachment来指明背景图的位置是固定于视口的,还是随着包含块移动的.可简单理解为定义背景图片随滚动轴的移动方式. ...
- python爬虫学习(9) —— 一些工具和语法
1. Beautiful Soup 在它的官网有这样一段话: You didn't write that awful page. You're just trying to get some data ...
- IOS错误Could not produce class with ID
运行环境 Unity 5.3.5f1 (IL2CPP)编译IOS版本 XCode Version 7.2.1 (7C1002) Mac OS X 10.11.3 (15D21) (Mac mini) ...
- float4数据类型
GPU是以四维向量为基本单位来计算的.4个浮点数所组成的float4向量是GPU内置的最基本类型.使用GPU对两个float4向量进行计算,与CPU对两个整数或两个浮点数进行计算一样简单,都是只需要一 ...
- list<T> 的使用方法。
首先讲一个经常用到的Contains( )方法,用来测试一个元素是否在List内.这个功能跟SQL里面的" like % %"类似. 这个方法在数组中也存在,因为集合其实就是动态数 ...
- codevs 1490 【CTSC2008】 网络管理
题目链接:网络管理 好久没写这种类型的题了--手都生了-- 一句话题意:树上带修改的区间\(k\)大数.这题面怎么有点眼熟 显然树上的题目我们可以先在序列上考虑一下.区间带修改的区间\(k\)大数有两 ...
- C++基本数据类型总结
一.整形 1.整形有char.short.int.long.long long,这5个也默认为signed XX ; 规则:short至少16位:int至少和short一样:long至少32位,且至少 ...
- [LeetCode] Lowest Common Ancestor of a Binary Search Tree 二叉搜索树的最小共同父节点
Given a binary search tree (BST), find the lowest common ancestor (LCA) of two given nodes in the BS ...
- FPGA与simulink联合实时环路系列——实验三 按键key
实验三 按键key 实验内容 在FPGA的实验中,经常涉及到按键的使用,按键是必不可少的人机交互的器件之一,在这些实验中,有时将按键的键值读取显示到数码管.LCD或者是通过串口传送到PC的串口助手上进 ...