
转:大数据架构:flume-ng+Kafka+Storm+HDFS 实时系统组合
虽然比较久,但是这套架构已经很成熟了,记录一下
一般数据流向,从“数据采集--数据接入--流失计算--数据输出/存储”
<ignore_js_op>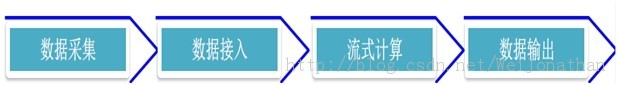
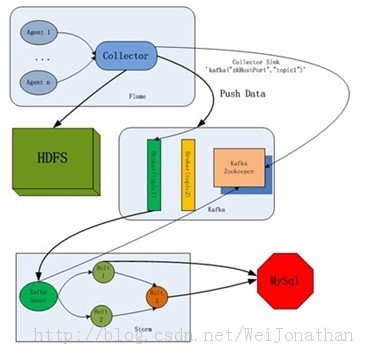
Flume的数据接受方,可以是console(控制台)、text(文件)、dfs(HDFS文件)、RPC(Thrift-RPC)和syslogTCP(TCP syslog日志系统)等。在我们系统中由kafka来接收。
- $tar zxvf apache-flume-1.4.0-bin.tar.gz/usr/local
复制代码
Flume启动命令:
- $bin/flume-ng agent --conf conf --conf-file conf/flume-conf.properties --name producer -Dflume.root.logger=INFO,console
复制代码
Kafka
- 通过O(1)的磁盘数据结构提供消息的持久化,这种结构对于即使数以TB的消息存储也能够保持长时间的稳定性能。
- 高吞吐量:即使是非常普通的硬件kafka也可以支持每秒数十万的消息。
- 支持通过kafka服务器和消费机集群来分区消息。
- 支持Hadoop并行数据加载。
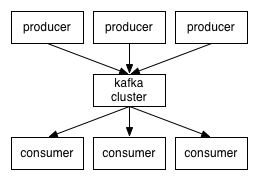
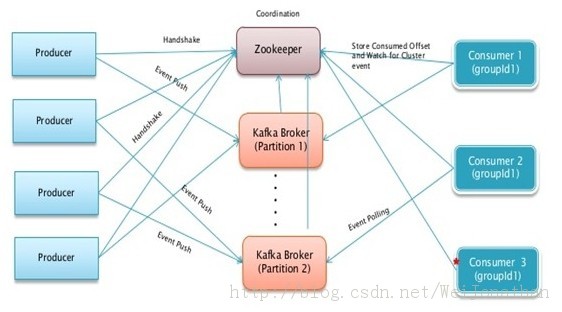
- > tar xzf kafka-<VERSION>.tgz
- > cd kafka-<VERSION>
- > ./sbt update
- > ./sbt package
- > ./sbt assembly-package-dependency
复制代码
- > bin/zookeeper-server-start.shconfig/zookeeper.properties
- > bin/kafka-server-start.shconfig/server.properties
复制代码
这里是官网上的教程,kafka本身有内置zookeeper,但是我自己在实际部署中是使用单独的zookeeper集群,所以第一行命令我就没执行,这里只是些出来给大家看下。
- zookeeper.connect=nutch1:2181
复制代码
(2)Create a topic
- > bin/kafka-create-topic.sh --zookeeper localhost:2181 --replica 1 --partition 1 --topic test
- > bin/kafka-list-topic.sh --zookeeperlocalhost:2181
复制代码
(3)Send some messages
- > bin/kafka-console-producer.sh--broker-list localhost:9092 --topic test
复制代码
(4)Start a consumer
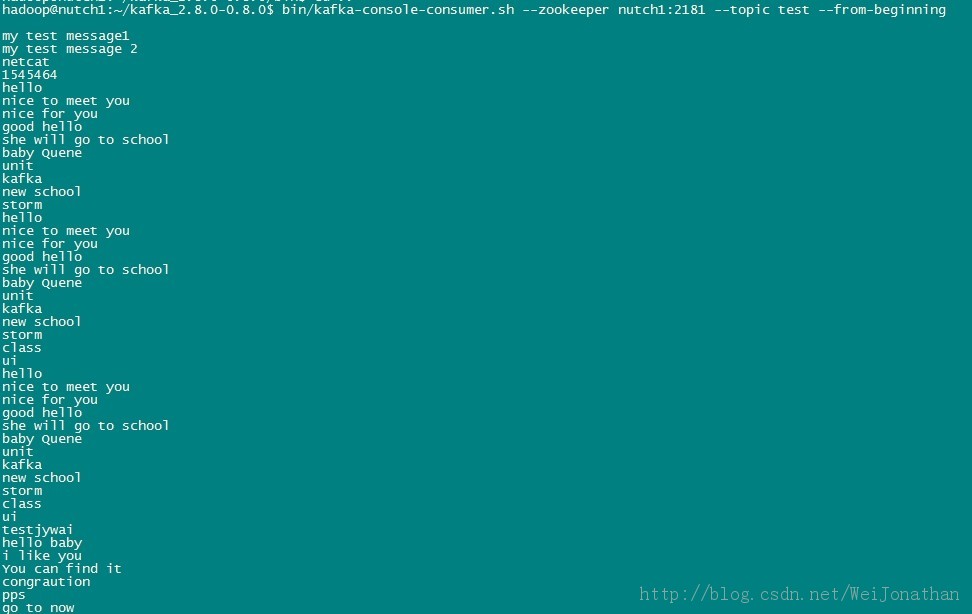
- > bin/kafka-console-consumer.sh--zookeeper localhost:2181 --topic test --from-beginning
复制代码
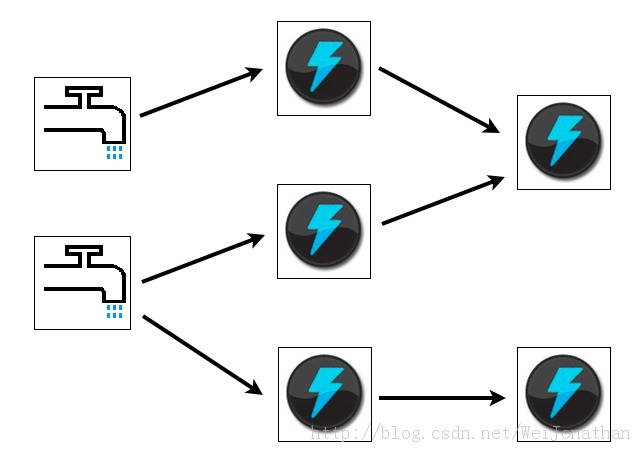
- 简单的编程模型。类似于MapReduce降低了并行批处理复杂性,Storm降低了进行实时处理的复杂性。
- 可以使用各种编程语言。你可以在Storm之上使用各种编程语言。默认支持Clojure、Java、Ruby和Python。要增加对其他语言的支持,只需实现一个简单的Storm通信协议即可。
- 容错性。Storm会管理工作进程和节点的故障。
- 水平扩展。计算是在多个线程、进程和服务器之间并行进行的。
- 可靠的消息处理。Storm保证每个消息至少能得到一次完整处理。任务失败时,它会负责从消息源重试消息。
- 快速。系统的设计保证了消息能得到快速的处理,使用ØMQ作为其底层消息队列。(0.9.0.1版本支持ØMQ和netty两种模式)
- 本地模式。Storm有一个“本地模式”,可以在处理过程中完全模拟Storm集群。这让你可以快速进行开发和单元测试。
producer.sources.s.command = tail -f -n+1 /mnt/hgfs/vmshare/test.log
producer.sources.s.channels = c


- #2个channel和2个sink的配置文件 这里我们可以设置两个sink,一个是kafka的,一个是hdfs的;
- a1.sources = r1
- a1.sinks = k1 k2
- a1.channels = c1 c2
复制代码
具体配置大伙根据自己的需求去设置,这里就不具体举例了
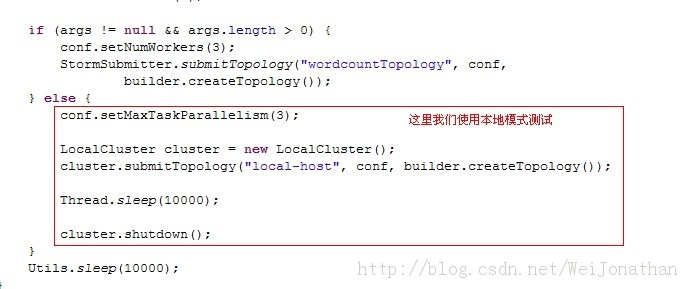
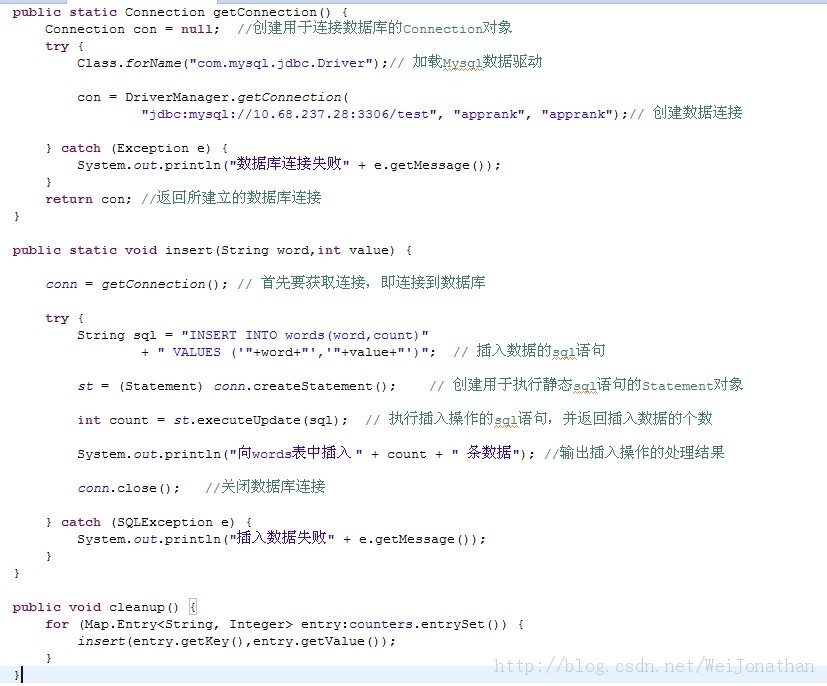
- storm-0.9.0.1/bin/storm jar storm-start-demo-0.0.1-SNAPSHOT.jar com.storm.topology.MyTopology
复制代码
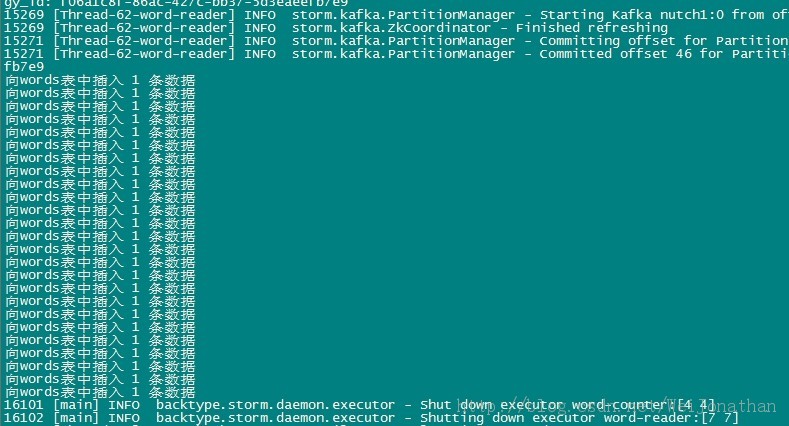
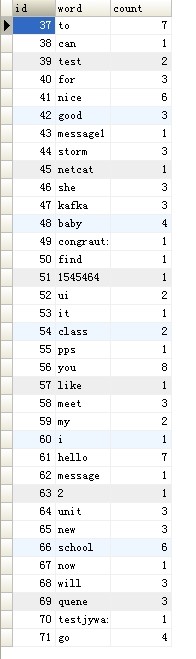
到这里我们的整个整合就完成了!
转:大数据架构:flume-ng+Kafka+Storm+HDFS 实时系统组合的更多相关文章
- 大数据架构:flume-ng+Kafka+Storm+HDFS 实时系统组合
http://www.aboutyun.com/thread-6855-1-1.html 个人观点:大数据我们都知道hadoop,但并不都是hadoop.我们该如何构建大数据库项目.对于离线处理,ha ...
- flume-ng+Kafka+Storm+HDFS 实时系统组合
http://www.aboutyun.com/thread-6855-1-1.html
- flume-ng+Kafka+Storm+HDFS 实时系统搭建
转自:http://www.tuicool.com/articles/mMrQnu7 一 直以来都想接触Storm实时计算这块的东西,最近在群里看到上海一哥们罗宝写的Flume+Kafka+Storm ...
- [转]flume-ng+Kafka+Storm+HDFS 实时系统搭建
http://blog.csdn.net/weijonathan/article/details/18301321 一直以来都想接触Storm实时计算这块的东西,最近在群里看到上海一哥们罗宝写的Flu ...
- 大数据架构师基础:hadoop家族,Cloudera产品系列等各种技术
大数据我们都知道hadoop,可是还会各种各样的技术进入我们的视野:Spark,Storm,impala,让我们都反映不过来.为了能够更好的架构大数据项目,这里整理一下,供技术人员,项目经理,架构师选 ...
- 大数据入门第十八天——kafka整合flume、storm
一.实时业务指标分析 1.业务 业务: 订单系统---->MQ---->Kakfa--->Storm 数据:订单编号.订单时间.支付编号.支付时间.商品编号.商家名称.商品价格.优惠 ...
- 大数据学习——kafka+storm+hdfs整合
1 需求 kafka,storm,hdfs整合是流式数据常用的一套框架组合,现在 根据需求使用代码实现该需求 需求:应用所学技术实现,kafka接收随机句子,对接到storm中:使用storm集群统计 ...
- 后Hadoop时代的大数据架构(转)
原文:http://zhuanlan.zhihu.com/donglaoshi/19962491 作者: 董飞 提到大数据分析平台,不得不说Hadoop系统,Hadoop到现在也超过10年 ...
- 后Hadoop时代的大数据架构
提到大数据分析平台,不得不说Hadoop系统,Hadoop到现在也超过10年的历史了,很多东西发生了变化,版本也从0.x进化到目前的2.6版本.我把2012年后定义成后Hadoop平台时代,这不是说不 ...
随机推荐
- python全栈开发从入门到放弃之网络基础
一.操作系统基础 操作系统:(Operating System,简称OS)是管理和控制计算机硬件与软件资源的计算机程序,是直接运行在“裸机”上的最基本的系统软件,任何其他软件都必须在操作系统的支持下才 ...
- springboot的Scheduled定时器不工作
问题情况 使用springboot,使用注解方式启动定时器进行业务调度. 在入口类中加了注解如下: package org.test.xyz; @SpringBootApplication @Enab ...
- 解决Can't connect to local MySQL server through socket '/tmp/mysql.sock'
0 Problem 电脑重启后用python的MySQLdb连接数据库报错 Can't connect to local MySQL server through socket '/tmp/mysql ...
- Tomcat 源码分析(转)
本文转自:http://blog.csdn.net/haitao111313/article/category/1179996 Tomcat源码分析(一)--服务启动 1. Tomcat主要有两个组件 ...
- sublime Text emmet插件使用手册
转自:http://www.w3cplus.com/tools/emmet-cheat-sheet.html 介绍 Emmet (前身为 Zen Coding) 是一个能大幅度提高前端开发效率的一个工 ...
- docker安装部署PHP nginx
sudo tee /etc/yum.repos.d/docker.repo <<-'EOF' [dockerrepo] name=Docker Repository baseurl=htt ...
- shell中的调试与计算
shell 计算 2.正确方法 1)使用let var=1 let "var+=1" echo $var 输出结果为2,这次没有悲剧 注意: a)经我 ...
- rest_framework解析器组件源码流程
rest_framework解析器组件源码流程 解析器顾名思义就是对请求体进行解析.为什么要有解析器?原因很简单,当后台和前端进行交互的时候数据类型不一定都是表单数据或者json,当然也有其他类型的数 ...
- Python3.x:ConfigParser模块的使用
Python3.x:ConfigParser模块的使用 简介 ConfigParser模块在python中是用来读取配置文件,配置文件的格式跟windows下的ini配置文件相似,可以包含一个或多个节 ...
- HTML5侧滑聊天面板
在线演示 本地下载