
seg:NLP之正向最大匹配分词
已迁移到我新博客,阅读体验更佳seg:NLP之正向最大匹配分词
完整代码实现放在我的github上:click me
一、任务要求
- 实现一个基于词典与规则的汉语自动分词系统。
二、技术路线
采用正向最大匹配(FMM)方法对输入的中文语句进行分词,具体的实现可以分为下面几个步骤:
- 对输入的一个中文语句,首先在程序中判断并确保语句中不包含数字或者字母
- 在句子中的当前位置开始取与词典dic_ce.txt中最大匹配长度的词作为一个分词段,如果没有在词典中成功匹配到就将句子在当前匹配位置的这个字作为一个分词段并将匹配位置向前挪一个位置
- 重复第2步直到匹配位置移到句末
下面是用FMM方法分词的具体实现:
//param@seg:保存分词段结果的vector

//param@st:带分词的中文语句

void segment(vector<string> &seg, string st) {

    int pos = 0;

    int sz = st.length();

    string t;

    int cnt = 0, spos;

    while (pos < sz) {

        cnt = pos;

        spos = pos;

        t = "";

        while (st[cnt]) {

            t += st.substr(cnt, 2);

            if (wordmap.find(t) != wordmap.end())

                pos = cnt + 2;

            cnt += 2;

        }

        if (pos == spos) {

            seg.push_back(st.substr(spos, 2));

            pos += 2;

        }else {

            seg.push_back(st.substr(spos, pos - spos));

        }

    }

    return;

}
三、数据说明
- 汉英词典dic_ce.txt,读取其中的汉词用于与句中词进行匹配,词典采用GBK编码,下面是给出文件内容示例:
//gbk编码,每行第一个词是汉词,后面是它对应的英译单词,以','分隔

阿弥陀佛,Amitabha

阿米巴,amoeba,amoebae

阿姆斯特丹,Amsterdam

阿斯匹林,aspirin
四、性能分析
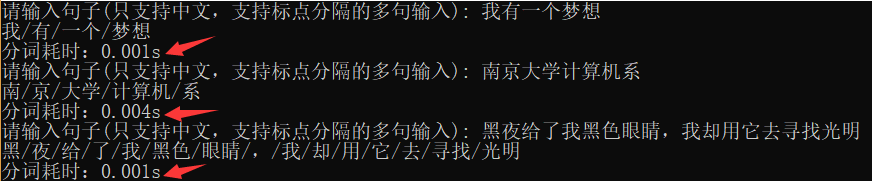
- 假设输入中文语句长度为n,程序时间复杂度最坏情况下是O(n^2),最好情况是O(n),下面是程序分析结果及分词耗时评测的截图:
五、运行环境
- 将执行文件seg.exe与数据字典dic_ce.txt放在同一个目录下,然后点击seg.exe即可正常运行,进入运行窗口后根据提示进行输入即可得到分词结果。
seg:NLP之正向最大匹配分词的更多相关文章
- Python学习实践------正向最大匹配中文分词
正向最大匹配分词: 1.加载词典文件到集合中,取词典文件中最大长度词的length 2.每次先在句子中按最大长度分割,然后判断分割的词是否存在字典中,存在则记录此词,调整起始点. 3.不存在则按最大长 ...
- 【nlp】中文分词基础原则及正向最大匹配法、逆向最大匹配法、双向最大匹配法的分析
分词算法设计中的几个基本原则: 1.颗粒度越大越好:用于进行语义分析的文本分词,要求分词结果的颗粒度越大,即单词的字数越多,所能表示的含义越确切,如:“公安局长”可以分为“公安 局长”.“公安局 长” ...
- NLP舞动之中文分词浅析(一)
一.简介 针对现有中文分词在垂直领域应用时,存在准确率不高的问题,本文对其进行了简要分析,对中文分词面临的分词歧义及未登录词等难点进行了介绍,最后对当前中文分词实现的算法原理(基于词表. ...
- NLP自然语言处理中英文分词工具集锦与基本使用介绍
一.中文分词工具 (1)Jieba (2)snowNLP分词工具 (3)thulac分词工具 (4)pynlpir 分词工具 (5)StanfordCoreNLP分词工具 1.from stanfor ...
- 哈工大 NLP 实验一 汉语分词系统
NLP实验代码可见github:NLP实验代码整理 本实验会查重,而且写起来难度比较大,建议早一些开始.实验报告要用顶会论文形式呈现,建议使用overleaf里的ACL论文latex模板比较方便一点.
- 逆向最大匹配分词算法C#
逆向顺序 句子:大家好我叫XX我是一名程序员 程序员 -> 序员 -> 员 名程序 -> 程序 -> 序 一名程 -> 名程 -> 程 是一名 -> 一名 - ...
- 分词,复旦nlp,NLPIR汉语分词系统
http://www.nlpir.org/ http://blog.csdn.net/zhyh1986/article/details/9167593
- 深度学习将会变革NLP中的中文分词——TODO 待好好细看
见:https://www.leiphone.com/news/201608/IWvc75oJglAIsDvJ.html TODO 待好好细看
- 11大Java开源中文分词器的使用方法和分词效果对比,当前几个主要的Lucene中文分词器的比较
本文的目标有两个: 1.学会使用11大Java开源中文分词器 2.对比分析11大Java开源中文分词器的分词效果 本文给出了11大Java开源中文分词的使用方法以及分词结果对比代码,至于效果哪个好,那 ...
随机推荐
- Go 延迟函数 defer 详解
Go 延迟函数 defer 详解 Go 语言中延迟函数 defer 充当着 try...catch 的重任,使用起来也非常简便,然而在实际应用中,很多 gopher 并没有真正搞明白 defer.re ...
- Django rest_framework快速入门
一.什么是REST 面向资源是REST最明显的特征,资源是一种看待服务器的方式,将服务器看作是由很多离散的资源组成.每个资源是服务器上一个可命名的抽象概念.因为资源是一个抽象的概念,所以它不仅仅能代表 ...
- 【Richard 的刷(水)题记录】
大概想了想,还是有个记录比较好. 9/24 网络流一日游: 最大流:bzoj1711[Usaco2007 Open]Dining 拆点 BZOJ 3993 Sdoi2015 星际战争 二分 P.S.这 ...
- loj6271「长乐集训 2017 Day10」生成树求和 加强版
又是一个矩阵树套多项式的好题. 这里我们可以对每一位单独做矩阵树,但是矩阵树求的是边权积的和,而这里我们是要求加法,于是我们i将加法转化为多项式的乘法,其实这里相当于一个生成函数?之后如果我们暴力做的 ...
- BZOJ_5301_[Cqoi2018]异或序列&&CF617E_莫队
Description 已知一个长度为 n 的整数数列 a[1],a[2],…,a[n] ,给定查询参数 l.r ,问在 [l,r] 区间内,有多少连续子 序列满足异或和等于 k . 也就是说,对于所 ...
- BZOJ1467_Pku3243 clever Y_EXBSGS
BZOJ1467_Pku3243 clever Y_EXBSGS Description 小Y发现,数学中有一个很有趣的式子: X^Y mod Z = K 给出X.Y.Z,我们都知道如何很快的计算K. ...
- HttpServletRequest 接口、HttpServletResponse 接口、请求转发与重定向
上篇文章我们讲了servlet的基本原理,这章将讲一下剩余的部分. HttpServletRequest 接口 该接口是 ServletRequest 接口的子接口,封装了 HTTP 请求的相关信息, ...
- Kubernetes的DaemonSet(下篇)
用Daemon Pod来进行通信 使用Pod来再DaemonSet中通信的手段有: 推的方式:在DaemonSet中的Pod会被配置成发送更新到如状态数据库这样的服务.这些都没有客户端. IP+端口方 ...
- 前端笔记之ES678&Webpack&Babel(中)对象|字符串|数组的扩展&函数新特性&类
一.对象的扩展 1.1对象属性名表达式 ES6可以在JSON中使用[]包裹一个key的名字.此时这个key将用表达式作为属性名(被当做变量求值),这个key值必须是字符串. var a = 'name ...
- 使用JavaScript和D3.js实现数据可视化
欢迎大家前往腾讯云+社区,获取更多腾讯海量技术实践干货哦~ 本文由独木桥先生发表于云+社区专栏 介绍 D3.js是一个JavaScript库.它的全称是Data-Driven Documents(数据 ...